SYSTEM
执行引擎
src/content/notes/system/执行引擎.md 执行引擎
基本介绍
执行引擎:Java 虚拟机的核心组成部分之一,类加载主要任务是负责装载字节码到其内部,但字节码并不能够直接运行在操作系统之上,需要执行引擎将字节码指令解释/编译为对应平台上的本地机器指令,进行执行
虚拟机是一个相对于物理机的概念,这两种机器都有代码执行能力:
- 物理机的执行引擎是直接建立在处理器、缓存、指令集和操作系统层面上
- 虚拟机的执行引擎是由软件自行实现的,可以不受物理条件制约地定制指令集与执行引擎的结构体系
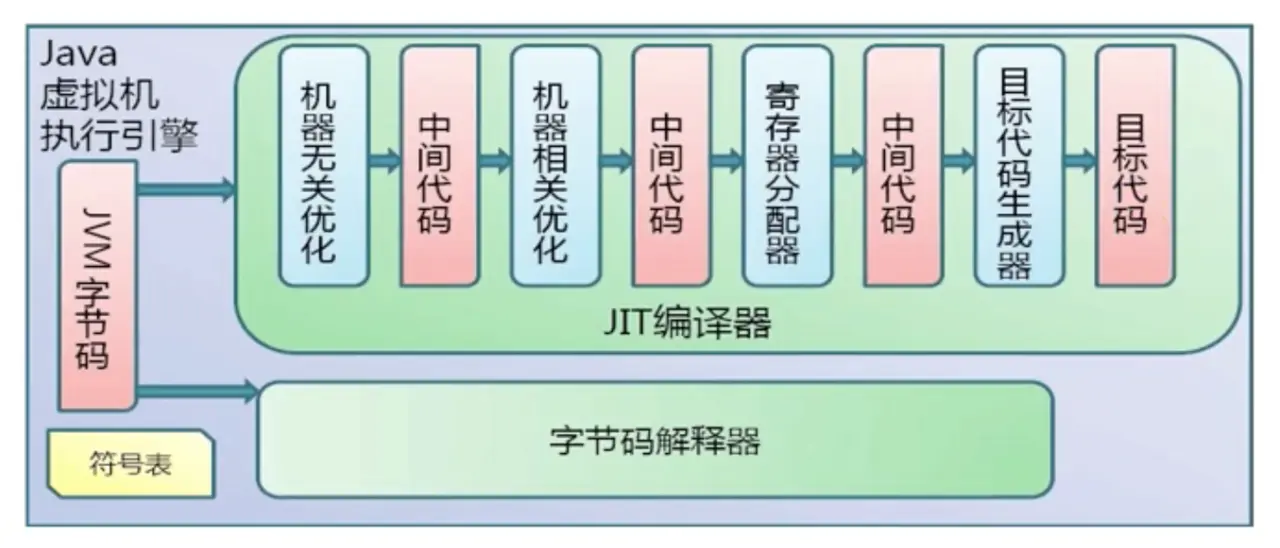
Java 是半编译半解释型语言,将解释执行与编译执行二者结合起来进行:
- 解释器:根据预定义的规范对字节码采用逐行解释的方式执行,将每条字节码文件中的内容翻译为对应平台的本地机器指令执行
- 即时编译器(JIT : Just In Time Compiler):虚拟机运行时将源代码直接编译成和本地机器平台相关的机器码后再执行,并存入 Code Cache,下次遇到相同的代码直接执行,效率高
执行方式
HotSpot VM 采用解释器与即时编译器并存的架构,解释器和即时编译器能够相互协作,去选择最合适的方式来权衡编译本地代码和直接解释执行代码的时间
HostSpot JVM 的默认执行方式:
- 当程序启动后,解释器可以马上发挥作用立即执行,省去编译器编译的时间(解释器存在的必要性)
- 随着程序运行时间的推移,即时编译器逐渐发挥作用,根据热点探测功能,将有价值的字节码编译为本地机器指令,以换取更高的程序执行效率
HotSpot VM 可以通过 VM 参数设置程序执行方式:
- -Xint:完全采用解释器模式执行程序
- -Xcomp:完全采用即时编译器模式执行程序。如果即时编译出现问题,解释器会介入执行
- -Xmixed:采用解释器 + 即时编译器的混合模式共同执行程序
热点探测
热点代码:被 JIT 编译器编译的字节码,根据代码被调用执行的频率而定,一个被多次调用的方法或者一个循环次数较多的循环体都可以被称之为热点代码
热点探测:JIT 编译器在运行时会针热点代码做出深度优化,将其直接编译为对应平台的本地机器指令进行缓存,以提升程序执行性能
JIT 编译在默认情况是异步进行的,当触发某方法或某代码块的优化时,先将其放入编译队列,然后由编译线程进行编译,编译之后的代码放在 CodeCache 中,通过 -XX:-BackgroundCompilation 参数可以关闭异步编译
- CodeCache 用于缓存编译后的机器码、动态生成的代码和本地方法代码 JNI
- 如果 CodeCache 区域被占满,编译器被停用,字节码将不会编译为机器码,应用程序继续运行,但运行性能会降低很多
HotSpot VM 采用的热点探测方式是基于计数器的热点探测,为每一个方法都建立 2 个不同类型的计数器:方法调用计数器(Invocation Counter)和回边计数器(BackEdge Counter)
-
方法调用计数器:用于统计方法被调用的次数,默认阈值在 Client 模式 下是 1500 次,在 Server 模式下是 10000 次(需要进行激进的优化),超过这个阈值,就会触发 JIT 编译,阈值可以通过虚拟机参数
-XX:CompileThreshold设置工作流程:当一个方法被调用时, 会先检查该方法是否存在被 JIT 编译过的版本,存在则使用编译后的本地代码来执行;如果不存在则将此方法的调用计数器值加 1,然后判断方法调用计数器与回边计数器值之和是否超过方法调用计数器的阈值,如果超过阈值会向即时编译器提交一个该方法的代码编译请求
-
回边计数器:统计一个方法中循环体代码执行的次数,在字节码中控制流向后跳转的指令称为回边
如果一个方法中的循环体需要执行多次,可以优化为为栈上替换,简称 OSR (On StackReplacement) 编译,OSR 替换循环代码体的入口,C1、C2 替换的是方法调用的入口,OSR 编译后会出现方法的整段代码被编译了,但是只有循环体部分才执行编译后的机器码,其他部分仍是解释执行
分层编译
HotSpot VM 内嵌两个 JIT 编译器,分别为 Client Compiler 和 Server Compiler,简称 C1 编译器和 C2 编译器
C1 编译器会对字节码进行简单可靠的优化,耗时短,以达到更快的编译速度,C1 编译器的优化方法:
-
方法内联:将调用的函数代码编译到调用点处,这样可以减少栈帧的生成,减少参数传递以及跳转过程
方法内联能够消除方法调用的固定开销,任何方法除非被内联,否则调用都会有固定开销,来源于保存程序在该方法中的执行位置,以及新建、压入和弹出新方法所使用的栈帧。
private static int square(final int i) { return i * i; } System.out.println(square(9));square 是热点方法,会进行内联,把方法内代码拷贝粘贴到调用者的位置:
System.out.println(9 * 9);还能够进行常量折叠(constant folding)的优化:
System.out.println(81); -
冗余消除:根据运行时状况进行代码折叠或削除
-
内联缓存:是一种加快动态绑定的优化技术(方法调用部分详解)
C2 编译器进行耗时较长的优化以及激进优化,优化的代码执行效率更高,当激进优化的假设不成立时,再退回使用 C1 编译,这也是使用分层编译的原因
C2 的优化主要是在全局层面,逃逸分析是优化的基础:标量替换、栈上分配、同步消除
VM 参数设置:
- -client:指定 Java 虚拟机运行在 Client 模式下,并使用 C1 编译器
- -server:指定 Java 虚拟机运行在 Server 模式下,并使用 C2 编译器
-server -XX:+TieredCompilation:在 1.8 之前,分层编译默认是关闭的,可以添加该参数开启
分层编译策略 (Tiered Compilation):程序解释执行可以触发 C1 编译,将字节码编译成机器码,加上性能监控,C2 编译会根据性能监控信息进行激进优化,JVM 将执行状态分成了 5 个层次:
-
0 层,解释执行(Interpreter)
-
1 层,使用 C1 即时编译器编译执行(不带 profiling)
-
2 层,使用 C1 即时编译器编译执行(带基本的 profiling)
-
3 层,使用 C1 即时编译器编译执行(带完全的 profiling)
-
4 层,使用 C2 即时编译器编译执行(C1 和 C2 协作运行)
说明:profiling 是指在运行过程中收集一些程序执行状态的数据,例如方法的调用次数,循环的回边次数等
参考文章:https://www.jianshu.com/p/20bd2e9b1f03