SYSTEM
位图
src/content/notes/system/位图.md 位图
基本介绍
布隆过滤器:一种数据结构,是一个很长的二进制向量(位数组)和一系列随机映射函数(哈希函数),既然是二进制,每个空间存放的不是 0 就是 1,但是初始默认值都是 0,所以布隆过滤器不存数据只存状态
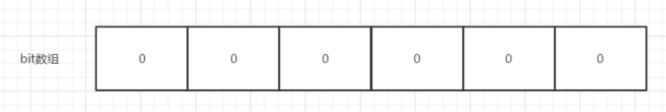
这种数据结构是高效且性能很好的,但缺点是具有一定的错误识别率和删除难度。并且理论情况下,添加到集合中的元素越多,误报的可能性就越大
工作流程
向布隆过滤器中添加一个元素 key 时,会通过多个 hash 函数得到多个哈希值,在位数组中把对应下标的值置为 1
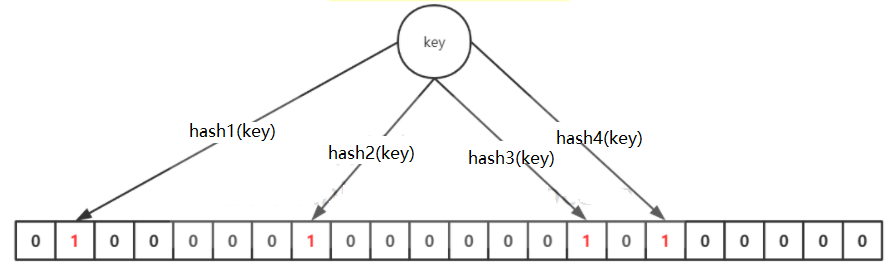
布隆过滤器查询一个数据,是否在二进制的集合中,查询过程如下:
- 通过 K 个哈希函数计算该数据,对应计算出的 K 个 hash 值
- 通过 hash 值找到对应的二进制的数组下标
- 判断方法:如果存在一处位置的二进制数据是 0,那么该数据一定不存在。如果都是 1,则认为数据存在集合中(会误判)
布隆过滤器优缺点:
-
优点:
- 二进制组成的数组,占用内存极少,并且插入和查询速度都足够快
- 去重方便:当字符串第一次存储时对应的位数组下标设置为 1,当第二次存储相同字符串时,因为对应位置已设置为 1,所以很容易知道此值已经存在
-
缺点:
- 随着数据的增加,误判率会增加:添加数据是通过计算数据的 hash 值,不同的字符串可能哈希出来的位置相同,导致无法确定到底是哪个数据存在,这种情况可以适当增加位数组大小或者调整哈希函数
- 无法删除数据:可能存在几个数据占据相同的位置,所以删除一位会导致很多数据失效
-
总结:布隆过滤器判断某个元素存在,小概率会误判。如果判断某个元素不在,那这个元素一定不在
参考文章:https://www.cnblogs.com/ysocean/p/12594982.html
Guava
引入 Guava 的依赖:
<dependency>
<groupId>com.google.guava</groupId>
<artifactId>guava</artifactId>
<version>28.0-jre</version>
</dependency>指定误判率为(0.01):
public static void main(String[] args) {
// 创建布隆过滤器对象
BloomFilter<Integer> filter = BloomFilter.create(
Funnels.integerFunnel(),
1500,
0.01);
// 判断指定元素是否存在
System.out.println(filter.mightContain(1));
System.out.println(filter.mightContain(2));
// 将元素添加进布隆过滤器
filter.put(1);
filter.put(2);
System.out.println(filter.mightContain(1));
System.out.println(filter.mightContain(2));
}实现布隆
class MyBloomFilter {
//布隆过滤器容量
private static final int DEFAULT_SIZE = 2 << 28;
//bit数组,用来存放key
private static BitSet bitSet = new BitSet(DEFAULT_SIZE);
//后面hash函数会用到,用来生成不同的hash值,随意设置
private static final int[] ints = {1, 6, 16, 38, 58, 68};
//add方法,计算出key的hash值,并将对应下标置为true
public void add(Object key) {
Arrays.stream(ints).forEach(i -> bitSet.set(hash(key, i)));
}
//判断key是否存在,true不一定说明key存在,但是false一定说明不存在
public boolean isContain(Object key) {
boolean result = true;
for (int i : ints) {
//短路与,只要有一个bit位为false,则返回false
result = result && bitSet.get(hash(key, i));
}
return result;
}
//hash函数,借鉴了hashmap的扰动算法
private int hash(Object key, int i) {
int h;
return key == null ? 0 : (i * (DEFAULT_SIZE - 1) & ((h = key.hashCode()) ^ (h >>> 16)));
}
}