SYSTEM
Map
src/content/notes/system/Map.md Map
概述
Collection 是单值集合体系,Map集合是一种双列集合,每个元素包含两个值。
Map集合的每个元素的格式:key=value(键值对元素),Map集合也被称为键值对集合
Map集合的完整格式:{key1=value1, key2=value2, key3=value3, ...}
Map集合的体系:
Map<K , V>(接口,Map集合的祖宗类)
/ \
TreeMap<K , V> HashMap<K , V>(实现类,经典的,用的最多)
\
LinkedHashMap<K, V>(实现类)Map 集合的特点:
- Map 集合的特点都是由键决定的
- Map 集合的键是无序,不重复的,无索引的(Set)
- Map 集合的值无要求(List)
- Map 集合的键值对都可以为 null
- Map 集合后面重复的键对应元素会覆盖前面的元素
HashMap:元素按照键是无序,不重复,无索引,值不做要求
LinkedHashMap:元素按照键是有序,不重复,无索引,值不做要求
常用API
Map 集合的常用 API
public V put(K key, V value):把指定的键与值添加到 Map 集合中,重复的键会覆盖前面的值元素public V remove(Object key):把指定的键对应的键值对元素在集合中删除,返回被删除元素的值public V get(Object key):根据指定的键,在 Map 集合中获取对应的值public Set<K> keySet():获取 Map 集合中所有的键,存储到 Set 集合中public Collection<V> values():获取全部值的集合,存储到 Collection 集合public Set<Map.Entry<K,V>> entrySet():获取Map集合中所有的键值对对象的集合public boolean containsKey(Object key):判断该集合中是否有此键
public class MapDemo {
public static void main(String[] args) {
Map<String , Integer> maps = new HashMap<>();
maps.put(.....);
System.out.println(maps.isEmpty());//false
Integer value = maps.get("....");//返回键值对象
Set<String> keys = maps.keySet();//获取Map集合中所有的键,
//Map集合的键是无序不重复的,所以返回的是一个Set集合
Collection<Integer> values = maps.values();
//Map集合的值是不做要求的,可能重复,所以值要用Collection集合接收!
}
}遍历方式
Map集合的遍历方式有:3种。
- “键找值”的方式遍历:先获取 Map 集合全部的键,再根据遍历键找值。
- “键值对”的方式遍历:难度较大,采用增强 for 或者迭代器
- JDK 1.8 开始之后的新技术:foreach,采用 Lambda 表达式
集合可以直接输出内容,因为底层重写了 toString() 方法
public static void main(String[] args){
Map<String , Integer> maps = new HashMap<>();
//(1)键找值
Set<String> keys = maps.keySet();
for(String key : keys) {
System.out.println(key + "=" + maps.get(key));
}
//Iterator<String> iterator = hm.keySet().iterator();
//(2)键值对
//(2.1)普通方式
Set<Map.Entry<String,Integer>> entries = maps.entrySet();
for (Map.Entry<String, Integer> entry : entries) {
System.out.println(entry.getKey() + "=>" + entry.getValue());
}
//(2.2)迭代器方式
Iterator<Map.Entry<String, Integer>> iterator = maps.entrySet().iterator();
while (iterator.hasNext()) {
Map.Entry<String, Integer> entry = iterator.next();
System.out.println(entry.getKey() + "=" + entry.getValue());
}
//(3) Lamda
maps.forEach((k,v) -> {
System.out.println(k + "==>" + v);
})
}HashMap
基本介绍
HashMap 基于哈希表的 Map 接口实现,是以 key-value 存储形式存在,主要用来存放键值对
特点:
- HashMap 的实现不是同步的,这意味着它不是线程安全的
- key 是唯一不重复的,底层的哈希表结构,依赖 hashCode 方法和 equals 方法保证键的唯一
- key、value 都可以为null,但是 key 位置只能是一个null
- HashMap 中的映射不是有序的,即存取是无序的
- key 要存储的是自定义对象,需要重写 hashCode 和 equals 方法,防止出现地址不同内容相同的 key
JDK7 对比 JDK8:
- 7 = 数组 + 链表,8 = 数组 + 链表 + 红黑树
- 7 中是头插法,多线程容易造成环,8 中是尾插法
- 7 的扩容是全部数据重新定位,8 中是位置不变或者当前位置 + 旧 size 大小来实现
- 7 是先判断是否要扩容再插入,8 中是先插入再看是否要扩容
底层数据结构:
-
哈希表(Hash table,也叫散列表),根据关键码值而直接访问的数据结构。通过把关键码值映射到表中一个位置来访问记录,以加快查找的速度,这个映射函数叫做散列函数,存放记录的数组叫做散列表
-
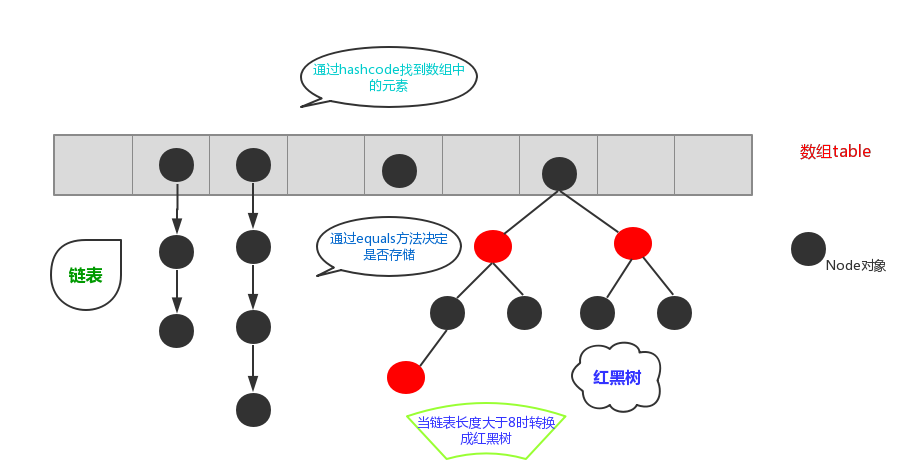
JDK1.8 之前 HashMap 由数组+链表组成
- 数组是 HashMap 的主体
- 链表则是为了解决哈希冲突而存在的(拉链法解决冲突),拉链法就是头插法,两个对象调用的 hashCode 方法计算的哈希码值(键的哈希)一致导致计算的数组索引值相同
-
JDK1.8 以后 HashMap 由数组+链表 +红黑树数据结构组成
- 解决哈希冲突时有了较大的变化
- 当链表长度超过(大于)阈值(或者红黑树的边界值,默认为 8)并且当前数组的长度大于等于 64 时,此索引位置上的所有数据改为红黑树存储
- 即使哈希函数取得再好,也很难达到元素百分百均匀分布。当 HashMap 中有大量的元素都存放到同一个桶中时,就相当于一个长的单链表,假如单链表有 n 个元素,遍历的时间复杂度是 O(n),所以 JDK1.8 中引入了 红黑树(查找时间复杂度为 O(logn))来优化这个问题,使得查找效率更高
参考视频:https://www.bilibili.com/video/BV1nJ411J7AA
继承关系
HashMap 继承关系如下图所示:

说明:
- Cloneable 空接口,表示可以克隆, 创建并返回 HashMap 对象的一个副本。
- Serializable 序列化接口,属于标记性接口,HashMap 对象可以被序列化和反序列化。
- AbstractMap 父类提供了 Map 实现接口,以最大限度地减少实现此接口所需的工作
成员属性
-
序列化版本号
private static final long serialVersionUID = 362498820763181265L; -
集合的初始化容量(必须是二的 n 次幂 )
// 默认的初始容量是16 -- 1<<4相当于1*2的4次方---1*16 static final int DEFAULT_INITIAL_CAPACITY = 1 << 4;HashMap 构造方法指定集合的初始化容量大小:
HashMap(int initialCapacity)// 构造一个带指定初始容量和默认加载因子 (0.75) 的空 HashMap-
为什么必须是 2 的 n 次幂?用位运算替代取余计算,减少 rehash 的代价(移动的节点少)
HashMap 中添加元素时,需要根据 key 的 hash 值确定在数组中的具体位置。为了减少碰撞,把数据分配均匀,每个链表长度大致相同,实现该方法就是取模
hash%length,计算机中直接求余效率不如位移运算,hash % length == hash & (length-1)的前提是 length 是 2 的 n 次幂散列平均分布:2 的 n 次方是 1 后面 n 个 0,2 的 n 次方 -1 是 n 个 1,可以保证散列的均匀性,减少碰撞
例如长度为8时候,3&(8-1)=3 2&(8-1)=2 ,不同位置上,不碰撞; 例如长度为9时候,3&(9-1)=0 2&(9-1)=0 ,都在0上,碰撞了; -
如果输入值不是 2 的幂会怎么样?
创建 HashMap 对象时,HashMap 通过位移运算和或运算得到的肯定是 2 的幂次数,并且是大于那个数的最近的数字,底层采用 tableSizeFor() 方法
-
-
默认的负载因子,默认值是 0.75
static final float DEFAULT_LOAD_FACTOR = 0.75f; -
集合最大容量
// 集合最大容量的上限是:2的30次幂 static final int MAXIMUM_CAPACITY = 1 << 30;// 0100 0000 0000 0000 0000 0000 0000 0000 = 2 ^ 30 -
当链表的值超过 8 则会转红黑树(JDK1.8 新增)
// 当桶(bucket)上的结点数大于这个值时会转成红黑树 static final int TREEIFY_THRESHOLD = 8;为什么 Map 桶中节点个数大于 8 才转为红黑树?
-
在 HashMap 中有一段注释说明:空间和时间的权衡
TreeNodes占用空间大约是普通节点的两倍,所以我们只在箱子包含足够的节点时才使用树节点。当节点变少(由于删除或调整大小)时,就会被转换回普通的桶。在使用分布良好的用户hashcode时,很少使用树箱。理想情况下,在随机哈希码下,箱子中节点的频率服从"泊松分布",默认调整阈值为0.75,平均参数约为0.5,尽管由于调整粒度的差异很大。忽略方差,列表大小k的预期出现次数是(exp(-0.5)*pow(0.5, k)/factorial(k)) 0: 0.60653066 1: 0.30326533 2: 0.07581633 3: 0.01263606 4: 0.00157952 5: 0.00015795 6: 0.00001316 7: 0.00000094 8: 0.00000006 more: less than 1 in ten million 一个bin中链表长度达到8个元素的概率为0.00000006,几乎是不可能事件,所以我们选择8这个数字 -
其他说法 红黑树的平均查找长度是 log(n),如果长度为 8,平均查找长度为 log(8)=3,链表的平均查找长度为 n/2,当长度为 8 时,平均查找长度为 8/2=4,这才有转换成树的必要;链表长度如果是小于等于 6,6/2=3,而 log(6)=2.6,虽然速度也很快的,但转化为树结构和生成树的时间并不短
-
-
当链表的值小于 6 则会从红黑树转回链表
// 当桶(bucket)上的结点数小于这个值时树转链表 static final int UNTREEIFY_THRESHOLD = 6; -
当 Map 里面的数量大于等于这个阈值时,表中的桶才能进行树形化 ,否则桶内元素超过 8 时会扩容,而不是树形化。为了避免进行扩容、树形化选择的冲突,这个值不能小于 4 * TREEIFY_THRESHOLD (8)
// 桶中结构转化为红黑树对应的数组长度最小的值 static final int MIN_TREEIFY_CAPACITY = 64;原因:数组比较小的情况下变为红黑树结构,反而会降低效率,红黑树需要进行左旋,右旋,变色这些操作来保持平衡
-
table 用来初始化(必须是二的 n 次幂)
// 存储元素的数组 transient Node<K,V>[] table; -
HashMap 中存放元素的个数
// 存放元素的个数,HashMap中K-V的实时数量,不是table数组的长度 transient int size; -
记录 HashMap 的修改次数
// 每次扩容和更改map结构的计数器 transient int modCount; -
调整大小下一个容量的值计算方式为:容量 * 负载因子,容量是数组的长度
// 临界值,当实际大小(容量*负载因子)超过临界值时,会进行扩容 int threshold; -
哈希表的加载因子
final float loadFactor;-
加载因子的概述
loadFactor 加载因子,是用来衡量 HashMap 满的程度,表示 HashMap 的疏密程度,影响 hash 操作到同一个数组位置的概率,计算 HashMap 的实时加载因子的方法为 size/capacity,而不是占用桶的数量去除以 capacity,capacity 是桶的数量,也就是 table 的长度 length
当 HashMap 容纳的元素已经达到数组长度的 75% 时,表示 HashMap 拥挤需要扩容,而扩容这个过程涉及到 rehash、复制数据等操作,非常消耗性能,所以开发中尽量减少扩容的次数,通过创建 HashMap 集合对象时指定初始容量来避免
HashMap(int initialCapacity, float loadFactor)//构造指定初始容量和加载因子的空HashMap -
为什么加载因子设置为 0.75,初始化临界值是 12?
loadFactor 太大导致查找元素效率低,存放的数据拥挤,太小导致数组的利用率低,存放的数据会很分散。loadFactor 的默认值为 0.75f 是官方给出的一个比较好的临界值
-
threshold 计算公式:capacity(数组长度默认16) * loadFactor(默认 0.75)。当 size >= threshold 的时候,那么就要考虑对数组的 resize(扩容),这就是衡量数组是否需要扩增的一个标准, 扩容后的 HashMap 容量是之前容量的两倍
-
构造方法
-
构造一个空的 HashMap ,默认初始容量(16)和默认负载因子(0.75)
public HashMap() { this.loadFactor = DEFAULT_LOAD_FACTOR; // 将默认的加载因子0.75赋值给loadFactor,并没有创建数组 } -
构造一个具有指定的初始容量和默认负载因子(0.75)HashMap
// 指定“容量大小”的构造函数 public HashMap(int initialCapacity) { this(initialCapacity, DEFAULT_LOAD_FACTOR); } -
构造一个具有指定的初始容量和负载因子的 HashMap
public HashMap(int initialCapacity, float loadFactor) { // 进行判断 // 将指定的加载因子赋值给HashMap成员变量的负载因子loadFactor this.loadFactor = loadFactor; // 最后调用了tableSizeFor this.threshold = tableSizeFor(initialCapacity); }-
对于
this.threshold = tableSizeFor(initialCapacity)JDK8 以后的构造方法中,并没有对 table 这个成员变量进行初始化,table 的初始化被推迟到了 put 方法中,在 put 方法中会对 threshold 重新计算
-
-
包含另一个
Map的构造函数// 构造一个映射关系与指定 Map 相同的新 HashMap public HashMap(Map<? extends K, ? extends V> m) { // 负载因子loadFactor变为默认的负载因子0.75 this.loadFactor = DEFAULT_LOAD_FACTOR; putMapEntries(m, false); }putMapEntries 源码分析:
final void putMapEntries(Map<? extends K, ? extends V> m, boolean evict) { //获取参数集合的长度 int s = m.size(); if (s > 0) { //判断参数集合的长度是否大于0 if (table == null) { // 判断table是否已经初始化 // pre-size // 未初始化,s为m的实际元素个数 float ft = ((float)s / loadFactor) + 1.0F; int t = ((ft < (float)MAXIMUM_CAPACITY) ? (int)ft : MAXIMUM_CAPACITY); // 计算得到的t大于阈值,则初始化阈值 if (t > threshold) threshold = tableSizeFor(t); } // 已初始化,并且m元素个数大于阈值,进行扩容处理 else if (s > threshold) resize(); // 将m中的所有元素添加至HashMap中 for (Map.Entry<? extends K, ? extends V> e : m.entrySet()) { K key = e.getKey(); V value = e.getValue(); putVal(hash(key), key, value, false, evict); } } }float ft = ((float)s / loadFactor) + 1.0F这一行代码中为什么要加 1.0F ?s / loadFactor 的结果是小数,加 1.0F 相当于是对小数做一个向上取整以尽可能的保证更大容量,更大的容量能够减少 resize 的调用次数,这样可以减少数组的扩容
成员方法
-
hash():HashMap 是支持 Key 为空的;HashTable 是直接用 Key 来获取 HashCode,key 为空会抛异常
-
&(按位与运算):相同的二进制数位上,都是 1 的时候,结果为 1,否则为零
-
^(按位异或运算):相同的二进制数位上,数字相同,结果为 0,不同为 1,不进位加法
0 1 相互做 & | ^ 运算,结果出现 0 和 1 的数量分别是 3:1、1:3、1:1,所以异或是最平均的
static final int hash(Object key) { int h; // 1)如果key等于null:可以看到当key等于null的时候也是有哈希值的,返回的是0 // 2)如果key不等于null:首先计算出key的hashCode赋值给h,然后与h无符号右移16位后的二进制进行按位异或 return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16); }计算 hash 的方法:将 hashCode 无符号右移 16 位,高 16bit 和低 16bit 做异或,扰动运算
原因:当数组长度很小,假设是 16,那么 n-1 即为 1111 ,这样的值和 hashCode() 直接做按位与操作,实际上只使用了哈希值的后 4 位。如果当哈希值的高位变化很大,低位变化很小,就很容易造成哈希冲突了,所以这里把高低位都利用起来,让高16 位也参与运算,从而解决了这个问题
哈希冲突的处理方式:
- 开放定址法:线性探查法(ThreadLocalMap 使用),平方探查法(i + 1^2、i - 1^2、i + 2^2……)、双重散列(多个哈希函数)
- 链地址法:拉链法
-
-
put():jdk1.8 前是头插法 (链地址法),多线程下扩容出现循环链表,jdk1.8 以后引入红黑树,插入方法变成尾插法
第一次调用 put 方法时创建数组 Node[] table,因为散列表耗费内存,为了防止内存浪费,所以延迟初始化
存储数据步骤(存储过程):
- 先通过 hash 值计算出 key 映射到哪个桶,哈希寻址
- 如果桶上没有碰撞冲突,则直接插入
- 如果出现碰撞冲突:如果该桶使用红黑树处理冲突,则调用红黑树的方法插入数据;否则采用传统的链式方法插入,如果链的长度达到临界值,则把链转变为红黑树
- 如果数组位置相同,通过 equals 比较内容是否相同:相同则新的 value 覆盖旧 value,不相同则将新的键值对添加到哈希表中
- 最后判断 size 是否大于阈值 threshold,则进行扩容
public V put(K key, V value) { return putVal(hash(key), key, value, false, true); }putVal() 方法中 key 在这里执行了一下 hash(),在 putVal 函数中使用到了上述 hash 函数计算的哈希值:
final V putVal(int hash, K key, V value, boolean onlyIfAbsent, boolean evict) { //。。。。。。。。。。。。。。 if ((p = tab[i = (n - 1) & hash]) == null){//这里的n表示数组长度16 //..... } else { if (e != null) { // existing mapping for key V oldValue = e.value; //onlyIfAbsent默认为false,所以可以覆盖已经存在的数据,如果为true说明不能覆盖 if (!onlyIfAbsent || oldValue == null) e.value = value; afterNodeAccess(e); // 如果这里允许覆盖,就直接返回了 return oldValue; } } // 如果是添加操作,modCount ++,如果不是替换,不会走这里的逻辑,modCount用来记录逻辑的变化 ++modCount; // 数量大于扩容阈值 if (++size > threshold) resize(); afterNodeInsertion(evict); return null; }(n - 1) & hash:计算下标位置
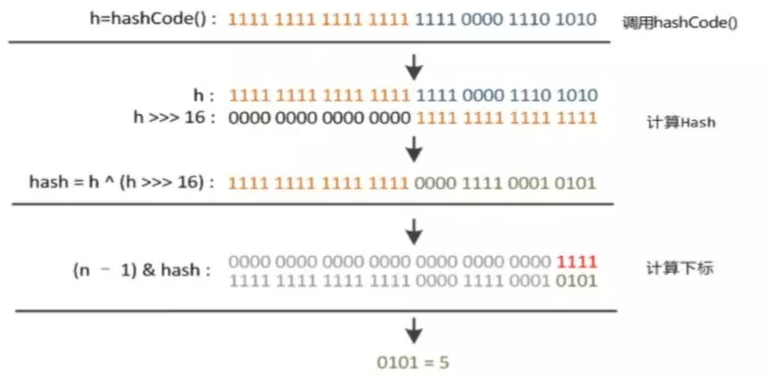
- 余数本质是不断做除法,把剩余的数减去,运算效率要比位运算低
-
treeifyBin()
节点添加完成之后判断此时节点个数是否大于 TREEIFY_THRESHOLD 临界值 8,如果大于则将链表转换为红黑树,转换红黑树的方法 treeifyBin,整体代码如下:
if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st //转换为红黑树 tab表示数组名 hash表示哈希值 treeifyBin(tab, hash);- 如果当前数组为空或者数组的长度小于进行树形化的阈 MIN_TREEIFY_CAPACITY = 64 就去扩容,而不是将节点变为红黑树
- 如果是树形化遍历桶中的元素,创建相同个数的树形节点,复制内容,建立起联系,类似单向链表转换为双向链表
- 让桶中的第一个元素即数组中的元素指向新建的红黑树的节点,以后这个桶里的元素就是红黑树而不是链表数据结构了
-
tableSizeFor():创建 HashMap 指定容量时,HashMap 通过位移运算和或运算得到比指定初始化容量大的最小的 2 的 n 次幂
static final int tableSizeFor(int cap) {//int cap = 10 int n = cap - 1; n |= n >>> 1; n |= n >>> 2; n |= n >>> 4; n |= n >>> 8; n |= n >>> 16; return (n < 0) ? 1 : (n >= MAXIMUM_CAPACITY) ? MAXIMUM_CAPACITY : n + 1; }分析算法:
int n = cap - 1:防止 cap 已经是 2 的幂。如果 cap 已经是 2 的幂, 不执行减 1 操作,则执行完后面的无符号右移操作之后,返回的 capacity 将是这个 cap 的 2 倍- n=0 (cap-1 之后),则经过后面的几次无符号右移依然是 0,返回的 capacity 是 1,最后有 n+1
- |(按位或运算):相同的二进制数位上,都是 0 的时候,结果为 0,否则为 1
- 核心思想:把最高位是 1 的位以及右边的位全部置 1,结果加 1 后就是大于指定容量的最小的 2 的 n 次幂
例如初始化的值为 10:
-
第一次右移
int n = cap - 1;//cap=10 n=9 n |= n >>> 1; 00000000 00000000 00000000 00001001 //9 00000000 00000000 00000000 00000100 //9右移之后变为4 -------------------------------------------------- 00000000 00000000 00000000 00001101 //按位或之后是13 //使得n的二进制表示中与最高位的1紧邻的右边一位为1 -
第二次右移
n |= n >>> 2;//n通过第一次右移变为了:n=13 00000000 00000000 00000000 00001101 // 13 00000000 00000000 00000000 00000011 // 13右移之后变为3 ------------------------------------------------- 00000000 00000000 00000000 00001111 //按位或之后是15 //无符号右移两位,会将最高位两个连续的1右移两位,然后再与原来的n做或操作,这样n的二进制表示的高位中会有4个连续的1注意:容量最大是 32bit 的正数,因此最后
n |= n >>> 16,最多是 32 个 1(但是这已经是负数了)。在执行 tableSizeFor 之前,对 initialCapacity 做了判断,如果大于 MAXIMUM_CAPACITY(2 ^ 30),则取 MAXIMUM_CAPACITY;如果小于 MAXIMUM_CAPACITY(2 ^ 30),会执行移位操作,所以移位操作之后,最大 30 个 1,加 1 之后得 2 ^ 30 -
得到的 capacity 被赋值给了 threshold
this.threshold = tableSizeFor(initialCapacity);//initialCapacity=10 -
JDK 11
static final int tableSizeFor(int cap) { //无符号右移,高位补0 //-1补码: 11111111 11111111 11111111 11111111 int n = -1 >>> Integer.numberOfLeadingZeros(cap - 1); return (n < 0) ? 1 : (n >= MAXIMUM_CAPACITY) ? MAXIMUM_CAPACITY : n + 1; } //返回最高位之前的0的位数 public static int numberOfLeadingZeros(int i) { if (i <= 0) return i == 0 ? 32 : 0; // 如果i>0,那么就表明在二进制表示中其至少有一位为1 int n = 31; // i的最高位1在高16位,把i右移16位,让最高位1进入低16位继续递进判断 if (i >= 1 << 16) { n -= 16; i >>>= 16; } if (i >= 1 << 8) { n -= 8; i >>>= 8; } if (i >= 1 << 4) { n -= 4; i >>>= 4; } if (i >= 1 << 2) { n -= 2; i >>>= 2; } return n - (i >>> 1); }
-
resize():
当 HashMap 中的元素个数超过
(数组长度)*loadFactor(负载因子)或者链表过长时(链表长度 > 8,数组长度 < 64),就会进行数组扩容,创建新的数组,伴随一次重新 hash 分配,并且遍历 hash 表中所有的元素非常耗时,所以要尽量避免 resize扩容机制为扩容为原来容量的 2 倍:
if (oldCap > 0) { if (oldCap >= MAXIMUM_CAPACITY) { // 以前的容量已经是最大容量了,这时调大 扩容阈值 threshold threshold = Integer.MAX_VALUE; return oldTab; } else if ((newCap = oldCap << 1) < MAXIMUM_CAPACITY && oldCap >= DEFAULT_INITIAL_CAPACITY) newThr = oldThr << 1; // double threshold } else if (oldThr > 0) // 初始化的threshold赋值给newCap newCap = oldThr; else { newCap = DEFAULT_INITIAL_CAPACITY; newThr = (int)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY); }HashMap 在进行扩容后,节点要么就在原来的位置,要么就被分配到”原位置+旧容量”的位置
判断:e.hash 与 oldCap 对应的有效高位上的值是 1,即当前数组长度 n 二进制为 1 的位为 x 位,如果 key 的哈希值 x 位也为 1,则扩容后的索引为 now + n
注意:这里要求数组长度 2 的幂
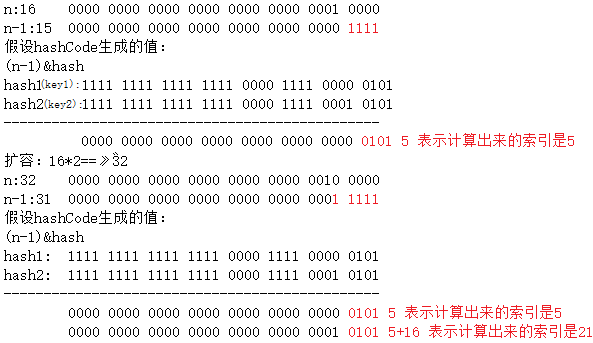
普通节点:把所有节点分成高低位两个链表,转移到数组
// 遍历所有的节点 do { next = e.next; // oldCap 旧数组大小,2 的 n 次幂 if ((e.hash & oldCap) == 0) { if (loTail == null) loHead = e; //指向低位链表头节点 else loTail.next = e; loTail = e; //指向低位链表尾节点 } else { if (hiTail == null) hiHead = e; else hiTail.next = e; hiTail = e; } } while ((e = next) != null); if (loTail != null) { loTail.next = null; // 低位链表的最后一个节点可能在原哈希表中指向其他节点,需要断开 newTab[j] = loHead; }红黑树节点:扩容时 split 方法会将树拆成高位和低位两个链表,判断长度是否小于等于 6
//如果低位链表首节点不为null,说明有这个链表存在 if (loHead != null) { //如果链表下的元素小于等于6 if (lc <= UNTREEIFY_THRESHOLD) //那就从红黑树转链表了,低位链表,迁移到新数组中下标不变,还是等于原数组到下标 tab[index] = loHead.untreeify(map); else { //低位链表,迁移到新数组中下标不变,把低位链表整个赋值到这个下标下 tab[index] = loHead; //如果高位首节点不为空,说明原来的红黑树已经被拆分成两个链表了 if (hiHead != null) //需要构建新的红黑树了 loHead.treeify(tab); } }
-
remove():删除是首先先找到元素的位置,如果是链表就遍历链表找到元素之后删除。如果是用红黑树就遍历树然后找到之后做删除,树小于 6 的时候退化为链表
final Node<K,V> removeNode(int hash, Object key, Object value, boolean matchValue, boolean movable) { Node<K,V>[] tab; Node<K,V> p; int n, index; // 节点数组tab不为空、数组长度n大于0、根据hash定位到的节点对象p, // 该节点为树的根节点或链表的首节点)不为空,从该节点p向下遍历,找到那个和key匹配的节点对象 if ((tab = table) != null && (n = tab.length) > 0 && (p = tab[index = (n - 1) & hash]) != null) { Node<K,V> node = null, e; K k; V v;//临时变量,储存要返回的节点信息 //key和value都相等,直接返回该节点 if (p.hash == hash && ((k = p.key) == key || (key != null && key.equals(k)))) node = p; else if ((e = p.next) != null) { //如果是树节点,调用getTreeNode方法从树结构中查找满足条件的节点 if (p instanceof TreeNode) node = ((TreeNode<K,V>)p).getTreeNode(hash, key); //遍历链表 else { do { //e节点的键是否和key相等,e节点就是要删除的节点,赋值给node变量 if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) { node = e; //跳出循环 break; } p = e;//把当前节点p指向e 继续遍历 } while ((e = e.next) != null); } } //如果node不为空,说明根据key匹配到了要删除的节点 //如果不需要对比value值或者对比value值但是value值也相等,可以直接删除 if (node != null && (!matchValue || (v = node.value) == value || (value != null && value.equals(v)))) { if (node instanceof TreeNode) ((TreeNode<K,V>)node).removeTreeNode(this, tab, movable); else if (node == p)//node是首节点 tab[index] = node.next; else //node不是首节点 p.next = node.next; ++modCount; --size; //LinkedHashMap afterNodeRemoval(node); return node; } } return null; } -
get()
-
通过 hash 值获取该 key 映射到的桶
-
桶上的 key 就是要查找的 key,则直接找到并返回
-
桶上的 key 不是要找的 key,则查看后续的节点:
-
如果后续节点是红黑树节点,通过调用红黑树的方法根据 key 获取 value
-
如果后续节点是链表节点,则通过循环遍历链表根据 key 获取 value
-
-
红黑树节点调用的是 getTreeNode 方法通过树形节点的 find 方法进行查
- 查找红黑树,之前添加时已经保证这个树是有序的,因此查找时就是折半查找,效率更高。
- 这里和插入时一样,如果对比节点的哈希值相等并且通过 equals 判断值也相等,就会判断 key 相等,直接返回,不相等就从子树中递归查找
-
时间复杂度 O(1)
- 若为树,则在树中通过 key.equals(k) 查找,O(logn)
- 若为链表,则在链表中通过 key.equals(k) 查找,O(n)
-
并发异常
HashMap 和 ArrayList 一样,内部采用 modCount 用来记录集合结构发生变化的次数,结构发生变化是指添加或者删除至少一个元素的所有操作,或者是调整内部数组的大小,仅仅只是设置元素的值不算结构发生变化
在进行序列化或者迭代等操作时,需要比较操作前后 modCount 是否改变,如果其他线程此时修改了集合内部的结构,就会直接抛出 ConcurrentModificationException 异常
HashMap map = new HashMap();
Iterator iterator = map.keySet().iterator();final class KeySet extends AbstractSet<K> {
// 底层获取的是 KeyIterator
public final Iterator<K> iterator() {
return new KeyIterator();
}
}
final class KeyIterator extends HashIterator implements Iterator<K> {
// 回调 HashMap.HashIterator#nextNode
public final K next() {
return nextNode().key;
}
}abstract class HashIterator {
Node<K,V> next; // next entry to return
Node<K,V> current; // current entry
int expectedModCount; // for 【fast-fail】,快速失败
int index; // current slot
HashIterator() {
// 把当前 map 的数量赋值给 expectedModCount,迭代时判断
expectedModCount = modCount;
Node<K,V>[] t = table;
current = next = null;
index = 0;
if (t != null && size > 0) { // advance to first entry
do {} while (index < t.length && (next = t[index++]) == null);
}
}
public final boolean hasNext() {
return next != null;
}
// iterator.next() 会调用这个函数
final Node<K,V> nextNode() {
Node<K,V>[] t;
Node<K,V> e = next;
// 这里会判断 集合的结构是否发生了变化,变化后 modCount 会改变,直接抛出并发异常
if (modCount != expectedModCount)
throw new ConcurrentModificationException();
if (e == null)
throw new NoSuchElementException();
if ((next = (current = e).next) == null && (t = table) != null) {
do {} while (index < t.length && (next = t[index++]) == null);
}
return e;
}
// 迭代器允许删除集合的元素,【删除后会重置 expectedModCount = modCount】
public final void remove() {
Node<K,V> p = current;
if (p == null)
throw new IllegalStateException();
if (modCount != expectedModCount)
throw new ConcurrentModificationException();
current = null;
K key = p.key;
removeNode(hash(key), key, null, false, false);
// 同步expectedModCount
expectedModCount = modCount;
}
}LinkedMap
原理分析
LinkedHashMap 是 HashMap 的子类
-
优点:添加的元素按照键有序不重复的,有序的原因是底层维护了一个双向链表
-
缺点:会占用一些内存空间
对比 Set:
- HashSet 集合相当于是 HashMap 集合的键,不带值
- LinkedHashSet 集合相当于是 LinkedHashMap 集合的键,不带值
- 底层原理完全一样,都是基于哈希表按照键存储数据的,只是 Map 多了一个键的值
源码解析:
-
内部维护了一个双向链表,用来维护插入顺序或者 LRU 顺序
transient LinkedHashMap.Entry<K,V> head; transient LinkedHashMap.Entry<K,V> tail; -
accessOrder 决定了顺序,默认为 false 维护的是插入顺序(先进先出),true 为访问顺序(LRU 顺序)
final boolean accessOrder; -
维护顺序的函数
void afterNodeAccess(Node<K,V> p) {} void afterNodeInsertion(boolean evict) {} -
put()
// 调用父类HashMap的put方法 public V put(K key, V value) { return putVal(hash(key), key, value, false, true); } final V putVal(int hash, K key, V value, boolean onlyIfAbsent, boolean evict) → afterNodeInsertion(evict);// evict为trueafterNodeInsertion方法,当 removeEldestEntry() 方法返回 true 时会移除最近最久未使用的节点,也就是链表首部节点 first
void afterNodeInsertion(boolean evict) { LinkedHashMap.Entry<K,V> first; // evict 只有在构建 Map 的时候才为 false,这里为 true if (evict && (first = head) != null && removeEldestEntry(first)) { K key = first.key; removeNode(hash(key), key, null, false, true);//移除头节点 } }removeEldestEntry() 默认为 false,如果需要让它为 true,需要继承 LinkedHashMap 并且覆盖这个方法的实现,在实现 LRU 的缓存中特别有用,通过移除最近最久未使用的节点,从而保证缓存空间足够,并且缓存的数据都是热点数据
protected boolean removeEldestEntry(Map.Entry<K,V> eldest) { return false; } -
get()
当一个节点被访问时,如果 accessOrder 为 true,则会将该节点移到链表尾部。也就是说指定为 LRU 顺序之后,在每次访问一个节点时会将这个节点移到链表尾部,那么链表首部就是最近最久未使用的节点
public V get(Object key) { Node<K,V> e; if ((e = getNode(hash(key), key)) == null) return null; if (accessOrder) afterNodeAccess(e); return e.value; }void afterNodeAccess(Node<K,V> e) { LinkedHashMap.Entry<K,V> last; if (accessOrder && (last = tail) != e) { // 向下转型 LinkedHashMap.Entry<K,V> p = (LinkedHashMap.Entry<K,V>)e, b = p.before, a = p.after; p.after = null; // 判断 p 是否是首节点 if (b == null) //是头节点 让p后继节点成为头节点 head = a; else //不是头节点 让p的前驱节点的next指向p的后继节点,维护链表的连接 b.after = a; // 判断p是否是尾节点 if (a != null) // 不是尾节点 让p后继节点指向p的前驱节点 a.before = b; else // 是尾节点 让last指向p的前驱节点 last = b; // 判断last是否是空 if (last == null) // last为空说明p是尾节点或者只有p一个节点 head = p; else { // last和p相互连接 p.before = last; last.after = p; } tail = p; ++modCount; } } -
remove()
//调用HashMap的remove方法 final Node<K,V> removeNode(int hash, Object key, Object value,boolean matchValue, boolean movable) → afterNodeRemoval(node);当 HashMap 删除一个键值对时调用,会把在 HashMap 中删除的那个键值对一并从链表中删除
void afterNodeRemoval(Node<K,V> e) { LinkedHashMap.Entry<K,V> p = (LinkedHashMap.Entry<K,V>)e, b = p.before, a = p.after; // 让p节点与前驱节点和后继节点断开链接 p.before = p.after = null; // 判断p是否是头节点 if (b == null) // p是头节点 让head指向p的后继节点 head = a; else // p不是头节点 让p的前驱节点的next指向p的后继节点,维护链表的连接 b.after = a; // 判断p是否是尾节点,是就让tail指向p的前驱节点,不是就让p.after指向前驱节点,双向 if (a == null) tail = b; else a.before = b; }
LRU
使用 LinkedHashMap 实现的一个 LRU 缓存:
- 设定最大缓存空间 MAX_ENTRIES 为 3
- 使用 LinkedHashMap 的构造函数将 accessOrder 设置为 true,开启 LRU 顺序
- 覆盖 removeEldestEntry() 方法实现,在节点多于 MAX_ENTRIES 就会将最近最久未使用的数据移除
public static void main(String[] args) {
LRUCache<Integer, String> cache = new LRUCache<>();
cache.put(1, "a");
cache.put(2, "b");
cache.put(3, "c");
cache.get(1);//把1放入尾部
cache.put(4, "d");
System.out.println(cache.keySet());//[3, 1, 4]只能存3个,移除2
}
class LRUCache<K, V> extends LinkedHashMap<K, V> {
private static final int MAX_ENTRIES = 3;
protected boolean removeEldestEntry(Map.Entry eldest) {
return size() > MAX_ENTRIES;
}
LRUCache() {
super(MAX_ENTRIES, 0.75f, true);
}
}TreeMap
TreeMap 实现了 SotredMap 接口,是有序不可重复的键值对集合,基于红黑树(Red-Black tree)实现,每个 key-value 都作为一个红黑树的节点,如果构造 TreeMap 没有指定比较器,则根据 key 执行自然排序(默认升序),如果指定了比较器则按照比较器来进行排序
TreeMap 集合指定大小规则有 2 种方式:
- 直接为对象的类实现比较器规则接口 Comparable,重写比较方法
- 直接为集合设置比较器 Comparator 对象,重写比较方法
说明:TreeSet 集合的底层是基于 TreeMap,只是键的附属值为空对象而已
成员属性:
-
Entry 节点
static final class Entry<K,V> implements Map.Entry<K,V> { K key; V value; Entry<K,V> left; //左孩子节点 Entry<K,V> right; //右孩子节点 Entry<K,V> parent; //父节点 boolean color = BLACK; //节点的颜色,在红黑树中只有两种颜色,红色和黑色 } -
compare()
//如果comparator为null,采用comparable.compartTo进行比较,否则采用指定比较器比较大小 final int compare(Object k1, Object k2) { return comparator == null ? ((Comparable<? super K>)k1).compareTo((K)k2) : comparator.compare((K)k1, (K)k2); }
参考文章:https://blog.csdn.net/weixin_33991727/article/details/91518677
WeakMap
WeakHashMap 是基于弱引用的,内部的 Entry 继承 WeakReference,被弱引用关联的对象在下一次垃圾回收时会被回收,并且构造方法传入引用队列,用来在清理对象完成以后清理引用
private static class Entry<K,V> extends WeakReference<Object> implements Map.Entry<K,V> {
Entry(Object key, V value, ReferenceQueue<Object> queue, int hash, Entry<K,V> next) {
super(key, queue);
this.value = value;
this.hash = hash;
this.next = next;
}
}WeakHashMap 主要用来实现缓存,使用 WeakHashMap 来引用缓存对象,由 JVM 对这部分缓存进行回收
Tomcat 中的 ConcurrentCache 使用了 WeakHashMap 来实现缓存功能,ConcurrentCache 采取分代缓存:
-
经常使用的对象放入 eden 中,eden 使用 ConcurrentHashMap 实现,不用担心会被回收(伊甸园)
-
不常用的对象放入 longterm,longterm 使用 WeakHashMap 实现,这些老对象会被垃圾收集器回收
-
当调用 get() 方法时,会先从 eden 区获取,如果没有找到的话再到 longterm 获取,当从 longterm 获取到就把对象放入 eden 中,从而保证经常被访问的节点不容易被回收
-
当调用 put() 方法时,如果 eden 的大小超过了 size,那么就将 eden 中的所有对象都放入 longterm 中,利用虚拟机回收掉一部分不经常使用的对象
public final class ConcurrentCache<K, V> { private final int size; private final Map<K, V> eden; private final Map<K, V> longterm; public ConcurrentCache(int size) { this.size = size; this.eden = new ConcurrentHashMap<>(size); this.longterm = new WeakHashMap<>(size); } public V get(K k) { V v = this.eden.get(k); if (v == null) { v = this.longterm.get(k); if (v != null) this.eden.put(k, v); } return v; } public void put(K k, V v) { if (this.eden.size() >= size) { this.longterm.putAll(this.eden); this.eden.clear(); } this.eden.put(k, v); } }