SYSTEM
Collection
src/content/notes/system/Collection.md Collection
概述
Java 中集合的代表是 Collection,Collection 集合是 Java 中集合的祖宗类
Collection 集合底层为数组:[value1, value2, ....]
Collection集合的体系:
Collection<E>(接口)
/ \
Set<E>(接口) List<E>(接口)
/ \ / \
HashSet<E>(实现类) TreeSet<>(实现类) ArrayList<E>(实现类) LinekdList<>(实现类)
/
LinkedHashSet<>(实现类)集合的特点:
- Set 系列集合:添加的元素是无序,不重复,无索引的
- HashSet:添加的元素是无序,不重复,无索引的
- LinkedHashSet:添加的元素是有序,不重复,无索引的
- TreeSet:不重复,无索引,按照大小默认升序排序
- List 系列集合:添加的元素是有序,可重复,有索引
- ArrayList:添加的元素是有序,可重复,有索引
- LinekdList:添加的元素是有序,可重复,有索引
API
Collection 是集合的祖宗类,它的功能是全部集合都可以继承使用的,所以要学习它。
Collection 子类的构造器都有可以包装其他子类的构造方法,如:
-
public ArrayList(Collection<? extends E> c):构造新集合,元素按照由集合的迭代器返回的顺序 -
public HashSet(Collection<? extends E> c):构造一个包含指定集合中的元素的新集合
Collection API 如下:
public boolean add(E e):把给定的对象添加到当前集合中 。public void clear():清空集合中所有的元素。public boolean remove(E e):把给定的对象在当前集合中删除。public boolean contains(Object obj):判断当前集合中是否包含给定的对象。public boolean isEmpty():判断当前集合是否为空。public int size():返回集合中元素的个数。public Object[] toArray():把集合中的元素,存储到数组中public boolean addAll(Collection<? extends E> c):将指定集合中的所有元素添加到此集合
public class CollectionDemo {
public static void main(String[] args) {
Collection<String> sets = new HashSet<>();
sets.add("MyBatis");
System.out.println(sets.add("Java"));//true
System.out.println(sets.add("Java"));//false
sets.add("Spring");
sets.add("MySQL");
System.out.println(sets)//[]无序的;
System.out.println(sets.contains("java"));//true 存在
Object[] arrs = sets.toArray();
System.out.println("数组:"+ Arrays.toString(arrs));
Collection<String> c1 = new ArrayList<>();
c1.add("java");
Collection<String> c2 = new ArrayList<>();
c2.add("ee");
c1.addAll(c2);// c1:[java,ee] c2:[ee];
}
}遍历
Collection 集合的遍历方式有三种:
集合可以直接输出内容,因为底层重写了 toString() 方法
-
迭代器
public Iterator iterator():获取集合对应的迭代器,用来遍历集合中的元素的E next():获取下一个元素值boolean hasNext():判断是否有下一个元素,有返回 true ,反之返回 falsedefault void remove():从底层集合中删除此迭代器返回的最后一个元素,这种方法只能在每次调用 next() 时调用一次
-
增强 for 循环:可以遍历集合或者数组,遍历集合实际上是迭代器遍历的简化写法
for(被遍历集合或者数组中元素的类型 变量名称 : 被遍历集合或者数组){ }缺点:遍历无法知道遍历到了哪个元素了,因为没有索引
-
JDK 1.8 开始之后的新技术 Lambda 表达式
public class CollectionDemo { public static void main(String[] args) { Collection<String> lists = new ArrayList<>(); lists.add("aa"); lists.add("bb"); lists.add("cc"); System.out.println(lists); // lists = [aa, bb, cc] //迭代器流程 // 1.得到集合的迭代器对象。 Iterator<String> it = lists.iterator(); // 2.使用while循环遍历。 while(it.hasNext()){ String ele = it.next(); System.out.println(ele); } //增强for for (String ele : lists) { System.out.println(ele); } //lambda表达式 lists.forEach(s -> { System.out.println(s); }); } }
List
概述
List 集合继承了 Collection 集合全部的功能。
List 系列集合有索引,所以多了很多按照索引操作元素的功能:for 循环遍历(4 种遍历)
List 系列集合:
-
ArrayList:添加的元素是有序,可重复,有索引
-
LinekdList:添加的元素是有序,可重复,有索引
ArrayList
介绍
ArrayList 添加的元素,是有序,可重复,有索引的
public boolean add(E e):将指定的元素追加到此集合的末尾public void add(int index, E element):将指定的元素,添加到该集合中的指定位置上public E get(int index):返回集合中指定位置的元素public E remove(int index):移除列表中指定位置的元素,返回的是被移除的元素public E set(int index, E element):用指定元素替换集合中指定位置的元素,返回更新前的元素值int indexOf(Object o):返回列表中指定元素第一次出现的索引,如果不包含此元素,则返回 -1
public static void main(String[] args){
List<String> lists = new ArrayList<>();//多态
lists.add("java1");
lists.add("java1");//可以重复
lists.add("java2");
for(int i = 0 ; i < lists.size() ; i++ ) {
String ele = lists.get(i);
System.out.println(ele);
}
}源码
ArrayList 实现类集合底层基于数组存储数据的,查询快,增删慢,支持快速随机访问
public class ArrayList<E> extends AbstractList<E>
implements List<E>, RandomAccess, Cloneable, java.io.Serializable{}RandomAccess是一个标志接口,表明实现这个这个接口的 List 集合是支持快速随机访问的。在ArrayList中,我们即可以通过元素的序号快速获取元素对象,这就是快速随机访问。ArrayList实现了Cloneable接口 ,即覆盖了函数clone(),能被克隆ArrayList实现了Serializable接口,这意味着ArrayList支持序列化,能通过序列化去传输
核心方法:
-
构造函数:以无参数构造方法创建 ArrayList 时,实际上初始化赋值的是一个空数组。当真正对数组进行添加元素操作时,才真正分配容量(惰性初始化),即向数组中添加第一个元素时,数组容量扩为 10
-
添加元素:
// e 插入的元素 elementData底层数组 size 插入的位置 public boolean add(E e) { ensureCapacityInternal(size + 1); // Increments modCount!! elementData[size++] = e; // 插入size位置,然后加一 return true; }当 add 第 1 个元素到 ArrayList,size 是 0,进入 ensureCapacityInternal 方法,
private void ensureCapacityInternal(int minCapacity) { ensureExplicitCapacity(calculateCapacity(elementData, minCapacity)); }private static int calculateCapacity(Object[] elementData, int minCapacity) { // 判断elementData是不是空数组 if (elementData == DEFAULTCAPACITY_EMPTY_ELEMENTDATA) { // 返回默认值和最小需求容量最大的一个 return Math.max(DEFAULT_CAPACITY, minCapacity); } return minCapacity; }如果需要的容量大于数组长度,进行扩容:
// 判断是否需要扩容 private void ensureExplicitCapacity(int minCapacity) { modCount++; // 索引越界 if (minCapacity - elementData.length > 0) // 调用grow方法进行扩容,调用此方法代表已经开始扩容了 grow(minCapacity); }指定索引插入,在旧数组上操作:
public void add(int index, E element) { rangeCheckForAdd(index); ensureCapacityInternal(size + 1); // Increments modCount!! // 将指定索引后的数据后移 System.arraycopy(elementData, index, elementData, index + 1, size - index); elementData[index] = element; size++; } -
扩容:新容量的大小为
oldCapacity + (oldCapacity >> 1),oldCapacity >> 1需要取整,所以新容量大约是旧容量的 1.5 倍左右,即 oldCapacity+oldCapacity/2扩容操作需要调用
Arrays.copyOf()(底层System.arraycopy())把原数组整个复制到新数组中,这个操作代价很高,因此最好在创建 ArrayList 对象时就指定大概的容量大小,减少扩容操作的次数private void grow(int minCapacity) { int oldCapacity = elementData.length; int newCapacity = oldCapacity + (oldCapacity >> 1); //检查新容量是否大于最小需要容量,若小于最小需要容量,就把最小需要容量当作数组的新容量 if (newCapacity - minCapacity < 0) newCapacity = minCapacity;//不需要扩容计算 //检查新容量是否大于最大数组容量 if (newCapacity - MAX_ARRAY_SIZE > 0) //如果minCapacity大于最大容量,则新容量则为`Integer.MAX_VALUE` //否则,新容量大小则为 MAX_ARRAY_SIZE 即为 `Integer.MAX_VALUE - 8` newCapacity = hugeCapacity(minCapacity); elementData = Arrays.copyOf(elementData, newCapacity); }MAX_ARRAY_SIZE:要分配的数组的最大大小,分配更大的可能会导致
- OutOfMemoryError:Requested array size exceeds VM limit(请求的数组大小超出 VM 限制)
- OutOfMemoryError: Java heap space(堆区内存不足,可以通过设置 JVM 参数 -Xmx 来调节)
-
删除元素:需要调用 System.arraycopy() 将 index+1 后面的元素都复制到 index 位置上,在旧数组上操作,该操作的时间复杂度为 O(N),可以看到 ArrayList 删除元素的代价是非常高的
public E remove(int index) { rangeCheck(index); modCount++; E oldValue = elementData(index); int numMoved = size - index - 1; if (numMoved > 0) System.arraycopy(elementData, index+1, elementData, index, numMoved); elementData[--size] = null; // clear to let GC do its work return oldValue; } -
序列化:ArrayList 基于数组并且具有动态扩容特性,因此保存元素的数组不一定都会被使用,就没必要全部进行序列化。保存元素的数组 elementData 使用 transient 修饰,该关键字声明数组默认不会被序列化
transient Object[] elementData; -
ensureCapacity:增加此实例的容量,以确保它至少可以容纳最小容量参数指定的元素数,减少增量重新分配的次数
public void ensureCapacity(int minCapacity) { if (minCapacity > elementData.length && !(elementData == DEFAULTCAPACITY_EMPTY_ELEMENTDATA && minCapacity <= DEFAULT_CAPACITY)) { modCount++; grow(minCapacity); } } -
Fail-Fast:快速失败,modCount 用来记录 ArrayList 结构发生变化的次数,结构发生变化是指添加或者删除至少一个元素的操作,或者是调整内部数组的大小,仅仅只是设置元素的值不算结构发生变化
在进行序列化或者迭代等操作时,需要比较操作前后 modCount 是否改变,改变了抛出 ConcurrentModificationException 异常
public Iterator<E> iterator() { return new Itr(); }private class Itr implements Iterator<E> { int cursor; // index of next element to return int lastRet = -1; // index of last element returned; -1 if no such int expectedModCount = modCount; Itr() {} public boolean hasNext() { return cursor != size; } // 获取下一个元素时首先判断结构是否发生变化 public E next() { checkForComodification(); // ..... } // modCount 被其他线程改变抛出并发修改异常 final void checkForComodification() { if (modCount != expectedModCount) throw new ConcurrentModificationException(); } // 【允许删除操作】 public void remove() { // ... checkForComodification(); // ... // 删除后重置 expectedModCount expectedModCount = modCount; } }
Vector
同步:Vector 的实现与 ArrayList 类似,但是方法上使用了 synchronized 进行同步
构造:默认长度为 10 的数组
扩容:Vector 的构造函数可以传入 capacityIncrement 参数,作用是在扩容时使容量 capacity 增长 capacityIncrement,如果这个参数的值小于等于 0(默认0),扩容时每次都令 capacity 为原来的两倍
对比 ArrayList
-
Vector 是同步的,开销比 ArrayList 要大,访问速度更慢。最好使用 ArrayList 而不是 Vector,因为同步操作完全可以由程序来控制
-
Vector 每次扩容请求其大小的 2 倍(也可以通过构造函数设置增长的容量),而 ArrayList 是 1.5 倍
-
底层都是
Object[]数组存储
LinkedList
介绍
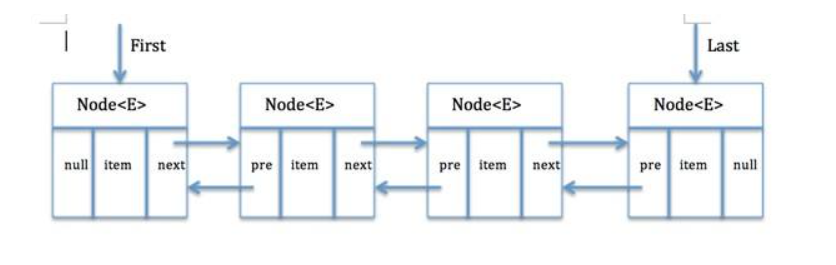
LinkedList 也是 List 的实现类:基于双向链表实现,使用 Node 存储链表节点信息,增删比较快,查询慢
LinkedList 除了拥有 List 集合的全部功能还多了很多操作首尾元素的特殊功能:
public boolean add(E e):将指定元素添加到此列表的结尾public E poll():检索并删除此列表的头(第一个元素)public void addFirst(E e):将指定元素插入此列表的开头public void addLast(E e):将指定元素添加到此列表的结尾public E pop():从此列表所表示的堆栈处弹出一个元素public void push(E e):将元素推入此列表所表示的堆栈public int indexOf(Object o):返回此列表中指定元素的第一次出现的索引,如果不包含返回 -1public int lastIndexOf(Object o):从尾遍历找public boolean remove(Object o):一次只删除一个匹配的对象,如果删除了匹配对象返回 truepublic E remove(int index):删除指定位置的元素
public class ListDemo {
public static void main(String[] args) {
// 1.用LinkedList做一个队列:先进先出,后进后出。
LinkedList<String> queue = new LinkedList<>();
// 入队
queue.addLast("1号");
queue.addLast("2号");
queue.addLast("3号");
System.out.println(queue); // [1号, 2号, 3号]
// 出队
System.out.println(queue.removeFirst());//1号
System.out.println(queue.removeFirst());//2号
System.out.println(queue);//[3号]
// 做一个栈 先进后出
LinkedList<String> stack = new LinkedList<>();
// 压栈
stack.push("第1颗子弹");//addFirst(e);
stack.push("第2颗子弹");
stack.push("第3颗子弹");
System.out.println(stack); // [ 第3颗子弹, 第2颗子弹, 第1颗子弹]
// 弹栈
System.out.println(stack.pop());//removeFirst(); 第3颗子弹
System.out.println(stack.pop());
System.out.println(stack);// [第1颗子弹]
}
}源码
LinkedList 是一个实现了 List 接口的双端链表,支持高效的插入和删除操作,另外也实现了 Deque 接口,使得 LinkedList 类也具有队列的特性
核心方法:
-
使 LinkedList 变成线程安全的,可以调用静态类 Collections 类中的 synchronizedList 方法:
List list = Collections.synchronizedList(new LinkedList(...)); -
私有内部类 Node:这个类代表双端链表的节点 Node
private static class Node<E> { E item; Node<E> next; Node<E> prev; Node(Node<E> prev, E element, Node<E> next) { this.item = element; this.next = next; this.prev = prev; } } -
构造方法:只有无参构造和用已有的集合创建链表的构造方法
-
添加元素:默认加到尾部
public boolean add(E e) { linkLast(e); return true; } -
获取元素:
get(int index)根据指定索引返回数据- 获取头节点 (index=0):
getFirst()、element()、peek()、peekFirst()这四个获取头结点方法的区别在于对链表为空时的处理方式,是抛出异常还是返回NULL,其中getFirst() element()方法将会在链表为空时,抛出异常 - 获取尾节点 (index=-1):getLast() 方法在链表为空时,抛出 NoSuchElementException,而 peekLast() 不会,只会返回 null
- 获取头节点 (index=0):
-
删除元素:
- remove()、removeFirst()、pop():删除头节点
- removeLast()、pollLast():删除尾节点,removeLast()在链表为空时抛出NoSuchElementException,而pollLast()方法返回null
对比 ArrayList
- 是否保证线程安全:ArrayList 和 LinkedList 都是不同步的,也就是不保证线程安全
- 底层数据结构:
- Arraylist 底层使用的是
Object数组 - LinkedList 底层使用的是双向链表数据结构(JDK1.6 之前为循环链表,JDK1.7 取消了循环)
- Arraylist 底层使用的是
- 插入和删除是否受元素位置的影响:
- ArrayList 采用数组存储,所以插入和删除元素受元素位置的影响
- LinkedList采 用链表存储,所以对于
add(E e)方法的插入,删除元素不受元素位置的影响
- 是否支持快速随机访问:
- LinkedList 不支持高效的随机元素访问,ArrayList 支持
- 快速随机访问就是通过元素的序号快速获取元素对象(对应于
get(int index)方法)
- 内存空间占用:
- ArrayList 的空间浪费主要体现在在 list 列表的结尾会预留一定的容量空间
- LinkedList 的空间花费则体现在它的每一个元素都需要消耗比 ArrayList更多的空间(因为要存放直接后继和直接前驱以及数据)
Set
概述
Set 系列集合:
- HashSet:添加的元素是无序,不重复,无索引的
- LinkedHashSet:添加的元素是有序,不重复,无索引的
- TreeSet:不重复,无索引,按照大小默认升序排序
注意:没有索引,不能使用普通 for 循环遍历
HashSet
哈希值:
-
哈希值:JDK 根据对象的地址或者字符串或者数字计算出来的数值
-
获取哈希值:Object 类中的 public int hashCode()
-
哈希值的特点
- 同一个对象多次调用 hashCode() 方法返回的哈希值是相同的
- 默认情况下,不同对象的哈希值是不同的,而重写 hashCode() 方法,可以实现让不同对象的哈希值相同
HashSet 底层就是基于 HashMap 实现,值是 PRESENT = new Object()
Set 集合添加的元素是无序,不重复的。
-
是如何去重复的?
1.对于有值特性的,Set集合可以直接判断进行去重复。 2.对于引用数据类型的类对象,Set集合是按照如下流程进行是否重复的判断。 Set集合会让两两对象,先调用自己的hashCode()方法得到彼此的哈希值(所谓的内存地址) 然后比较两个对象的哈希值是否相同,如果不相同则直接认为两个对象不重复。 如果哈希值相同,会继续让两个对象进行equals比较内容是否相同,如果相同认为真的重复了 如果不相同认为不重复。 Set集合会先让对象调用hashCode()方法获取两个对象的哈希值比较 / \ false true / \ 不重复 继续让两个对象进行equals比较 / \ false true / \ 不重复 重复了 -
Set 系列集合元素无序的根本原因
Set 系列集合添加元素无序的根本原因是因为底层采用了哈希表存储元素。
- JDK 1.8 之前:哈希表 = 数组(初始容量16) + 链表 + (哈希算法)
- JDK 1.8 之后:哈希表 = 数组(初始容量16) + 链表 + 红黑树 + (哈希算法)
- 当链表长度超过阈值 8 且当前数组的长度 > 64时,将链表转换为红黑树,减少了查找时间
- 当链表长度超过阈值 8 且当前数组的长度 < 64时,扩容

每个元素的 hashcode() 的值进行响应的算法运算,计算出的值相同的存入一个数组块中,以链表的形式存储,如果链表长度超过8就采取红黑树存储,所以输出的元素是无序的。
-
如何设置只要对象内容一样,就希望集合认为重复:重写 hashCode 和 equals 方法
Linked
LinkedHashSet 为什么是有序的?
LinkedHashSet 底层依然是使用哈希表存储元素的,但是每个元素都额外带一个链来维护添加顺序,不光增删查快,还有顺序,缺点是多了一个存储顺序的链会占内存空间,而且不允许重复,无索引
TreeSet
TreeSet 集合自排序的方式:
- 有值特性的元素直接可以升序排序(浮点型,整型)
- 字符串类型的元素会按照首字符的编号排序
- 对于自定义的引用数据类型,TreeSet 默认无法排序,执行的时候报错,因为不知道排序规则
自定义的引用数据类型,TreeSet 默认无法排序,需要定制排序的规则,方案有 2 种:
-
直接为对象的类实现比较器规则接口 Comparable,重写比较方法:
方法:
public int compareTo(Employee o): this 是比较者, o 是被比较者* 比较者大于被比较者,返回正数 * 比较者小于被比较者,返回负数 * 比较者等于被比较者,返回 0 -
直接为集合设置比较器 Comparator 对象,重写比较方法:
方法:
public int compare(Employee o1, Employee o2): o1 比较者, o2 被比较者- 比较者大于被比较者,返回正数
- 比较者小于被比较者,返回负数
- 比较者等于被比较者,返回 0
注意:如果类和集合都带有比较规则,优先使用集合自带的比较规则
public class TreeSetDemo{
public static void main(String[] args){
Set<Student> students = new TreeSet<>();
Collections.add(students,s1,s2,s3);
System.out.println(students);//按照年龄比较 升序
Set<Student> s = new TreeSet<>(new Comparator<Student>(){
@Override
public int compare(Student o1, Student o2) {
// o1比较者 o2被比较者
return o2.getAge() - o1.getAge();//降序
}
});
}
}
public class Student implements Comparable<Student>{
private String name;
private int age;
// 重写了比较方法。
// e1.compareTo(o)
// 比较者:this
// 被比较者:o
// 需求:按照年龄比较 升序,年龄相同按照姓名
@Override
public int compareTo(Student o) {
int result = this.age - o.age;
return result == 0 ? this.getName().compareTo(o.getName):result;
}
}比较器原理:底层是以第一个元素为基准,加一个新元素,就会和第一个元素比,如果大于,就继续和大于的元素进行比较,直到遇到比新元素大的元素为止,放在该位置的左边(红黑树)
Queue
Queue:队列,先进先出的特性
PriorityQueue 是优先级队列,底层存储结构为 Object[],默认实现为小顶堆,每次出队最小的元素
构造方法:
-
public PriorityQueue():构造默认长度为 11 的队列(数组) -
public PriorityQueue(Comparator<? super E> comparator):利用比较器自定义堆排序的规则Queue<Integer> pq = new PriorityQueue<>((v1, v2) -> v2 - v1);//实现大顶堆
常用 API:
public boolean offer(E e):将指定的元素插入到此优先级队列的尾部public E poll():检索并删除此队列的头元素,如果此队列为空,则返回 nullpublic E peek():检索但不删除此队列的头,如果此队列为空,则返回 nullpublic boolean remove(Object o):从该队列中删除指定元素(如果存在),删除元素 e 使用 o.equals(e) 比较,如果队列包含多个这样的元素,删除第一个
Collections
java.utils.Collections:集合工具类,Collections 并不属于集合,是用来操作集合的工具类
Collections 有几个常用的API:
public static <T> boolean addAll(Collection<? super T> c, T... e):给集合对象批量添加元素public static void shuffle(List<?> list):打乱集合顺序public static <T> void sort(List<T> list):将集合中元素按照默认规则排序public static <T> void sort(List<T> list,Comparator<? super T> ):集合中元素按照指定规则排序public static <T> List<T> synchronizedList(List<T> list):返回由指定 list 支持的线程安全 listpublic static <T> Set<T> singleton(T o):返回一个只包含指定对象的不可变组
public class CollectionsDemo {
public static void main(String[] args) {
Collection<String> names = new ArrayList<>();
Collections.addAll(names,"张","王","李","赵");
List<Double> scores = new ArrayList<>();
Collections.addAll(scores, 98.5, 66.5 , 59.5 , 66.5 , 99.5 );
Collections.shuffle(scores);
Collections.sort(scores); // 默认升序排序!
System.out.println(scores);
List<Student> students = new ArrayList<>();
Collections.addAll(students,s1,s2,s3,s4);
Collections.sort(students,new Comparator<Student>(){
})
}
}
public class Student{
private String name;
private int age;
}