SYSTEM
Regex
src/content/notes/system/Regex.md Regex
概述
正则表达式的作用:是一些特殊字符组成的校验规则,可以校验信息的正确性,校验邮箱、电话号码、金额等。
比如检验 qq 号:
public static boolean checkQQRegex(String qq){
return qq!=null && qq.matches("\\d{4,}");//即是数字 必须大于4位数
}// 用\\d 是因为\用来告诉它是一个校验类,不是普通的字符 比如 \t \njava.util.regex 包主要包括以下三个类:
-
Pattern 类:
Pattern 对象是一个正则表达式的编译表示。Pattern 类没有公共构造方法,要创建一个 Pattern 对象,必须首先调用其公共静态编译方法,返回一个 Pattern 对象。该方法接受一个正则表达式作为它的第一个参数
-
Matcher 类:
Matcher 对象是对输入字符串进行解释和匹配操作的引擎。与Pattern 类一样,Matcher 也没有公共构造方法,需要调用 Pattern 对象的 matcher 方法来获得一个 Matcher 对象
-
PatternSyntaxException:
PatternSyntaxException 是一个非强制异常类,它表示一个正则表达式模式中的语法错误。
字符匹配
普通字符
字母、数字、汉字、下划线、以及没有特殊定义的标点符号,都是“普通字符”。表达式中的普通字符,在匹配一个字符串的时候,匹配与之相同的一个字符。其他统称元字符
特殊字符
\r\n 是 Windows 中的文本行结束标签,在 Unix/Linux 则是 \n
| 元字符 | 说明 |
|---|---|
| \ | 将下一个字符标记为一个特殊字符或原义字符,告诉它是一个校验类,不是普通字符 |
| \f | 换页符 |
| \n | 换行符 |
| \r | 回车符 |
| \t | 制表符 |
| \ | 代表 \ 本身 |
| () | 使用 () 定义一个子表达式。子表达式的内容可以当成一个独立元素 |
标准字符
能够与多种字符匹配的表达式,注意区分大小写,大写是相反的意思,只能校验单个字符。
| 元字符 | 说明 |
|---|---|
| . | 匹配任意一个字符(除了换行符),如果要匹配包括 \n 在内的所有字符,一般用 [\s\S] |
| \d | 数字字符,0~9 中的任意一个,等价于 [0-9] |
| \D | 非数字字符,等价于 [ ^0-9] |
| \w | 大小写字母或数字或下划线,等价于[a-zA-Z_0-9_] |
| \W | 对\w取非,等价于[ ^\w] |
| \s | 空格、制表符、换行符等空白字符的其中任意一个,等价于[\f\n\r\t\v] |
| \S | 对 \s 取非 |
\x 匹配十六进制字符,\0 匹配八进制,例如 \xA 对应值为 10 的 ASCII 字符 ,即 \n
自定义符
自定义符号集合,[ ] 方括号匹配方式,能够匹配方括号中任意一个字符
| 元字符 | 说明 |
|---|---|
| [ab5@] | 匹配 “a” 或 “b” 或 “5” 或 ”@” |
| [^abc] | 匹配 “a”,“b”,“c” 之外的任意一个字符 |
| [f-k] | 匹配 “f”~“k” 之间的任意一个字母 |
| [^A-F0-3] | 匹配 “A”,“F”,“0”~“3” 之外的任意一个字符 |
| [a-d[m-p]] | 匹配 a 到 d 或者 m 到 p:[a-dm-p](并集) |
| [a-z&&[m-p]] | 匹配 a 到 z 并且 m 到 p:[a-dm-p](交集) |
| [^] | 取反 |
-
正则表达式的特殊符号,被包含到中括号中,则失去特殊意义,除了 ^,- 之外,需要在前面加 \
-
标准字符集合,除小数点外,如果被包含于中括号,自定义字符集合将包含该集合。 比如:[\d. \ -+] 将匹配:数字、小数点、+、-
量词字符
修饰匹配次数的特殊符号。
- 匹配次数中的贪婪模式(匹配字符越多越好,默认 !),* 和 + 都是贪婪型元字符。
- 匹配次数中的非贪婪模式(匹配字符越少越好,修饰匹配次数的特殊符号后再加上一个 ? 号)
| 元字符 | 说明 |
|---|---|
| X? | X 一次或一次也没,有相当于 {0,1} |
| X* | X 不出现或出现任意次,相当于 {0,} |
| X+ | X 至少一次,相当于 {1,} |
| X{n} | X 恰好 n 次 |
| {n,} | X 至少 n 次 |
| {n,m} | X 至少 n 次,但是不超过 m 次 |
位置匹配
字符边界
本组标记匹配的不是字符而是位置,符合某种条件的位置
| 元字符 | 说明 |
|---|---|
| ^ | 与字符串开始的地方匹配(在字符集合中用来求非,在字符集合外用作匹配字符串的开头) |
| $ | 与字符串结束的地方匹配 |
| \b | 匹配一个单词边界 |
捕获组
捕获组是把多个字符当一个单独单元进行处理的方法,它通过对括号内的字符分组来创建。
在表达式 ((A)(B(C))),有四个这样的组:((A)(B(C)))、(A)、(B(C))、(C)(按照括号从左到右依次为 group(1)…)
- 调用 matcher 对象的 groupCount 方法返回一个 int 值,表示 matcher 对象当前有多个捕获组。
- 特殊的组 group(0)、group(),代表整个表达式,该组不包括在 groupCount 的返回值中。
| 表达式 | 说明 |
|---|---|
| | (分支结构) | 左右两边表达式之间 “或” 关系,匹配左边或者右边 |
| () (捕获组) | (1) 在被修饰匹配次数的时候,括号中的表达式可以作为整体被修饰 (2) 取匹配结果的时候,括号中的表达式匹配到的内容可以被单独得到 (3) 每一对括号分配一个编号,()的捕获根据左括号的顺序从 1 开始自动编号。捕获元素编号为零的第一个捕获是由整个正则表达式模式匹配的文本 |
| (?:Expression) 非捕获组 | 一些表达式中,不得不使用( ),但又不需要保存 () 中子表达式匹配的内容,这时可以用非捕获组来抵消使用( )带来的副作用。 |
反向引用
反向引用(\number),又叫回溯引用:
-
每一对()会分配一个编号,使用 () 的捕获根据左括号的顺序从1开始自动编号
-
通过反向引用,可以对分组已捕获的字符串进行引用,继续匹配
-
把匹配到的字符重复一遍在进行匹配
-
应用 1:
String regex = "((\d)3)\1[0-9](\w)\2{2}";- 首先匹配 ((\d)3),其次 \1 匹配 ((\d)3) 已经匹配到的内容,\2 匹配 (\d), {2} 指的是 \2 的值出现两次
- 实例:23238n22(匹配到 2 未来就继续匹配 2)
- 实例:43438n44
-
应用 2:爬虫
String regex = "<(h[1-6])>\w*?<\/\1>";匹配结果
<h1>x</h1>//匹配 <h2>x</h2>//匹配 <h3>x</h1>//不匹配
零宽断言
预搜索(零宽断言)(环视)
-
只进行子表达式的匹配,匹配内容不计入最终的匹配结果,是零宽度
-
判断当前位置的前后字符,是否符合指定的条件,但不匹配前后的字符,是对位置的匹配
-
正则表达式匹配过程中,如果子表达式匹配到的是字符内容,而非位置,并被保存到最终的匹配结果中,那么就认为这个子表达式是占有字符的;如果子表达式匹配的仅仅是位置,或者匹配的内容并不保存到最终的匹配结果中,那么就认为这个子表达式是零宽度的。占有字符还是零宽度,是针对匹配的内容是否保存到最终的匹配结果中而言的
表达式 说明 (?=exp) 断言自身出现的位置的后面能匹配表达式exp (?<=exp) 断言自身出现的位置的前面能匹配表达式exp (?!exp) 断言此位置的后面不能匹配表达式exp (?<!exp) 断言此位置的前面不能匹配表达式exp
匹配模式
正则表达式的匹配模式:
- IGNORECASE 忽略大小写模式
- 匹配时忽略大小写。
- 默认情况下,正则表达式是要区分大小写的。
- SINGLELINE 单行模式
- 整个文本看作一个字符串,只有一个开头,一个结尾。
- 使小数点 ”.” 可以匹配包含换行符(\n)在内的任意字符。
- MULTILINE 多行模式
- 每行都是一个字符串,都有开头和结尾。
- 在指定了 MULTILINE 之后,如果需要仅匹配字符串开始和结束位置,可以使用 \A 和 \Z
分组匹配
Pattern 类:
static Pattern compile(String regex):将给定的正则表达式编译为模式Matcher matcher(CharSequence input):创建一个匹配器,匹配给定的输入与此模式static boolean matches(String regex, CharSequence input):编译正则表达式,并匹配输入
Matcher 类:
boolean find():扫描输入的序列,查找与该模式匹配的下一个子序列String group():返回与上一个匹配的输入子序列,同 group(0),匹配整个表达式的子字符串String group(int group):返回在上一次匹配操作期间由给定组捕获的输入子序列int groupCount():返回此匹配器模式中捕获组的数量
public class Demo01{
public static void main(String[] args) {
//表达式对象
Pattern p = Pattern.compile("\\w+");
//创建Matcher对象
Matcher m = p.matcher("asfsdf2&&3323");
//boolean b = m.matches();//尝试将整个字符序列与该模式匹配
//System.out.println(b);//false
//boolean b2 = m.find();//该方法扫描输入的序列,查找与该模式匹配的下一个子序列
//System.out.println(b2);//true
//System.out.println(m.find());
//System.out.println(m.group());//asfsdf2
//System.out.println(m.find());
//System.out.println(m.group());//3323
while(m.find()){
System.out.println(m.group()); //group(),group(0)匹配整个表达式的子字符串
System.out.println(m.group(0));
}
}
}public class Demo02 {
public static void main(String[] args) {
//在这个字符串:asfsdf23323,是否符合指定的正则表达式:\w+
//表达式对象
Pattern p = Pattern.compile("(([a-z]+)([0-9]+))");//不需要加多余的括号
//创建Matcher对象
Matcher m = p.matcher("aa232**ssd445");
while(m.find()){
System.out.println(m.group());//aa232 ssd445
System.out.println(m.group(1));//aa232 ssd445
System.out.println(m.group(2));//aa ssd
System.out.println(m.group(3));//232 445
}
}
}- 正则表达式改为
"(([a-z]+)(?:[0-9]+))"没有 group(3) 因为是非捕获组 - 正则表达式改为
"([a-z]+)([0-9]+)"没有 group(3) aa232 - aa —232
应用
基本验证
public static void main(String[] args){
System.out.println("a".matches("[abc]"));//true判断a是否在abc
System.out.println("a".matches("[^abc]"));//false 判断a是否在abc之外的
System.out.println("a".matches("\\d")); //false 是否a是整数
System.out.println("a".matches("\\w")); //true 是否是字符
System.out.println("你".matches("\\w")); // false
System.out.println("aa".matches("\\w"));//false 只能检验单个字符
// 密码 必须是数字 字母 下划线 至少 6位
System.out.println("ssds3c".matches("\\w{6,}")); // true
// 验证。必须是数字和字符 必须是4位
System.out.println("dsd22".matches("[a-zA-Z0-9]{4}")); // false
System.out.println("A3dy".matches("[a-zA-Z0-9]{4}")); // true
}验证号码
//1开头 第二位是2-9的数字
public static void checkPhone(String phone){
if(phone.matches("1[3-9]\\d{9}")){
System.out.println("手机号码格式正确!");
} else {.......}
}
//[邮箱已隐藏] [邮箱已隐藏]
public static void checkEmail(String email){
if(email.matches("\\w{1,}@\\w{1,}(\\.\\w{2,5}){1,2}")){
System.out.println("邮箱格式正确!");
}// .是任意字符 \\.就是点
}查找替换
public String[] split(String regex):按照正则表达式匹配的内容进行分割字符串,反回一个字符串数组public String replaceAll(String regex,String newStr):按照正则表达式匹配的内容进行替换
//数组分割
public static void main(String[] args) {
// 1.split的基础用法
String names = "风清扬,张无忌,周芷若";
// 以“,”分割成字符串数组
String[] nameArrs = names.split(",");
// 2.split集合正则表达式做分割
String names1 = "风清扬lv434fda324张无忌87632fad2342423周芷若";
// 以匹配正则表达式的内容为分割点分割成字符串数组
String[] nameArrs1 = names1.split("\\w+");
// 使用正则表达式定位出内容,替换成/
System.out.println(names1.replaceAll("\\w+","/"));//风清扬/张无忌/周芷若
String names3 = "风清扬,张无忌,周芷若";
System.out.println(names3.replaceAll(",","-"));//风清扬-张无忌-周芷若
}搜索号码
找出所有 189 和 132 开头的手机号
public class RegexDemo {
public static void main(String[] args) {
String rs = "189asjk65as1891898777745gkkkk189745612318936457894";
String regex = "(?=((189|132)\\d{8}))";
Pattern pattern = Pattern.compile(regex);
Matcher matcher = pattern.matcher(rs);
while (matcher.find()) {
System.out.println(matcher.group(1));
}
}
}集合
集合概述
集合是一个大小可变的容器,容器中的每个数据称为一个元素
集合特点:类型可以不确定,大小不固定;集合有很多,不同的集合特点和使用场景不同
数组:类型和长度一旦定义出来就都固定
作用:
- 在开发中,很多时候元素的个数是不确定的
- 而且经常要进行元素的增删该查操作,集合都是非常合适的,开发中集合用的更多
存储结构
数据结构指的是数据以什么方式组织在一起,不同的数据结构,增删查的性能是不一样的
数据存储的常用结构有:栈、队列、数组、链表和红黑树
-
队列(queue):先进先出,后进后出。(FIFO first in first out)
-
栈(stack):后进先出,先进后出 (LIFO)
-
数组:数组是内存中的连续存储区域,分成若干等分的小区域(每个区域大小是一样的)元素存在索引
特点:查询元素快(根据索引快速计算出元素的地址,然后立即去定位),增删元素慢(创建新数组,迁移元素)
-
链表:元素不是内存中的连续区域存储,元素是游离存储的,每个元素会记录下个元素的地址 特点:查询元素慢,增删元素快(针对于首尾元素,速度极快,一般是双链表)
-
树:
-
二叉树:binary tree 永远只有一个根节点,是每个结点不超过2个节点的树(tree)
特点:二叉排序树:小的左边,大的右边,但是可能树很高,性能变差,为了做排序和搜索会进行左旋和右旋实现平衡查找二叉树,让树的高度差不大于1
-
红黑树(基于红黑规则实现自平衡的排序二叉树):树保证到了很矮小,但是又排好序,性能最高的
特点:红黑树的增删查改性能都好
-
各数据结构时间复杂度对比:
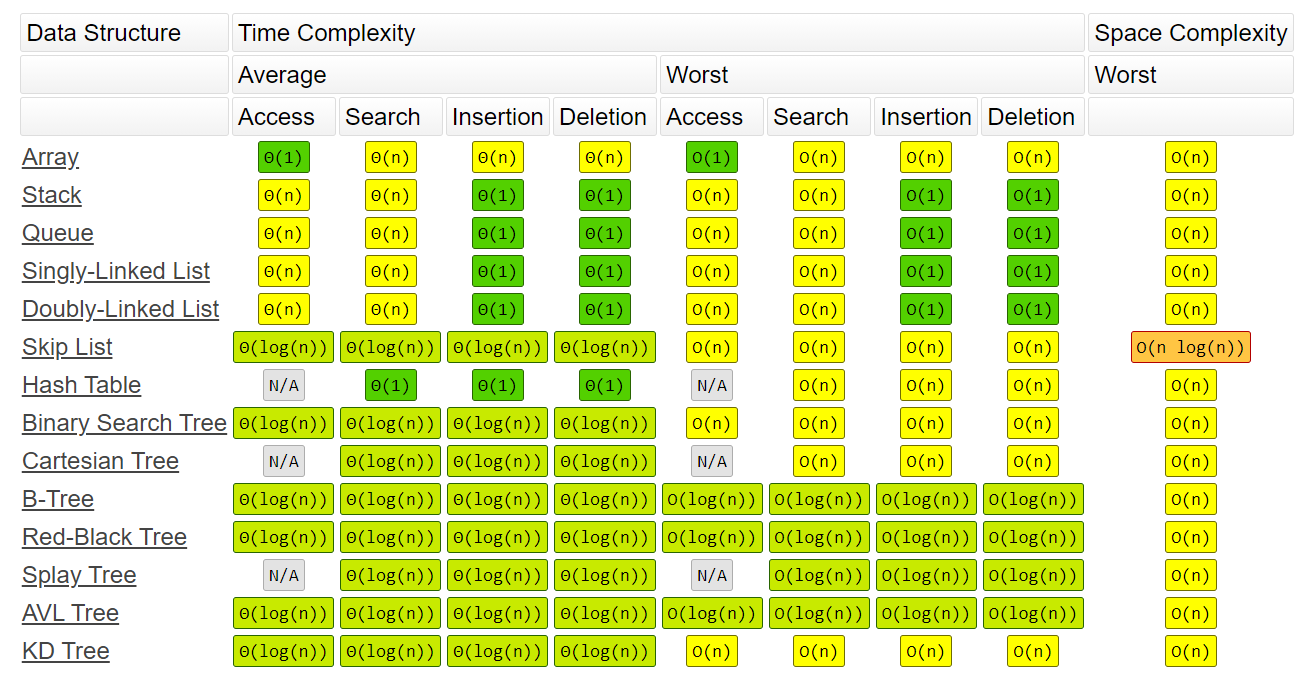
图片来源:https://www.bigocheatsheet.com/