SYSTEM
字典树
src/content/notes/system/字典树.md 字典树
基本介绍
Trie 树,也叫字典树,是一种专门处理字符串匹配的树形结构,用来解决在一组字符串集合中快速查找某个字符串的问题,Trie 树的本质就是利用字符串之间的公共前缀,将重复的前缀合并在一起
- 根节点不包含任何信息
- 每个节点表示一个字符串中的字符,从根节点到红色节点的一条路径表示一个字符串
- 红色节点并不都是叶子节点
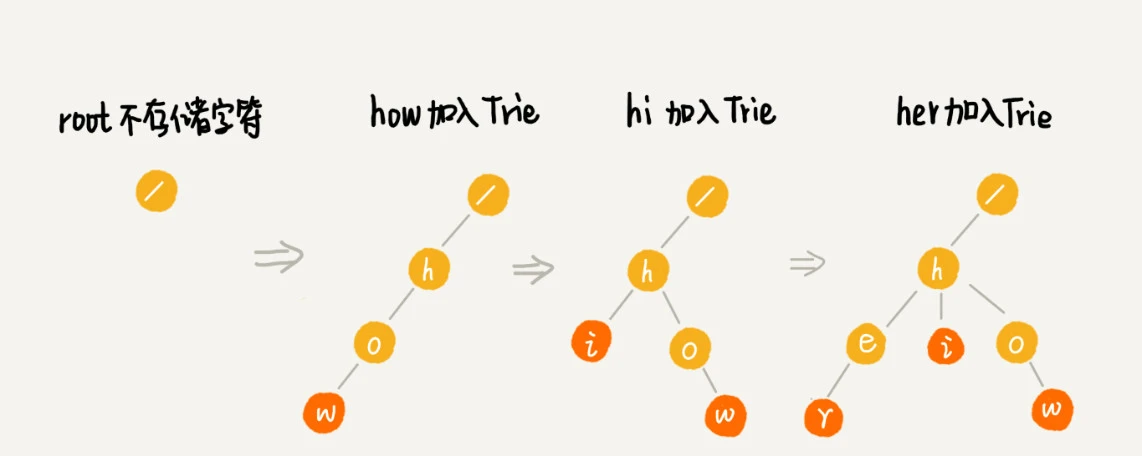

注意:要查找的是字符串“he”,从根节点开始,沿着某条路径来匹配,可以匹配成功。但是路径的最后一个节点“e”并不是红色的,也就是说,“he”是某个字符串的前缀子串,但并不能完全匹配任何字符串
实现Trie
通过一个下标与字符一一映射的数组,来存储子节点的指针
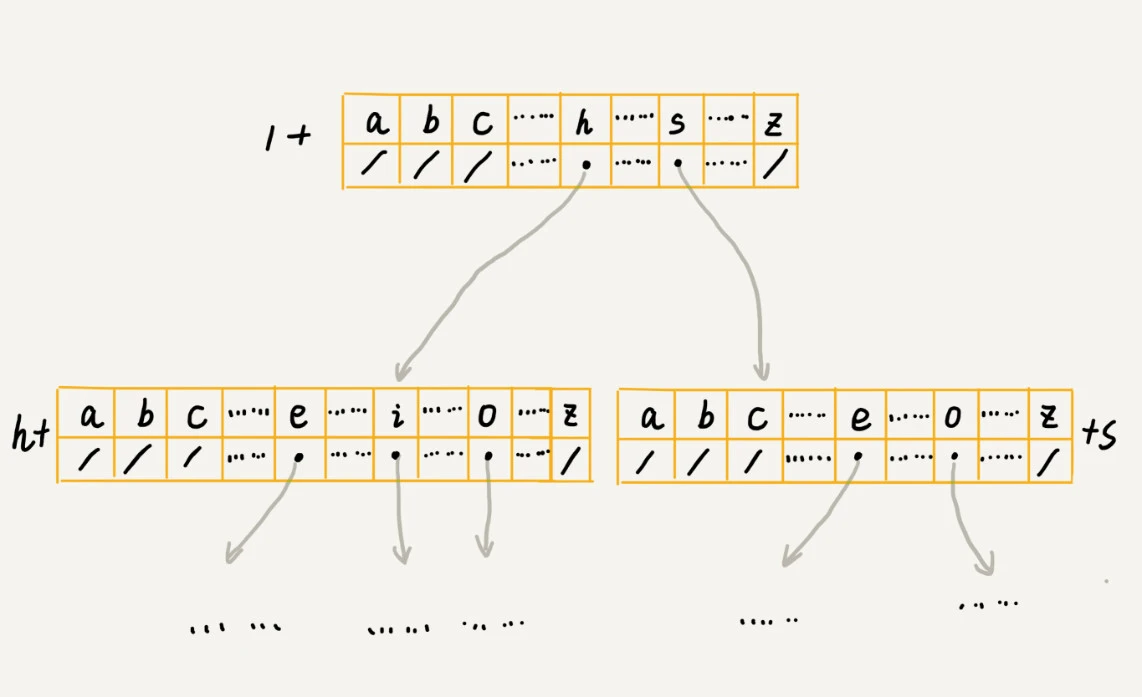
时间复杂度是 O(n)(n 表示要查找字符串的长度)
public class Trie {
private TrieNode root = new TrieNode('/');
//插入一个字符
public void insert(char[] chars) {
TrieNode p = root;
for (int i = 0; i < chars.length; i++) {
//获取字符的索引位置
int index = chars[i] - 'a';
if (p.children[index] == null) {
TrieNode node = new TrieNode(chars[i]);
p.children[index] = node;
}
p = p.children[index];
}
p.isEndChar = true;
}
//查找一个字符串
public boolean find(char[] chars) {
TrieNode p = root;
for (int i = 0; i < chars.length; i++) {
int index = chars[i] - 'a';
if (p.children[index] == null) {
return false;
}
p = p.children[index];
}
if (p.isEndChar) {
//完全匹配
return true;
} else {
// 不能完全匹配,只是前缀
return false;
}
}
private class TrieNode {
char data;
TrieNode[] children = new TrieNode[26];//26个英文字母
boolean isEndChar = false;//结尾字符为true
public TrieNode(char data) {
this.data = data;
}
}
}优化Trie
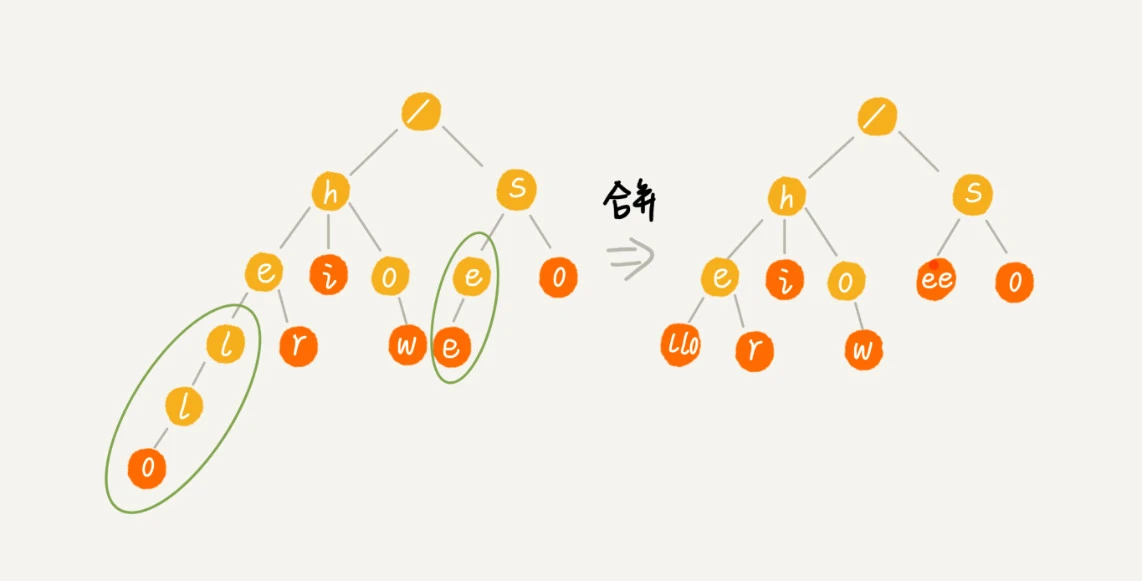
Trie 树是非常耗内存,采取空间换时间的思路。Trie 树的变体有很多,可以在一定程度上解决内存消耗的问题。比如缩点优化,对只有一个子节点的节点,而且此节点不是一个串的结束节点,可以将此节点与子节点合并
参考文章:https://time.geekbang.org/column/article/72414