SYSTEM
序列化
src/content/notes/system/序列化.md 序列化
普通方式
序列化,反序列化主要用在消息正文的转换上
- 序列化时,需要将 Java 对象变为要传输的数据(可以是 byte[],或 json 等,最终都需要变成 byte[])
- 反序列化时,需要将传入的正文数据还原成 Java 对象,便于处理
代码实现:
-
抽象一个 Serializer 接口
public interface Serializer { // 反序列化方法 <T> T deserialize(Class<T> clazz, byte[] bytes); // 序列化方法 <T> byte[] serialize(T object); } -
提供两个实现
enum SerializerAlgorithm implements Serializer { // Java 实现 Java { @Override public <T> T deserialize(Class<T> clazz, byte[] bytes) { try { ObjectInputStream in = new ObjectInputStream(new ByteArrayInputStream(bytes)); Object object = in.readObject(); return (T) object; } catch (IOException | ClassNotFoundException e) { throw new RuntimeException("SerializerAlgorithm.Java 反序列化错误", e); } } @Override public <T> byte[] serialize(T object) { try { ByteArrayOutputStream out = new ByteArrayOutputStream(); new ObjectOutputStream(out).writeObject(object); return out.toByteArray(); } catch (IOException e) { throw new RuntimeException("SerializerAlgorithm.Java 序列化错误", e); } } }, // Json 实现(引入了 Gson 依赖) Json { @Override public <T> T deserialize(Class<T> clazz, byte[] bytes) { return new Gson().fromJson(new String(bytes, StandardCharsets.UTF_8), clazz); } @Override public <T> byte[] serialize(T object) { return new Gson().toJson(object).getBytes(StandardCharsets.UTF_8); } }; // 需要从协议的字节中得到是哪种序列化算法 public static SerializerAlgorithm getByInt(int type) { SerializerAlgorithm[] array = SerializerAlgorithm.values(); if (type < 0 || type > array.length - 1) { throw new IllegalArgumentException("超过 SerializerAlgorithm 范围"); } return array[type]; } }
ProtoBuf
基本介绍
Codec(编解码器)的组成部分有两个:Decoder(解码器)和 Encoder(编码器)。Encoder 负责把业务数据转换成字节码数据,Decoder 负责把字节码数据转换成业务数据
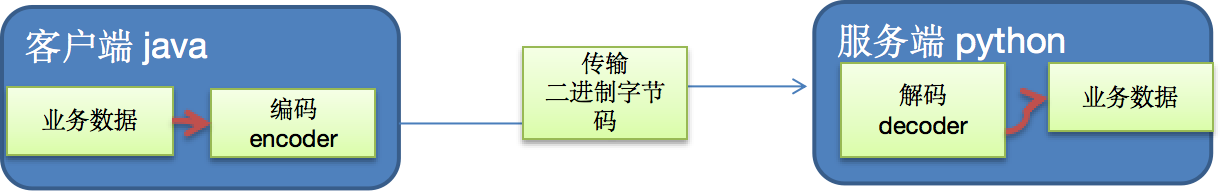
Protobuf 是 Google 发布的开源项目,全称 Google Protocol Buffers ,是一种轻便高效的结构化数据存储格式,可以用于结构化数据串行化,或者说序列化。很适合做数据存储或 RPC(远程过程调用 remote procedure call)数据交换格式。目前很多公司从 HTTP + Json 转向 TCP + Protobuf ,效率会更高
Protobuf 是以 message 的方式来管理数据,支持跨平台、跨语言(客户端和服务器端可以是不同的语言编写的),高性能、高可靠性
工作过程:使用 Protobuf 编译器自动生成代码,Protobuf 是将类的定义使用 .proto 文件进行描述,然后通过 protoc.exe 编译器根据 .proto 自动生成 .java 文件
代码实现
-
单个 message:
syntax = "proto3"; // 版本 option java_outer_classname = "StudentPOJO"; // 生成的外部类名,同时也是文件名 message Student { // 在 StudentPOJO 外部类种生成一个内部类 Student,是真正发送的 POJO 对象 int32 id = 1; // Student 类中有一个属性:名字为 id 类型为 int32(protobuf类型) ,1表示属性序号,不是值 string name = 2; }
编译
protoc.exe --java_out=.Student.proto(cmd 窗口输入) 将生成的 StudentPOJO 放入到项目使用Server 端:
new ServerBootstrap() //... .childHandler(new ChannelInitializer<SocketChannel>() { // 创建一个通道初始化对象 // 给pipeline 设置处理器 @Override protected void initChannel(SocketChannel ch) throws Exception { // 在pipeline加入ProtoBufDecoder,指定对哪种对象进行解码 ch.pipeline().addLast("decoder", new ProtobufDecoder( StudentPOJO.Student.getDefaultInstance())); ch.pipeline().addLast(new NettyServerHandler()); } }); }Client 端:
new Bootstrap().group(group) // 设置线程组 .channel(NioSocketChannel.class) // 设置客户端通道的实现类(反射) .handler(new ChannelInitializer<SocketChannel>() { @Override protected void initChannel(SocketChannel ch) throws Exception { // 在pipeline中加入 ProtoBufEncoder ch.pipeline().addLast("encoder", new ProtobufEncoder()); ch.pipeline().addLast(new NettyClientHandler()); // 加入自定义的业务处理器 } }); -
多个 message:Protobuf 可以使用 message 管理其他的 message。假设某个项目需要传输 20 个对象,可以在一个文件里定义 20 个 message,最后再用一个总的 message 来决定在实际传输时真正需要传输哪一个对象
syntax = "proto3"; option optimize_for = SPEED; // 加快解析 option java_package="com.atguigu.netty.codec2"; // 指定生成到哪个包下 option java_outer_classname="MyDataInfo"; // 外部类名, 文件名 message MyMessage { // 定义一个枚举类型,DataType 如果是 0 则表示一个 Student 对象实例,DataType 这个名称自定义 enum DataType { StudentType = 0; //在 proto3 要求 enum 的编号从 0 开始 WorkerType = 1; } // 用 data_type 来标识传的是哪一个枚举类型,这里才真正开始定义 Message 的数据类型 DataType data_type = 1; // 所有后面的数字都只是编号而已 // oneof 关键字,表示每次枚举类型进行传输时,限制最多只能传输一个对象。 // dataBody名称也是自定义的 // MyMessage 里出现的类型只有两个 DataType 类型,Student 或者 Worker 类型,在真正传输的时候只会有一个出现 oneof dataBody { Student student = 2; //注意这后面的数字也都只是编号而已,上面DataType data_type = 1 占了第一个序号了 Worker worker = 3; } } message Student { int32 id = 1; // Student类的属性 string name = 2; // } message Worker { string name=1; int32 age=2; }编译:
Server 端:
ch.pipeline().addLast("decoder", new ProtobufDecoder(MyDataInfo.MyMessage.getDefaultInstance()));Client 端:
pipeline.addLast("encoder", new ProtobufEncoder());