SYSTEM
hash
src/content/notes/system/hash.md hash
简介
数据存储需求:对一系列存储的数据进行编组,方便管理,典型应用存储对象信息
数据存储结构:一个存储空间保存多个键值对数据
hash 类型:底层使用哈希表结构实现数据存储
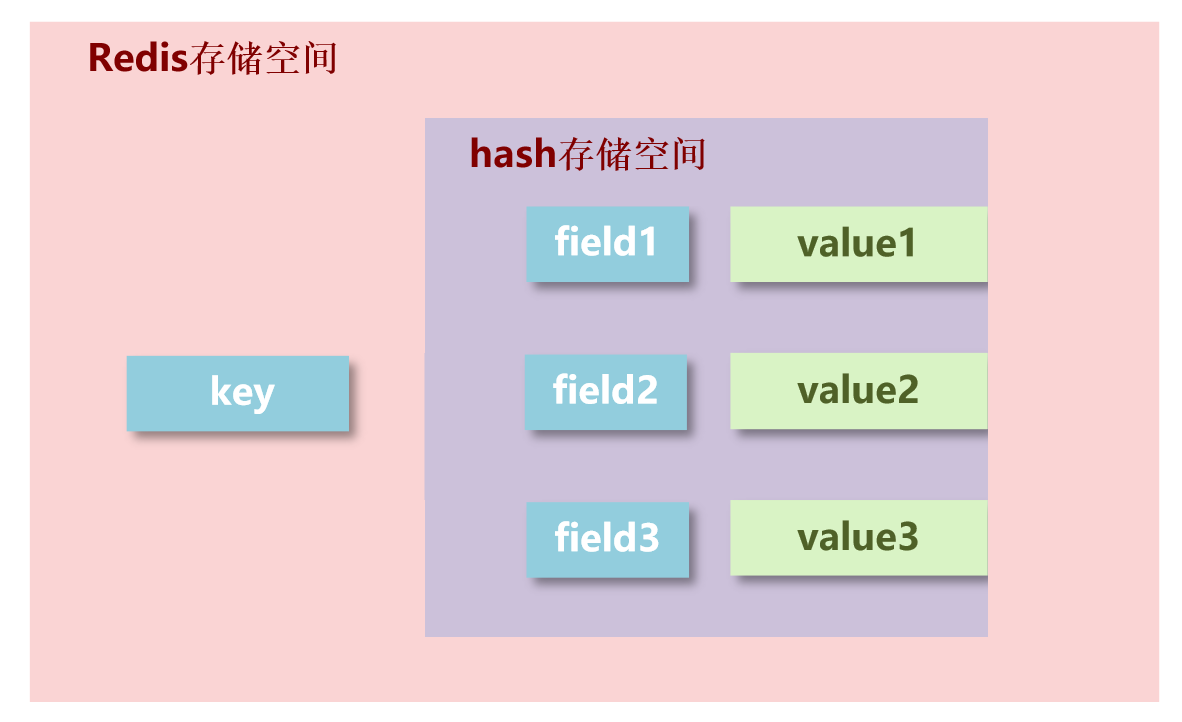
Redis 中的 hash 类似于 Java 中的 Map<String, Map<Object,object>>,左边是 key,右边是值,中间叫 field 字段,本质上 hash 存了一个 key-value 的存储空间
hash 是指的一个数据类型,并不是一个数据
- 如果 field 数量较少,存储结构优化为压缩列表结构(有序)
- 如果 field 数量较多,存储结构使用 HashMap 结构(无序)
操作
指令操作:
-
数据操作
hset key field value #添加/修改数据 hdel key field1 [field2] #删除数据,[]代表可选 hsetnx key field value #设置field的值,如果该field存在则不做任何操作 hmset key f1 v1 f2 v2... #添加/修改多个数据 -
查询操作
hget key field #获取指定field对应数据 hgetall key #获取指定key所有数据 hmget key field1 field2... #获取多个数据 hexists key field #获取哈希表中是否存在指定的字段 hlen key #获取哈希表中字段的数量 -
获取哈希表中所有的字段名或字段值
hkeys key #获取所有的field hvals key #获取所有的value -
设置指定字段的数值数据增加指定范围的值
hincrby key field increment #指定字段的数值数据增加指定的值,increment为负数则减少 hincrbyfloat key field increment#操作小数
注意事项
- hash 类型中 value 只能存储字符串,不允许存储其他数据类型,不存在嵌套现象,如果数据未获取到,对应的值为(nil)
- 每个 hash 可以存储 2^32 - 1 个键值对
- hash 类型和对象的数据存储形式相似,并且可以灵活添加删除对象属性。但 hash 设计初衷不是为了存储大量对象而设计的,不可滥用,不可将 hash 作为对象列表使用
- hgetall 操作可以获取全部属性,如果内部 field 过多,遍历整体数据效率就很会低,有可能成为数据访问瓶颈
实现
哈希对象的内部编码有两种:ziplist(压缩列表)、hashtable(哈希表、字典)
-
压缩列表实现哈希对象:同一键值对的节点总是挨在一起,保存键的节点在前,保存值的节点在后

-
字典实现哈希对象:字典的每一个键都是一个字符串对象,每个值也是

当存储的数据量比较小的情况下,Redis 才使用压缩列表来实现字典类型,具体需要满足两个条件:
- 当键值对数量小于 hash-max-ziplist-entries 配置(默认 512 个)
- 所有键和值的长度都小于 hash-max-ziplist-value 配置(默认 64 字节)
以上两个条件的上限值是可以通过配置文件修改的,当两个条件的任意一个不能被满足时,对象的编码转换操作就会被执行
ziplist 使用更加紧凑的结构实现多个元素的连续存储,所以在节省内存方面比 hashtable 更加优秀,当 ziplist 无法满足哈希类型时,Redis 会使用 hashtable 作为哈希的内部实现,因为此时 ziplist 的读写效率会下降,而 hashtable 的读写时间复杂度为 O(1)
应用
user:id:3506728370 → {"name":"春晚","fans":12210862,"blogs":83}对于以上数据,使用单条去存的话,存的条数会很多。但如果用 json 格式,存一条数据就够了。
假如现在粉丝数量发生了变化,要把整个值都改变,但是用单条存就不存在这个问题,只需要改其中一个就可以

可以实现购物车的功能,key 对应着每个用户,存储空间存储购物车的信息