SYSTEM
对象访存
src/content/notes/system/对象访存.md 类加载
对象访存
存储结构
一个 Java 对象内存中存储为三部分:对象头(Header)、实例数据(Instance Data)和对齐填充 (Padding)
对象头:
-
普通对象:分为两部分
-
Mark Word:用于存储对象自身的运行时数据, 如哈希码(HashCode)、GC 分代年龄、锁状态标志、线程持有的锁、偏向线程ID、偏向时间戳等等
hash(25) + age(4) + lock(3) = 32bit #32位系统 unused(25+1) + hash(31) + age(4) + lock(3) = 64bit #64位系统 -
Klass Word:类型指针,指向该对象的 Class 类对象的指针,虚拟机通过这个指针来确定这个对象是哪个类的实例;在 64 位系统中,开启指针压缩(-XX:+UseCompressedOops)或者 JVM 堆的最大值小于 32G,这个指针也是 4byte,否则是 8byte(就是 Java 中的一个引用的大小)
|-----------------------------------------------------| | Object Header (64 bits) | |---------------------------|-------------------------| | Mark Word (32 bits) | Klass Word (32 bits) | |---------------------------|-------------------------| -
-
数组对象:如果对象是一个数组,那在对象头中还有一块数据用于记录数组长度(12 字节)
|-------------------------------------------------------------------------------| | Object Header (96 bits) | |-----------------------|-----------------------------|-------------------------| | Mark Word(32bits) | Klass Word(32bits) | array length(32bits) | |-----------------------|-----------------------------|-------------------------|
实例数据:实例数据部分是对象真正存储的有效信息,也是在程序代码中所定义的各种类型的字段内容,无论是从父类继承下来的,还是在子类中定义的,都需要记录起来
对齐填充:Padding 起占位符的作用。64 位系统,由于 HotSpot VM 的自动内存管理系统要求对象起始地址必须是 8 字节的整数倍,就是对象的大小必须是 8 字节的整数倍,而对象头部分正好是 8 字节的倍数(1 倍或者 2 倍),因此当对象实例数据部分没有对齐时,就需要通过对齐填充来补全
32 位系统:
-
一个 int 在 java 中占据 4byte,所以 Integer 的大小为:
private final int value;# 需要补位4byte 4(Mark Word) + 4(Klass Word) + 4(data) + 4(Padding) = 16byte -
int[] arr = new int[10]# 由于需要8位对齐,所以最终大小为56byte 4(Mark Word) + 4(Klass Word) + 4(length) + 4*10(10个int大小) + 4(Padding) = 56sbyte
实际大小
浅堆(Shallow Heap):对象本身占用的内存,不包括内部引用对象的大小,32 位系统中一个对象引用占 4 个字节,每个对象头占用 8 个字节,根据堆快照格式不同,对象的大小会同 8 字节进行对齐
JDK7 中的 String:2个 int 值共占 8 字节,value 对象引用占用 4 字节,对象头 8 字节,对齐后占 24 字节,为 String 对象的浅堆大小,与 value 实际取值无关,无论字符串长度如何,浅堆大小始终是 24 字节
private final char value[];
private int hash;
private int hash32;保留集(Retained Set):对象 A 的保留集指当对象 A 被垃圾回收后,可以被释放的所有的对象集合(包括 A 本身),所以对象 A 的保留集就是只能通过对象 A 被直接或间接访问到的所有对象的集合,就是仅被对象 A 所持有的对象的集合
深堆(Retained Heap):指对象的保留集中所有的对象的浅堆大小之和,一个对象的深堆指只能通过该对象访问到的(直接或间接)所有对象的浅堆之和,即对象被回收后,可以释放的真实空间
对象的实际大小:一个对象所能触及的所有对象的浅堆大小之和,也就是通常意义上我们说的对象大小
下图显示了一个简单的对象引用关系图,对象 A 引用了 C 和 D,对象 B 引用了 C 和 E。那么对象 A 的浅堆大小只是 A 本身,A 的实际大小为 A、C、D 三者之和,A 的深堆大小为 A 与 D 之和,由于对象 C 还可以通过对象 B 访问到 C,因此 C 不在对象 A 的深堆范围内

内存分析工具 MAT 提供了一种叫支配树的对象图,体现了对象实例间的支配关系
基本性质:
-
对象 A 的子树(所有被对象 A 支配的对象集合)表示对象 A 的保留集(retained set),即深堆
-
如果对象 A 支配对象 B,那么对象 A 的直接支配者也支配对象 B
-
支配树的边与对象引用图的边不直接对应
左图表示对象引用图,右图表示左图所对应的支配树:
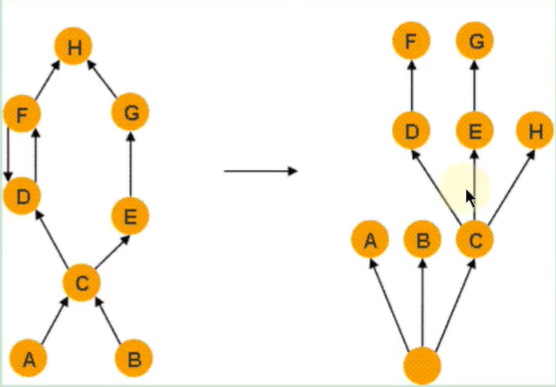
比如:对象 F 与对象 D 相互引用,因为到对象 F 的所有路径必然经过对象 D,因此对象 D 是对象 F 的直接支配者
参考文章:https://www.yuque.com/u21195183/jvm/nkq31c
节约内存
-
尽量使用基本数据类型
-
满足容量前提下,尽量用小字段
-
尽量用数组,少用集合,数组中是可以使用基本类型的,但是集合中只能放包装类型,如果需要使用集合,推荐比较节约内存的集合工具:fastutil
一个 ArrayList 集合,如果里面放了 10 个数字,占用多少内存:
private transient Object[] elementData; private int size;Mark Word 占 4byte,Klass Word 占 4byte,一个 int 字段占 4byte,elementData 数组占 12byte,数组中 10 个 Integer 对象占 10×16,所以整个集合空间大小为 184byte(深堆)
-
时间用 long/int 表示,不用 Date 或者 String
对象访问
JVM 是通过栈帧中的对象引用访问到其内部的对象实例:
-
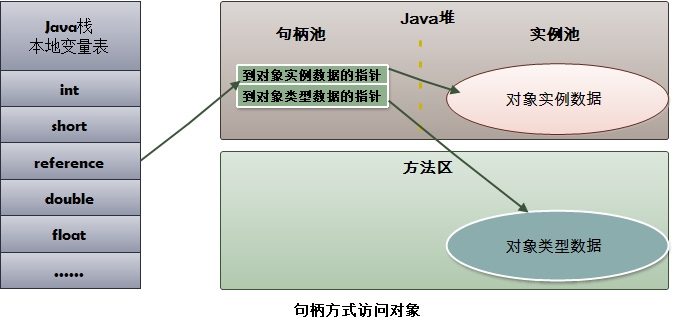
句柄访问:Java 堆中会划分出一块内存来作为句柄池,reference 中存储的就是对象的句柄地址,而句柄中包含了对象实例数据和类型数据各自的具体地址信息
优点:reference 中存储的是稳定的句柄地址,在对象被移动(垃圾收集)时只会改变句柄中的实例数据指针,而 reference 本身不需要被修改
-
直接指针(HotSpot 采用):Java 堆对象的布局必须考虑如何放置访问类型数据的相关信息,reference 中直接存储的对象地址
优点:速度更快,节省了一次指针定位的时间开销
缺点:对象被移动时(如进行 GC 后的内存重新排列),对象的 reference 也需要同步更新

参考文章:https://www.cnblogs.com/afraidToForget/p/12584866.html