SYSTEM
常见问题
src/content/notes/system/常见问题.md 常见问题
重启恢复
系统不断运行,master 的数据量会越来越大,一旦 master 重启,runid 将发生变化,会导致全部 slave 的全量复制操作
解决方法:本机保存上次 runid,重启后恢复该值,使所有 slave 认为还是之前的 master
优化方案:
-
master 内部创建 master_replid 变量,使用 runid 相同的策略生成,并发送给所有 slave
-
在 master 关闭时执行命令
shutdown save,进行 RDB 持久化,将 runid 与 offset 保存到 RDB 文件中redis-check-rdb dump.rdb命令可以查看该信息,保存为 repl-id 和 repl-offset -
master 重启后加载 RDB 文件,恢复数据,将 RDB 文件中保存的 repl-id 与 repl-offset 加载到内存中,master_repl_id = repl-id,master_repl_offset = repl-offset
-
通过 info 命令可以查看该信息
网络中断
master 的 CPU 占用过高或 slave 频繁断开连接
-
出现的原因:
- slave 每 1 秒发送 REPLCONF ACK 命令到 master
- 当 slave 接到了慢查询时(keys * ,hgetall 等),会大量占用 CPU 性能
- master 每 1 秒调用复制定时函数 replicationCron(),比对 slave 发现长时间没有进行响应
最终导致 master 各种资源(输出缓冲区、带宽、连接等)被严重占用
-
解决方法:通过设置合理的超时时间,确认是否释放 slave
repl-timeout # 该参数定义了超时时间的阈值(默认60秒),超过该值,释放slave
slave 与 master 连接断开
-
出现的原因:
- master 发送 ping 指令频度较低
- master 设定超时时间较短
- ping 指令在网络中存在丢包
-
解决方法:提高 ping 指令发送的频度
repl-ping-slave-period超时时间 repl-time 的时间至少是 ping 指令频度的5到10倍,否则 slave 很容易判定超时
一致性
网络信息不同步,数据发送有延迟,导致多个 slave 获取相同数据不同步
解决方案:
-
优化主从间的网络环境,通常放置在同一个机房部署,如使用阿里云等云服务器时要注意此现象
-
监控主从节点延迟(通过offset)判断,如果 slave 延迟过大,暂时屏蔽程序对该 slave 的数据访问
slave-serve-stale-data yes|no开启后仅响应 info、slaveof 等少数命令(慎用,除非对数据一致性要求很高)
-
多个 slave 同时对 master 请求数据同步,master 发送的 RDB 文件增多,会对带宽造成巨大冲击,造成 master 带宽不足,因此数据同步需要根据业务需求,适量错峰
哨兵模式
哨兵概述
Sentinel(哨兵)是 Redis 的高可用性(high availability)解决方案,由一个或多个 Sentinel 实例 instance 组成的 Sentinel 系统可以监视任意多个主服务器,以及这些主服务器的所有从服务器,并在被监视的主服务器下线时进行故障转移
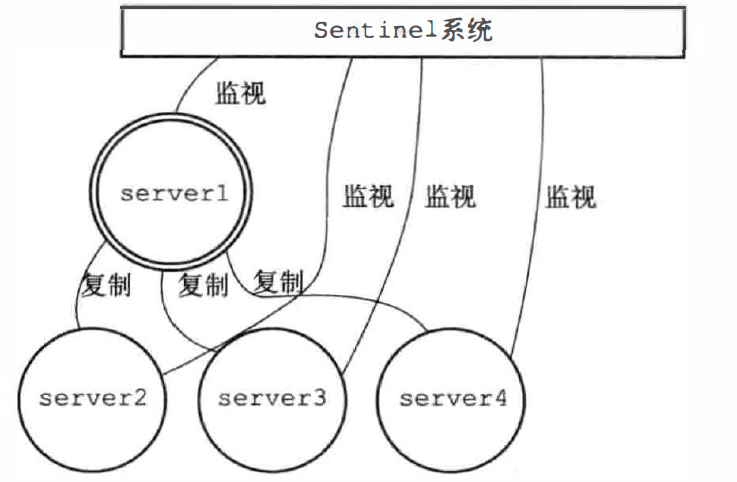
- 双环图案表示主服务器
- 单环图案表示三个从服务器
哨兵的作用:
-
监控:监控 master 和 slave,不断的检查 master 和 slave 是否正常运行,master 存活检测、master 与 slave 运行情况检测
-
通知:当被监控的服务器出现问题时,向其他哨兵发送通知
-
自动故障转移:断开 master 与 slave 连接,选取一个 slave 作为 master,将其他 slave 连接新的 master,并告知客户端新的服务器地址