SYSTEM
压缩列表
src/content/notes/system/压缩列表.md 压缩列表
底层结构
压缩列表(ziplist)是 Redis 为了节约内存而开发的,是列表键和哈希键的底层实现之一。是由一系列特殊编码的连续内存块组成的顺序型(sequential)数据结构,一个压缩列表可以包含任意多个节点(entry),每个节点可以保存一个字节数组或者一个整数值

- zlbytes:uint32_t 类型 4 字节,记录整个压缩列表占用的内存字节数,在对压缩列表进行内存重分配或者计算 zlend 的位置时使用
- zltail:uint32_t 类型 4 字节,记录压缩列表表尾节点距离起始地址有多少字节,通过这个偏移量程序无须遍历整个压缩列表就可以确定表尾节点的地址
- zllen:uint16_t 类型 2 字节,记录了压缩列表包含的节点数量,当该属性的值小于 UINT16_MAX (65535) 时,该值就是压缩列表中节点的数量;当这个值等于 UINT16_MAX 时节点的真实数量需要遍历整个压缩列表才能计算得出
- entryX:列表节点,压缩列表中的各个节点,节点的长度由节点保存的内容决定
- zlend:uint8_t 类型 1 字节,是一个特殊值 0xFF (255),用于标记压缩列表的末端

列表 zlbytes 属性的值为 0x50 (十进制 80),表示压缩列表的总长为 80 字节,列表 zltail 属性的值为 0x3c (十进制 60),假设表的起始地址为 p,计算得出表尾节点 entry3 的地址 p + 60
列表节点
列表节点 entry 的数据结构:

previous_entry_length:以字节为单位记录了压缩列表中前一个节点的长度,程序可以通过指针运算,根据当前节点的起始地址来计算出前一个节点的起始地址,完成从表尾向表头遍历操作
- 如果前一节点的长度小于 254 字节,该属性的长度为 1 字节,前一节点的长度就保存在这一个字节里
- 如果前一节点的长度大于等于 254 字节,该属性的长度为 5 字节,其中第一字节会被设置为 0xFE(十进制 254),之后的四个字节则用于保存前一节点的长度
encoding:记录了节点的 content 属性所保存的数据类型和长度
-
长度为 1 字节、2 字节或者 5 字节,值的最高位为 00、01 或者 10 的是字节数组编码,数组的长度由编码除去最高两位之后的其他位记录,下划线
_表示留空,而b、x等变量则代表实际的二进制数据
-
长度为 1 字节,值的最高位为 11 的是整数编码,整数值的类型和长度由编码除去最高两位之后的其他位记录
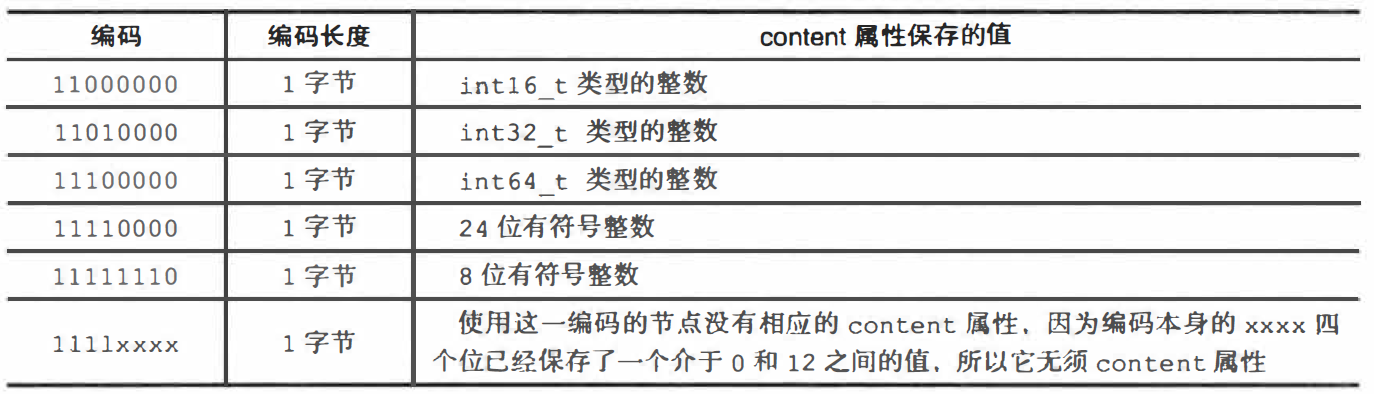
content:每个压缩列表节点可以保存一个字节数组或者一个整数值
-
字节数组可以是以下三种长度的其中一种:
-
长度小于等于 $63 (2^6-1)$ 字节的字节数组
-
长度小于等于 $16383(2^{14}-1)$ 字节的字节数组
-
长度小于等于 $4294967295(2^{32}-1)$ 字节的字节数组
-
-
整数值则可以是以下六种长度的其中一种:
-
4 位长,介于 0 至 12 之间的无符号整数
-
1 字节长的有符号整数
-
3 字节长的有符号整数
-
int16_t 类型整数
-
int32_t 类型整数
-
int64_t 类型整数
-
连锁更新
Redis 将在特殊情况下产生的连续多次空间扩展操作称之为连锁更新(cascade update)
假设在一个压缩列表中,有多个连续的、长度介于 250 到 253 字节之间的节点 e1 至 eN。将一个长度大于等于 254 字节的新节点 new 设置为压缩列表的头节点,new 就成为 e1 的前置节点。e1 的 previous_entry_length 属性仅为 1 字节,无法保存新节点 new 的长度,所以要对压缩列表执行空间重分配操作,并将 e1 节点的 previous_entry_length 属性从 1 字节长扩展为 5 字节长。由于 e1 原本的长度介于 250 至 253 字节之间,所以扩展后 e1 的长度就变成了 254 至 257 字节之间,导致 e2 的 previous_entry_length 属性无法保存 e1 的长度,程序需要不断地对压缩列表执行空间重分配操作,直到 eN 为止

删除节点也可能会引发连锁更新,big.length >= 254,small.length < 254,删除 small 节点

连锁更新在最坏情况下需要对压缩列表执行 N 次空间重分配,每次重分配的最坏复杂度为 O(N),所以连锁更新的最坏复杂度为 O(N^2)
说明:尽管连锁更新的复杂度较高,但出现的记录是非常低的,即使出现只要被更新的节点数量不多,就不会对性能造成影响