SYSTEM
zset
src/content/notes/system/zset.md zset
简介
数据存储需求:数据排序有利于数据的有效展示,需要提供一种可以根据自身特征进行排序的方式
数据存储结构:新的存储模型,可以保存可排序的数据
操作
指令操作:
-
数据操作
zadd key score1 member1 [score2 member2] #添加数据 zrem key member [member ...] #删除数据 zremrangebyrank key start stop #删除指定索引范围的数据 zremrangebyscore key min max #删除指定分数区间内的数据 zscore key member #获取指定值的分数 zincrby key increment member #指定值的分数增加increment -
查询操作
zrange key start stop [WITHSCORES] #获取指定范围的数据,升序,WITHSCORES 代表显示分数 zrevrange key start stop [WITHSCORES] #获取指定范围的数据,降序 zrangebyscore key min max [WITHSCORES] [LIMIT offset count] #按条件获取数据,从小到大 zrevrangebyscore key max min [WITHSCORES] [...] #从大到小 zcard key #获取集合数据的总量 zcount key min max #获取指定分数区间内的数据总量 zrank key member #获取数据对应的索引(排名)升序 zrevrank key member #获取数据对应的索引(排名)降序- min 与 max 用于限定搜索查询的条件
- start 与 stop 用于限定查询范围,作用于索引,表示开始和结束索引
- offset 与 count 用于限定查询范围,作用于查询结果,表示开始位置和数据总量
-
集合的交、并操作
zinterstore destination numkeys key [key ...] #两个集合的交集并存储到指定集合中 zunionstore destination numkeys key [key ...] #两个集合的并集并存储到指定集合中
注意事项:
- score 保存的数据存储空间是 64 位,如果是整数范围是 -9007199254740992~9007199254740992
- score 保存的数据也可以是一个双精度的 double 值,基于双精度浮点数的特征可能会丢失精度,慎重使用
- sorted_set 底层存储还是基于 set 结构的,因此数据不能重复,如果重复添加相同的数据,score 值将被反复覆盖,保留最后一次修改的结果
实现
有序集合对象的内部编码有两种:ziplist(压缩列表)和 skiplist(跳跃表)
-
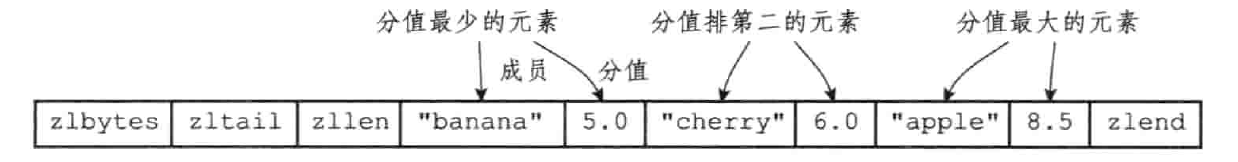
压缩列表实现有序集合对象:ziplist 本身是有序、不可重复的,符合有序集合的特性
-
跳跃表实现有序集合对象:底层是 zset 结构,zset 同时包含字典和跳跃表的结构,图示字典和跳跃表中重复展示了各个元素的成员和分值,但实际上两者会通过指针来共享相同元素的成员和分值,不会产生空间浪费
typedef struct zset { zskiplist *zsl; dict *dict; } zset;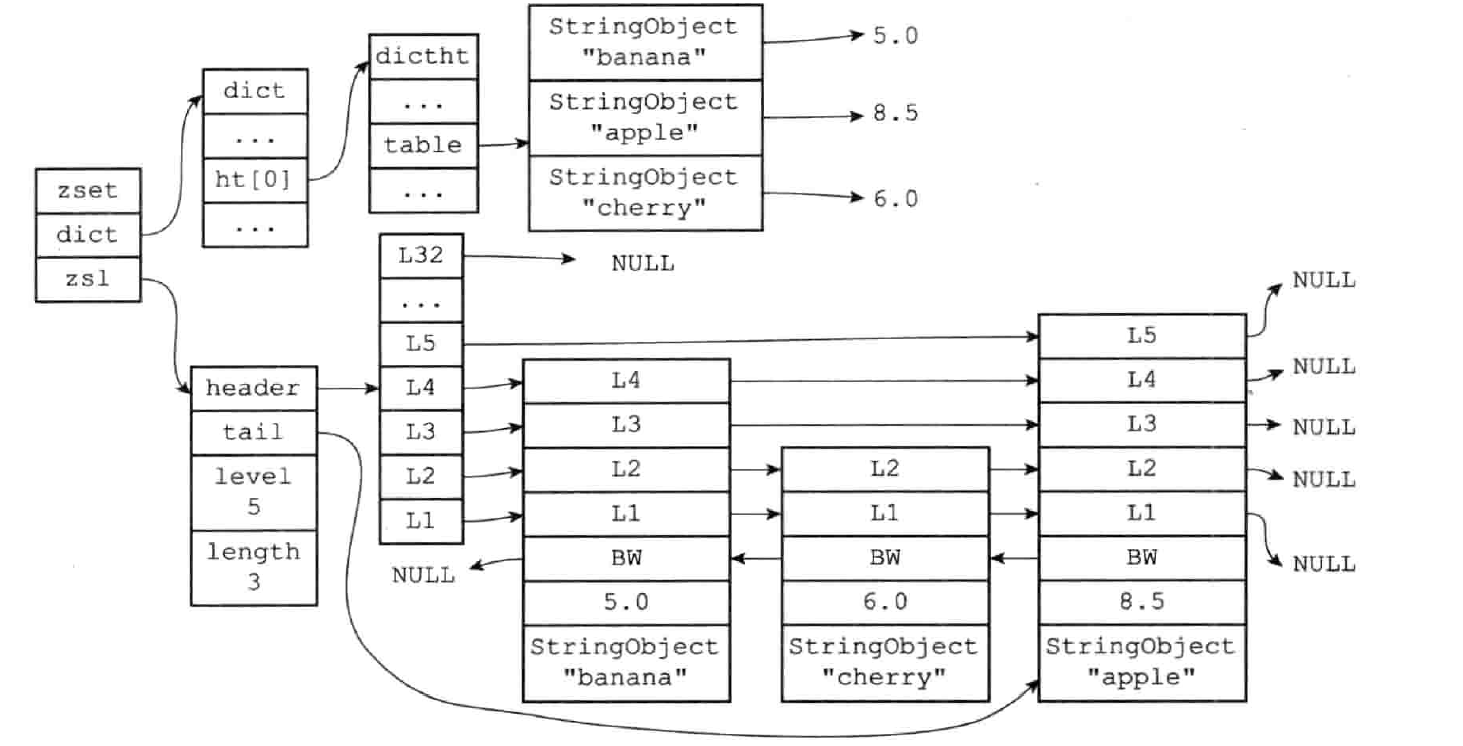
使用字典加跳跃表的优势:
- 字典为有序集合创建了一个从成员到分值的映射,用 O(1) 复杂度查找给定成员的分值
- 排序操作使用跳跃表完成,节省每次重新排序带来的时间成本和空间成本
使用 ziplist 格式存储需要满足以下两个条件:
- 有序集合保存的元素个数要小于 128 个;
- 有序集合保存的所有元素大小都小于 64 字节
当元素比较多时,此时 ziplist 的读写效率会下降,时间复杂度是 O(n),跳表的时间复杂度是 O(logn)
为什么用跳表而不用平衡树?
- 在做范围查找的时候,跳表操作简单(前进指针或后退指针),平衡树需要回旋查找
- 跳表比平衡树实现简单,平衡树的插入和删除操作可能引发子树的旋转调整,而跳表的插入和删除只需要修改相邻节点的指针
应用
- 排行榜
- 对于基于时间线限定的任务处理,将处理时间记录为 score 值,利用排序功能区分处理的先后顺序
- 当任务或者消息待处理,形成了任务队列或消息队列时,对于高优先级的任务要保障对其优先处理,采用 score 记录权重