SYSTEM
AOF
src/content/notes/system/AOF.md AOF
基本概述
AOF(append only file)持久化:以独立日志的方式记录每次写命令(不记录读)来记录数据库状态,增量保存只许追加文件但不可以改写文件,与 RDB 相比可以理解为由记录数据改为记录数据的变化
AOF 主要作用是解决了数据持久化的实时性,目前已经是 Redis 持久化的主流方式
AOF 写数据过程:
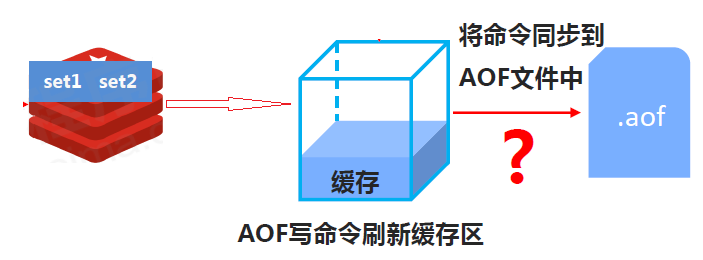
Redis 只会将对数据库进行了修改的命令写入到 AOF 文件,并复制到各个从服务器,但是 PUBSUB 和 SCRIPT LOAD 命令例外:
- PUBSUB 命令虽然没有修改数据库,但 PUBSUB 命令向频道的所有订阅者发送消息这一行为带有副作用,接收到消息的所有客户端的状态都会因为这个命令而改变,所以服务器需要使用 REDIS_FORCE_AOF 标志强制将这个命令写入 AOF 文件。这样在将来载入 AOF 文件时,服务器就可以再次执行相同的 PUBSUB 命令,并产生相同的副作用
- SCRIPT LOAD 命令虽然没有修改数据库,但它修改了服务器状态,所以也是一个带有副作用的命令,需要使用 REDIS_FORCE_AOF
持久实现
AOF 持久化功能的实现可以分为命令追加(append)、文件写入、文件同步(sync)三个步骤
命令追加
启动 AOF 的基本配置:
appendonly yes|no #开启AOF持久化功能,默认no,即不开启状态
appendfilename filename #AOF持久化文件名,默认appendonly.aof,建议设置appendonly-端口号.aof
dir #AOF持久化文件保存路径,与RDB持久化文件路径保持一致即可当 AOF 持久化功能处于打开状态时,服务器在执行完一个写命令之后,会以协议格式将被执行的写命令追加到服务器状态的 aof_buf 缓冲区的末尾
struct redisServer {
// AOF 缓冲区
sds aof_buf;
};文件写入
服务器在处理文件事件时会执行写命令,追加一些内容到 aof_buf 缓冲区里,所以服务器每次结束一个事件循环之前,就会执行 flushAppendOnlyFile 函数,判断是否需要将 aof_buf 缓冲区中的内容写入和保存到 AOF 文件里
flushAppendOnlyFile 函数的行为由服务器配置的 appendfsync 选项的值来决定
appendfsync always|everysec|no #AOF写数据策略:默认为everysec-
always:每次写入操作都将 aof_buf 缓冲区中的所有内容写入并同步到 AOF 文件
特点:安全性最高,数据零误差,但是性能较低,不建议使用
-
everysec:先将 aof_buf 缓冲区中的内容写入到操作系统缓存,判断上次同步 AOF 文件的时间距离现在超过一秒钟,再次进行同步 fsync,这个同步操作是由一个(子)线程专门负责执行的
特点:在系统突然宕机的情况下丢失 1 秒内的数据,准确性较高,性能较高,建议使用,也是默认配置
-
no:将 aof_buf 缓冲区中的内容写入到操作系统缓存,但并不进行同步,何时同步由操作系统来决定
特点:整体不可控,服务器宕机会丢失上次同步 AOF 后的所有写指令
文件同步
在现代操作系统中,当用户调用 write 函数将数据写入文件时,操作系统通常会将写入数据暂时保存在一个内存缓冲区空间,等到缓冲区写满或者到达特定时间周期,才真正地将缓冲区中的数据写入到磁盘里面(刷脏)
- 优点:提高文件的写入效率
- 缺点:为写入数据带来了安全问题,如果计算机发生停机,那么保存在内存缓冲区里面的写入数据将会丢失
系统提供了 fsync 和 fdatasync 两个同步函数做强制硬盘同步,可以让操作系统立即将缓冲区中的数据写入到硬盘里面,函数会阻塞到写入硬盘完成后返回,保证了数据持久化
异常恢复:AOF 文件损坏,通过 redis-check-aof—fix appendonly.aof 进行恢复,重启 Redis,然后重新加载
文件载入
AOF 文件里包含了重建数据库状态所需的所有写命令,所以服务器只要读入并重新执行一遍 AOF 文件里的命令,就还原服务器关闭之前的数据库状态,服务器在启动时,还原数据库状态打印的日志:
[8321] 05 Sep 11:58:50.449 * DB loaded from append only file: 0.000 seconds AOF 文件里面除了用于指定数据库的 SELECT 命令是服务器自动添加的,其他都是通过客户端发送的命令
* 2\r\n$6\r\nSELECT\r\n$1\r\n0\r\n # 服务器自动添加
* 3\r\n$3\r\nSET\r\n$3\r\nmsg\r\n$5\r\nhello\r\n
* 5\r\n$4\r\nSADD\r\n$6\r\nfruits\r\n$5\r\napple\r\n$6\r\nbanana\r\n$6\r\ncherry\r\nRedis 读取 AOF 文件并还原数据库状态的步骤:
- 创建一个不带网络连接的伪客户端(fake client)执行命令,因为 Redis 的命令只能在客户端上下文中执行, 而载入 AOF 文件时所使用的命令来源于本地 AOF 文件而不是网络连接
- 从 AOF 文件分析并读取一条写命令
- 使用伪客户端执行被读出的写命令,然后重复上述步骤
重写实现
重写策略
AOF 重写:读取服务器当前的数据库状态,生成新 AOF 文件来替换旧 AOF 文件,不会对现有的 AOF 文件进行任何读取、分析或者写入操作,而是直接原子替换。新 AOF 文件不会包含任何浪费空间的冗余命令,所以体积通常会比旧 AOF 文件小得多
AOF 重写规则:
-
进程内具有时效性的数据,并且数据已超时将不再写入文件
-
对同一数据的多条写命令合并为一条命令,因为会读取当前的状态,所以直接将当前状态转换为一条命令即可。为防止数据量过大造成客户端缓冲区溢出,对 list、set、hash、zset 等集合类型,单条指令最多写入 64 个元素
如 lpushlist1 a、lpush list1 b、lpush list1 c 可以转化为:lpush list1 a b c
-
非写入类的无效指令将被忽略,只保留最终数据的写入命令,但是 select 指令虽然不更改数据,但是更改了数据的存储位置,此类命令同样需要记录
AOF 重写作用:
- 降低磁盘占用量,提高磁盘利用率
- 提高持久化效率,降低持久化写时间,提高 IO 性能
- 降低数据恢复的用时,提高数据恢复效率
重写原理
AOF 重写程序 aof_rewrite 函数可以创建一个新 AOF 文件, 但是该函数会进行大量的写入操作,调用这个函数的线程将被长时间阻塞,所以 Redis 将 AOF 重写程序放到 fork 的子进程里执行,不会阻塞父进程,重写命令:
bgrewriteaof-
子进程进行 AOF 重写期间,服务器进程(父进程)可以继续处理命令请求
-
子进程带有服务器进程的数据副本,使用子进程而不是线程,可以在避免使用锁的情况下, 保证数据安全性

子进程在进行 AOF 重写期间,服务器进程还需要继续处理命令请求,而新命令可能会对现有的数据库状态进行修改,从而使得服务器当前的数据库状态和重写后的 AOF 文件所保存的数据库状态不一致,所以 Redis 设置了 AOF 重写缓冲区
工作流程:
- Redis 服务器执行完一个写命令,会同时将该命令追加到 AOF 缓冲区和 AOF 重写缓冲区(从创建子进程后才开始写入)
- 当子进程完成 AOF 重写工作之后,会向父进程发送一个信号,父进程在接到该信号之后, 会调用一个信号处理函数,该函数执行时会对服务器进程(父进程)造成阻塞(影响很小,类似 JVM STW),主要工作:
- 将 AOF 重写缓冲区中的所有内容写入到新 AOF 文件中, 这时新 AOF 文件所保存的状态将和服务器当前的数据库状态一致
- 对新的 AOF 文件进行改名,原子地(atomic)覆盖现有的 AOF 文件,完成新旧两个 AOF 文件的替换
自动重写
触发时机:Redis 会记录上次重写时的 AOF 大小,默认配置是当 AOF 文件大小是上次重写后大小的一倍且文件大于 64M 时触发
auto-aof-rewrite-min-size size #设置重写的基准值,最小文件 64MB,达到这个值开始重写
auto-aof-rewrite-percentage percent #触发AOF文件执行重写的增长率,当前AOF文件大小超过上一次重写的AOF文件大小的百分之多少才会重写,比如文件达到 100% 时开始重写就是两倍时触发自动重写触发比对参数( 运行指令 info Persistence 获取具体信息 ):
aof_current_size #AOF文件当前尺寸大小(单位:字节)
aof_base_size #AOF文件上次启动和重写时的尺寸大小(单位:字节)自动重写触发条件公式:
- aof_current_size > auto-aof-rewrite-min-size
- (aof_current_size - aof_base_size) / aof_base_size >= auto-aof-rewrite-percentage