SYSTEM
跳跃表
src/content/notes/system/跳跃表.md 跳跃表
底层结构
跳跃表(skiplist)是一种有序(默认升序)的数据结构,在链表的基础上增加了多级索引以提升查找的效率,索引是占内存的,所以是一个空间换时间的方案,跳表平均 O(logN)、最坏 O(N) 复杂度的节点查找,效率与平衡树相当但是实现更简单
原始链表中存储的有可能是很大的对象,而索引结点只需要存储关键值和几个指针,并不需要存储对象,因此当节点本身比较大或者元素数量比较多的时候,其优势可以被放大,而缺点(占内存)则可以忽略
Redis 只在两个地方应用了跳跃表,一个是实现有序集合键,另一个是在集群节点中用作内部数据结构
typedef struct zskiplist {
// 表头节点和表尾节点,O(1) 的时间复杂度定位头尾节点
struct skiplistNode *head, *tail;
// 表的长度,也就是表内的节点数量 (表头节点不计算在内)
unsigned long length;
// 表中层数最大的节点的层数 (表头节点的层高不计算在内)
int level
} zskiplist;typedef struct zskiplistNode {
// 层
struct zskiplistLevel {
// 前进指针
struct zskiplistNode *forward;
// 跨度
unsigned int span;
} level[];
// 后退指针
struct zskiplistNode *backward;
// 分值
double score;
// 成员对象
robj *obj;
} zskiplistNode;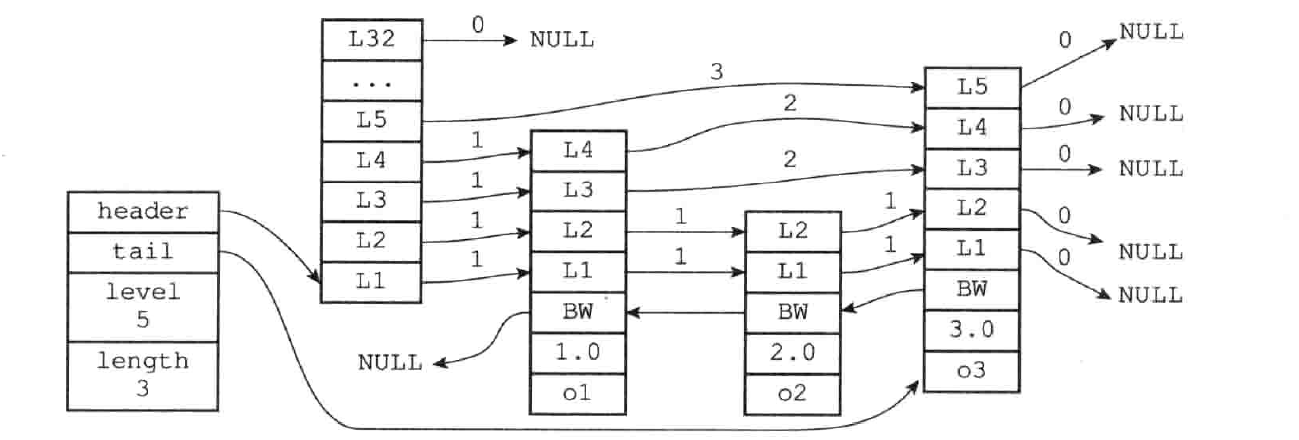
属性分析
层:level 数组包含多个元素,每个元素包含指向其他节点的指针。根据幕次定律(power law,越大的数出现的概率越小)随机生成一个介于 1 和 32 之间的值(Redis5 之后最大为 64)作为 level 数组的大小,这个大小就是层的高度,节点的第一层是 level[0] = L1
前进指针:forward 用于从表头到表尾方向正序(升序)遍历节点,遇到 NULL 停止遍历
跨度:span 用于记录两个节点之间的距离,用来计算排位(rank):
-
两个节点之间的跨度越大相距的就越远,指向 NULL 的所有前进指针的跨度都为 0
-
在查找某个节点的过程中,将沿途访问过的所有层的跨度累计起来,结果就是目标节点在跳跃表中的排位,按照上图所示:
查找分值为 3.0 的节点,沿途经历的层:查找的过程只经过了一个层,并且层的跨度为 3,所以目标节点在跳跃表中的排位为 3
查找分值为 2.0 的节点,沿途经历的层:经过了两个跨度为 1 的节点,因此可以计算出目标节点在跳跃表中的排位为 2
后退指针:backward 用于从表尾到表头方向逆序(降序)遍历节点
分值:score 属性一个 double 类型的浮点数,跳跃表中的所有节点都按分值从小到大来排序
成员对象:obj 属性是一个指针,指向一个 SDS 字符串对象。同一个跳跃表中,各个节点保存的成员对象必须是唯一的,但是多个节点保存的分值可以是相同的,分值相同的节点将按照成员对象在字典序中的大小来进行排序(从小到大)
个人笔记:JUC → 并发包 → ConcurrentSkipListMap 详解跳跃表