SYSTEM
选择排序
src/content/notes/system/选择排序.md 选择排序
简单选择
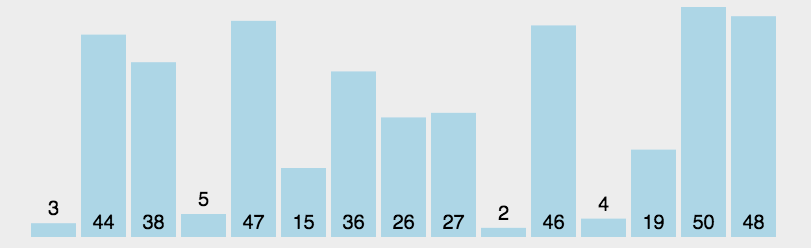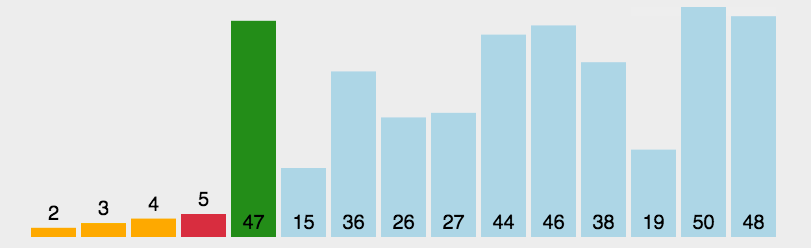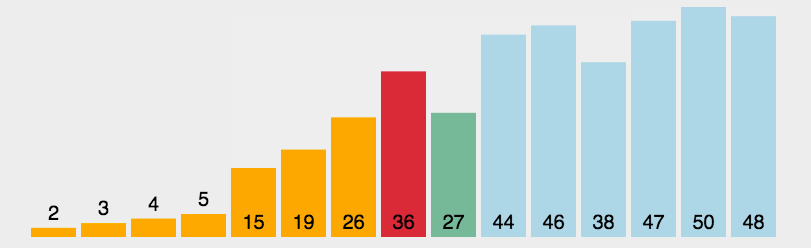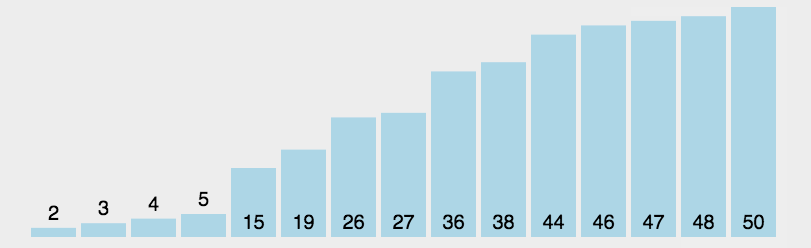
选择排序(Selection-sort):一种简单直观的排序算法
算法描述:首先在未排序序列中找到最小(大)元素,存放到排序序列的起始位置,然后再从剩余未排序元素中继续寻找最小(大)元素,然后放到已排序序列的末尾。以此类推,直到所有元素均排序完毕
实现思路:
- 控制选择几轮:数组的长度 - 1
- 控制每轮从当前位置开始比较几次
public class SelectSort {
public static void main(String[] args) {
int[] arr = {55, 22, 2, 5, 1, 3, 8, 5, 7, 4, 3, 99, 88};
for (int i = 0; i < arr.length - 1; i++) {
//获取最小索引位置
int minIndex = i;
for (int j = i + 1; j < arr.length; j++) {
if (arr[minIndex] > arr[j]) {
minIndex = j;
}
}
//交换元素
int temp = arr[i];
arr[i] = arr[minIndex];
arr[minIndex] = temp;
}
System.out.println(Arrays.toString(arr));
}
}选择排序时间复杂度:
- 数据比较次数:
(N-1)+(N-2)+(N-3)+...+2+1=((N-1)+1)*(N-1)/2=N^2/2-N/2 - 数据交换次数:
N-1 - 时间复杂度:
N^2/2-N/2+(N-1)=N^2/2+N/2-1
根据大 O 推导法则,保留最高阶项,去除常数因子,时间复杂度为 O(N^2)
堆排序
堆排序(Heapsort)是指利用堆这种数据结构所设计的一种排序算法,堆结构是一个近似完全二叉树的结构,并同时满足子结点的键值或索引总是小于(或者大于)父节点
优先队列:堆排序每次上浮过程都会将最大或者最小值放在堆顶,应用于优先队列可以将优先级最高的元素浮到堆顶
实现思路:
-
将初始待排序关键字序列(R1,R2….Rn)构建成大顶堆,并通过上浮对堆进行调整,此堆为初始的无序区,堆顶为最大数
-
将堆顶元素 R[1] 与最后一个元素 R[n] 交换,此时得到新的无序区(R1,R2,……Rn-1)和新的有序区 Rn,且满足 R[1,2…n-1]<=R[n]
-
交换后新的堆顶 R[1] 可能违反堆的性质,因此需要对当前无序区(R1,R2,……Rn-1)调整为新堆,然后再次将 R[1] 与无序区最后一个元素交换,得到新的无序区(R1,R2….Rn-2)和新的有序区(Rn-1,Rn),不断重复此过程直到有序区的元素个数为 n-1,则整个排序过程完成
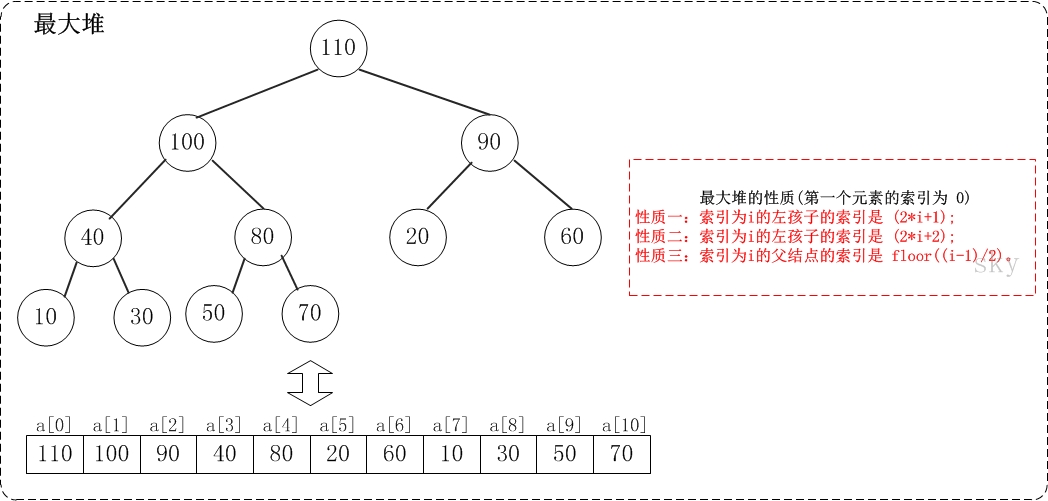
floor:向下取整
public class HeapSort {
public static void main(String[] args) {
int[] arr = {55, 22, 2, 5, 1, 3, 8, 5, 7, 4, 3, 99, 88};
heapSort(arr, arr.length - 1);
System.out.println(Arrays.toString(arr));
}
//high为数组最大索引
private static void heapSort(int[] arr, int high) {
//建堆,逆排序,因为堆排序定义的交换顺序是从当前结点往下交换,逆序排可以避免多余的交换
//i初始值是最后一个节点的父节点,如果参数是数组长度len,则 i = len / 2 -1
for (int i = (high - 1) / 2; i >= 0; i--) {
//调整函数
sift(arr, i, high);
}
//从尾索引开始排序
for (int i = high; i > 0; i--) {
//将最大的节点放入末尾
int temp = arr[0];
arr[0] = arr[i];
arr[i] = temp;
//继续寻找最大的节点
sift(arr, 0, i - 1);
}
}
//调整函数,调整arr[low]的元素,从索引low到high的范围调整
private static void sift(int[] arr, int low, int high) {
//暂存调整元素
int temp = arr[low];
int i = low, j = low * 2 + 1;//j是左节点
while (j <= high) {
//判断是否有右孩子,并且比较左右孩子中较大的节点
if (j < high && arr[j] < arr[j + 1]) {
j++; //指向右孩子
}
if (temp < arr[j]) {
arr[i] = arr[j];
i = j; //继续向下调整
j = 2 * i + 1;
} else {
//temp > arr[j],说明也大于j的孩子,探测结束
break;
}
}
//将被调整的节点放入最终的位置
arr[i] = temp;
}
}堆排序的时间复杂度是 O(nlogn)