SYSTEM
ForkJoin 分支合并框架
src/content/notes/system/fork.md fork
介绍
fork() 函数创建一个子进程,子进程与父进程几乎是完全相同的进程,系统先给子进程分配资源,然后把父进程的所有数据都复制到子进程中,只有少数值与父进程的值不同,相当于克隆了一个进程
在完成对其调用之后,会产生 2 个进程,且每个进程都会从 fork() 的返回处开始执行,这两个进程将执行相同的程序段,但是拥有各自不同的堆段,栈段,数据段,每个子进程都可修改各自的数据段,堆段,和栈段
#include<unistd.h>
pid_t fork(void);
// 父进程返回子进程的pid,子进程返回0,错误返回负值,根据返回值的不同进行对应的逻辑处理fork 调用一次,却能够返回两次,可能有三种不同的返回值:
- 在父进程中,fork 返回新创建子进程的进程 ID
- 在子进程中,fork 返回 0
- 如果出现错误,fork 返回一个负值,错误原因:
- 当前的进程数已经达到了系统规定的上限,这时 errno 的值被设置为 EAGAIN
- 系统内存不足,这时 errno 的值被设置为 ENOMEM
fpid 的值在父子进程中不同:进程形成了链表,父进程的 fpid 指向子进程的进程 id,因为子进程没有子进程,所以其 fpid 为0
创建新进程成功后,系统中出现两个基本完全相同的进程,这两个进程执行没有固定的先后顺序,哪个进程先执行要看系统的调度策略
每个进程都有一个独特(互不相同)的进程标识符 process ID,可以通过 getpid() 函数获得;还有一个记录父进程 pid 的变量,可以通过 getppid() 函数获得变量的值
使用
基本使用:
#include <unistd.h>
#include <stdio.h>
int main ()
{
pid_t fpid; // fpid表示fork函数返回的值
int count = 0;
fpid = fork();
if (fpid < 0)
printf("error in fork!");
else if (fpid == 0) {
printf("i am the child process, my process id is %d/n", getpid());
count++;
}
else {
printf("i am the parent process, my process id is %d/n", getpid());
count++;
}
printf("count: %d/n",count);// 1
return 0;
}
/* 输出内容:
i am the child process, my process id is 5574
count: 1
i am the parent process, my process id is 5573
count: 1
*/进阶使用:
#include <unistd.h>
#include <stdio.h>
int main(void)
{
int i = 0;
// ppid 指当前进程的父进程pid
// pid 指当前进程的pid,
// fpid 指fork返回给当前进程的值,在这可以表示子进程
for(i = 0; i < 2; i++){
pid_t fpid = fork();
if(fpid == 0)
printf("%d child %4d %4d %4d/n",i, getppid(), getpid(), fpid);
else
printf("%d parent %4d %4d %4d/n",i, getppid(), getpid(),fpid);
}
return 0;
}
/*输出内容:
i 父id id 子id
0 parent 2043 3224 3225
0 child 3224 3225 0
1 parent 2043 3224 3226
1 parent 3224 3225 3227
1 child 1 3227 0
1 child 1 3226 0
*/
在 p3224 和 p3225 执行完第二个循环后,main 函数退出,进程死亡。所以 p3226,p3227 就没有父进程了,成为孤儿进程,所以 p3226 和 p3227 的父进程就被置为 ID 为 1 的 init 进程(笔记 Tool → Linux → 进程管理详解)
参考文章:https://blog.csdn.net/love_gaohz/article/details/41727415
内存
fork() 调用之后父子进程的内存关系
早期 Linux 的 fork() 实现时,就是全部复制,这种方法效率太低,而且造成了很大的内存浪费,现在 Linux 实现采用了两种方法:
-
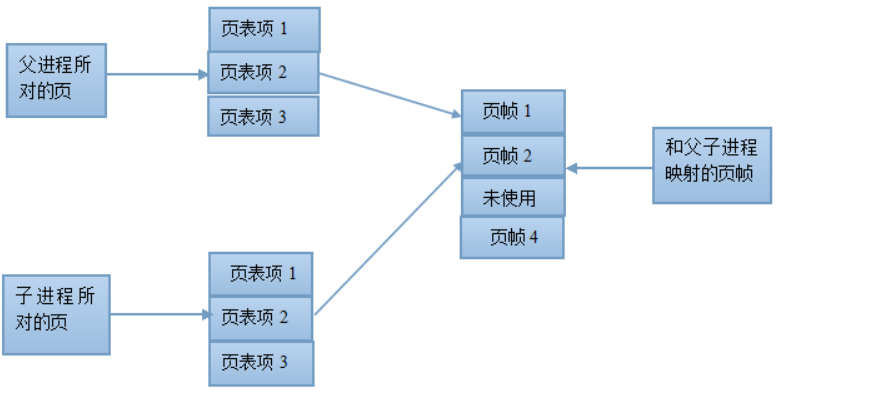
父子进程的代码段是相同的,所以代码段是没必要复制的,只需内核将代码段标记为只读,父子进程就共享此代码段。fork() 之后在进程创建代码段时,子进程的进程级页表项都指向和父进程相同的物理页帧

-
对于父进程的数据段,堆段,栈段中的各页,由于父子进程相互独立,采用写时复制 COW 的技术,来提高内存以及内核的利用率
在 fork 之后两个进程用的是相同的物理空间(内存区),子进程的代码段、数据段、堆栈都是指向父进程的物理空间,两者的虚拟空间不同,但其对应的物理空间是同一个,当父子进程中有更改相应段的行为发生时,再为子进程相应的段分配物理空间。如果两者的代码完全相同,代码段继续共享父进程的物理空间;而如果两者执行的代码不同,子进程的代码段也会分配单独的物理空间。
fork 之后内核会将子进程放在队列的前面,让子进程先执行,以免父进程执行导致写时复制,而后子进程再执行,因无意义的复制而造成效率的下降
补充知识:
vfork(虚拟内存 fork virtual memory fork):调用 vfork() 父进程被挂起,子进程使用父进程的地址空间。不采用写时复制,如果子进程修改父地址空间的任何页面,这些修改过的页面对于恢复的父进程是可见的
参考文章:https://blog.csdn.net/Shreck66/article/details/47039937