SYSTEM
存储优化
src/content/notes/system/存储优化.md 存储优化
数据存储
系统表空间是用来放系统信息的,比如数据字典什么的,对应的磁盘文件是 ibdata,数据表空间是一个个的表数据文件,对应的磁盘文件就是表名.ibd
表数据既可以存在共享表空间里,也可以是单独的文件,这个行为是由参数 innodb_file_per_table 控制的:
- OFF:表示表的数据放在系统共享表空间,也就是跟数据字典放在一起
- ON :表示每个 InnoDB 表数据存储在一个以 .ibd 为后缀的文件中(默认)
一个表单独存储为一个文件更容易管理,在不需要这个表时通过 drop table 命令,系统就会直接删除这个文件;如果是放在共享表空间中,即使表删掉了,空间也是不会回收的
数据删除
MySQL 的数据删除就是移除掉某个记录后,该位置就被标记为可复用,如果有符合范围条件的数据可以插入到这里。符合范围条件的意思是假设删除记录 R4,之后要再插入一个 ID 在 300 和 600 之间的记录时,就会复用这个位置
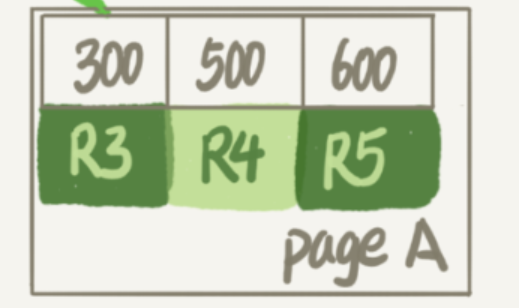
InnoDB 的数据是按页存储的如果删掉了一个数据页上的所有记录,整个数据页就可以被复用了,如果相邻的两个数据页利用率都很小,系统就会把这两个页上的数据合到其中一个页上,另外一个数据页就被标记为可复用
删除命令其实只是把记录的位置,或者数据页标记为了可复用,但磁盘文件的大小是不会变的,这些可以复用还没有被使用的空间,看起来就像是空洞,造成数据库的稀疏,因此需要进行紧凑处理
重建数据
重建表就是按照主键 ID 递增的顺序,把数据一行一行地从旧表中读出来再插入到新表中,让数据更加紧凑。重建表时 MySQL 会自动完成转存数据、交换表名、删除旧表的操作,线上操作会阻塞大量的线程增删改查的操作
重建命令:
ALTER TABLE A ENGINE=InnoDB工作流程:新建临时表 tmp_table B(在 Server 层创建的),把表 A 中的数据导入到表 B 中,操作完成后用表 B 替换表 A,完成重建
重建表的步骤需要 DDL 不是 Online 的,因为在导入数据的过程有新的数据要写入到表 A 的话,就会造成数据丢失
MySQL 5.6 版本开始引入的 Online DDL,重建表的命令默认执行此步骤:
- 建立一个临时文件 tmp_file(InnoDB 创建),扫描表 A 主键的所有数据页
- 用数据页中表 A 的记录生成 B+ 树,存储到临时文件中
- 生成临时文件的过程中,将所有对 A 的操作记录在一个日志文件(row log)中,对应的是图中 state2 的状态
- 临时文件生成后,将日志文件中的操作应用到临时文件,得到一个逻辑数据上与表 A 相同的数据文件,对应的就是图中 state3
- 用临时文件替换表 A 的数据文件

Online DDL 操作会先获取 MDL 写锁,再退化成 MDL 读锁。但 MDL 写锁持有时间比较短,所以可以称为 Online; 而 MDL 读锁,不阻止数据增删查改,但会阻止其它线程修改表结构(可以对比 ANALYZE TABLE t 命令)
问题:重建表可以收缩表空间,但是执行指令后整体占用空间增大
原因:在重建表后 InnoDB 不会把整张表占满,每个页留了 1/16 给后续的更新使用。表在未整理之前页已经占用 15/16 以上,收缩之后需要保持数据占用空间在 15/16,所以文件占用空间更大才能保持
注意:临时文件也要占用空间,如果空间不足会重建失败
原地置换
DDL 中的临时表 tmp_table 是在 Server 层创建的,Online DDL 中的临时文件 tmp_file 是 InnoDB 在内部创建出来的,整个 DDL 过程都在 InnoDB 内部完成,对于 Server 层来说,没有把数据挪动到临时表,是一个原地操作,这就是 inplace
两者的关系:
- DDL 过程如果是 Online 的,就一定是 inplace 的
- inplace 的 DDL,有可能不是 Online 的,截止到 MySQL 8.0,全文索引(FULLTEXT)和空间索引(SPATIAL)属于这种情况
并发优化
MySQL Server 是多线程结构,包括后台线程和客户服务线程。多线程可以有效利用服务器资源,提高数据库的并发性能。在 MySQL 中,控制并发连接和线程的主要参数:
-
max_connections:控制允许连接到 MySQL 数据库的最大连接数,默认值是 151
如果状态变量 connection_errors_max_connections 不为零,并且一直增长,则说明不断有连接请求因数据库连接数已达到允许最大值而失败,这时可以考虑增大 max_connections 的值
MySQL 最大可支持的连接数取决于很多因素,包括操作系统平台的线程库的质量、内存大小、每个连接的负荷、CPU的处理速度、期望的响应时间等。在 Linux 平台下,性能好的服务器,可以支持 500-1000 个连接,需要根据服务器性能进行评估设定
-
innodb_thread_concurrency:并发线程数,代表系统内同时运行的线程数量(已经被移除)
-
back_log:控制 MySQL 监听 TCP 端口时的积压请求栈的大小
如果 Mysql 的连接数达到 max_connections 时,新来的请求将会被存在堆栈中,以等待某一连接释放资源,该堆栈的数量即 back_log。如果等待连接的数量超过 back_log,将不被授予连接资源直接报错
5.6.6 版本之前默认值为 50,之后的版本默认为
50 + (max_connections/5),但最大不超过900,如果需要数据库在较短的时间内处理大量连接请求, 可以考虑适当增大 back_log 的值 -
table_open_cache:控制所有 SQL 语句执行线程可打开表缓存的数量
在执行 SQL 语句时,每个执行线程至少要打开1个表缓存,该参数的值应该根据设置的最大连接数以及每个连接执行关联查询中涉及的表的最大数量来设定:
max_connections * N -
thread_cache_size:可控制 MySQL 缓存客户服务线程的数量
为了加快连接数据库的速度,MySQL 会缓存一定数量的客户服务线程以备重用,池化思想
-
innodb_lock_wait_timeout:设置 InnoDB 事务等待行锁的时间,默认值是 50ms
对于需要快速反馈的业务系统,可以将行锁的等待时间调小,以避免事务被长时间挂起; 对于后台运行的批量处理程序来说,可以将行锁的等待时间调大,以避免发生大的回滚操作
事务机制
基本介绍
事务(Transaction)是访问和更新数据库的程序执行单元;事务中可能包含一个或多个 SQL 语句,这些语句要么都执行,要么都不执行,作为一个关系型数据库,MySQL 支持事务。
单元中的每条 SQL 语句都相互依赖,形成一个整体
-
如果某条 SQL 语句执行失败或者出现错误,那么整个单元就会回滚,撤回到事务最初的状态
-
如果单元中所有的 SQL 语句都执行成功,则事务就顺利执行
事务的四大特征:ACID
- 原子性 (atomicity)
- 一致性 (consistency)
- 隔离性 (isolaction)
- 持久性 (durability)
事务的几种状态:
- 活动的(active):事务对应的数据库操作正在执行中
- 部分提交的(partially committed):事务的最后一个操作执行完,但是内存还没刷新至磁盘
- 失败的(failed):当事务处于活动状态或部分提交状态时,如果数据库遇到了错误或刷脏失败,或者用户主动停止当前的事务
- 中止的(aborted):失败状态的事务回滚完成后的状态
- 提交的(committed):当处于部分提交状态的事务刷脏成功,就处于提交状态