SYSTEM
SQL 优化
src/content/notes/system/SQL-优化.md SQL 优化
自增主键
自增机制
自增主键可以让主键索引尽量地保持在数据页中递增顺序插入,不自增需要寻找其他页插入,导致随机 IO 和页分裂的情况
表的结构定义存放在后缀名为.frm 的文件中,但是并不会保存自增值,不同的引擎对于自增值的保存策略不同:
- MyISAM 引擎的自增值保存在数据文件中
- InnoDB 引擎的自增值保存在了内存里,每次打开表都会去找自增值的最大值 max(id),然后将 max(id)+1 作为当前的自增值;8.0 版本后,才有了自增值持久化的能力,将自增值的变更记录在了 redo log 中,重启的时候依靠 redo log 恢复重启之前的值
在插入一行数据的时候,自增值的行为如下:
- 如果插入数据时 id 字段指定为 0、null 或未指定值,那么就把这个表当前的 AUTO_INCREMENT 值填到自增字段
- 如果插入数据时 id 字段指定了具体的值,比如某次要插入的值是 X,当前的自增值是 Y
- 如果 X<Y,那么这个表的自增值不变
- 如果 X≥Y,就需要把当前自增值修改为新的自增值
参数说明:auto_increment_offset 和 auto_increment_increment 分别表示自增的初始值和步长,默认值都是 1
语句执行失败也不回退自增 id,所以保证了自增 id 是递增的,但不保证是连续的(不能回退,所以有些回滚事务的自增 id 就不会重新使用,导致出现不连续)
自增 ID
MySQL 不同的自增 id 在达到上限后的表现不同:
-
表的自增 id 如果是 int 类型,达到上限 2^32-1 后,再申请时值就不会改变,进而导致继续插入数据时报主键冲突的错误
-
row_id 长度为 6 个字节,达到上限后则会归 0 再重新递增,如果出现相同的 row_id,后写的数据会覆盖之前的数据,造成旧数据丢失,影响的是数据可靠性,所以应该在 InnoDB 表中主动创建自增主键报主键冲突,插入失败影响的是可用性,而一般情况下,可靠性优先于可用性
-
Xid 长度 8 字节,由 Server 层维护,只需要不在同一个 binlog 文件中出现重复值即可,虽然理论上会出现重复值,但是概率极小
-
InnoDB 的 max_trx_id 递增值每次 MySQL 重启都会被保存起来,重启也不会重置为 0,所以会导致一直增加到达上限,然后从 0 开始,这时原事务 0 修改的数据对当前事务就是可见的,产生脏读的现象
只读事务不分配 trx_id,所以 trx_id 的增加速度变慢了
-
thread_id 长度 4 个字节,到达上限后就会重置为 0,MySQL 设计了一个唯一数组的逻辑,给新线程分配 thread_id 时做判断,保证不会出现两个相同的 thread_id:
do { new_id = thread_id_counter++; } while (!thread_ids.insert_unique(new_id).second);
参考文章:https://time.geekbang.org/column/article/83183
覆盖索引
复合索引叶子节点不仅保存了复合索引的值,还有主键索引,所以使用覆盖索引的时候,加上主键也会用到索引
尽量使用覆盖索引,避免 SELECT *:
EXPLAIN SELECT name,status,address FROM tb_seller WHERE name='小米科技' AND status='1' AND address='西安市';
如果查询列,超出索引列,也会降低性能:
EXPLAIN SELECT name,status,address,password FROM tb_seller WHERE name='小米科技' AND status='1' AND address='西安市';
减少访问
避免对数据进行重复检索:能够一次连接就获取到结果的,就不用两次连接,这样可以大大减少对数据库无用的重复请求
-
查询数据:
SELECT id,name FROM tb_book; SELECT id,status FROM tb_book; -- 向数据库提交两次请求,数据库就要做两次查询操作 -- > 优化为: SELECT id,name,statu FROM tb_book; -
插入数据:
INSERT INTO tb_test VALUES(1,'Tom'); INSERT INTO tb_test VALUES(2,'Cat'); INSERT INTO tb_test VALUES(3,'Jerry'); -- 连接三次数据库 -- >优化为 INSERT INTO tb_test VALUES(1,'Tom'),(2,'Cat'),(3,'Jerry'); -- 连接一次 -
在事务中进行数据插入:
start transaction; INSERT INTO tb_test VALUES(1,'Tom'); INSERT INTO tb_test VALUES(2,'Cat'); INSERT INTO tb_test VALUES(3,'Jerry'); commit; -- 手动提交,分段提交 -
数据有序插入:
INSERT INTO tb_test VALUES(1,'Tom'); INSERT INTO tb_test VALUES(2,'Cat'); INSERT INTO tb_test VALUES(3,'Jerry');
增加 cache 层:在应用中增加缓存层来达到减轻数据库负担的目的。可以部分数据从数据库中抽取出来放到应用端以文本方式存储,或者使用框架(Mybatis)提供的一级缓存 / 二级缓存,或者使用 Redis 数据库来缓存数据
数据插入
当使用 load 命令导入数据的时候,适当的设置可以提高导入的效率:

LOAD DATA LOCAL INFILE = '/home/seazean/sql1.log' INTO TABLE `tb_user_1` FIELD TERMINATED BY ',' LINES TERMINATED BY '\n'; -- 文件格式如上图对于 InnoDB 类型的表,有以下几种方式可以提高导入的效率:
-
主键顺序插入:因为 InnoDB 类型的表是按照主键的顺序保存的,所以将导入的数据按照主键的顺序排列,可以有效的提高导入数据的效率,如果 InnoDB 表没有主键,那么系统会自动默认创建一个内部列作为主键
主键是否连续对性能影响不大,只要是递增的就可以,比如雪花算法产生的 ID 不是连续的,但是是递增的,因为递增可以让主键索引尽量地保持顺序插入,避免了页分裂,因此索引更紧凑
- 插入 ID 顺序排列数据:

- 插入 ID 无序排列数据:
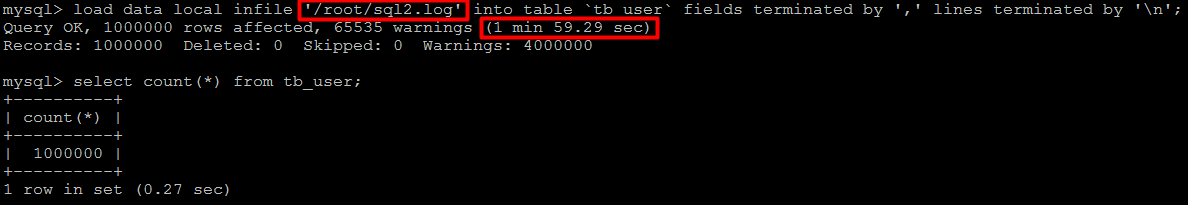
-
关闭唯一性校验:在导入数据前执行
SET UNIQUE_CHECKS=0,关闭唯一性校验;导入结束后执行SET UNIQUE_CHECKS=1,恢复唯一性校验,可以提高导入的效率。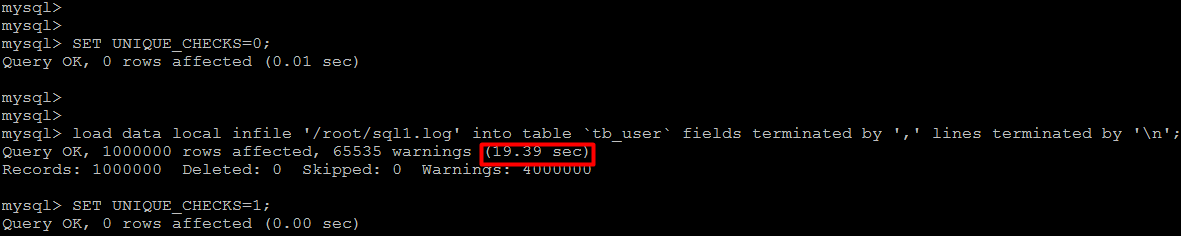
-
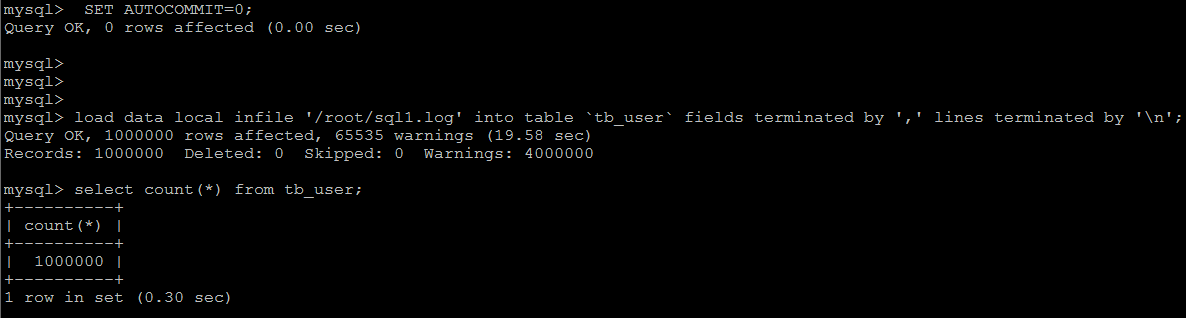
手动提交事务:如果应用使用自动提交的方式,建议在导入前执行
SET AUTOCOMMIT=0,关闭自动提交;导入结束后再打开自动提交,可以提高导入的效率。事务需要控制大小,事务太大可能会影响执行的效率。MySQL 有 innodb_log_buffer_size 配置项,超过这个值的日志会写入磁盘数据,效率会下降,所以在事务大小达到配置项数据级前进行事务提交可以提高效率
分组排序
ORDER
数据准备:
CREATE TABLE `emp` (
`id` INT(11) NOT NULL AUTO_INCREMENT,
`name` VARCHAR(100) NOT NULL,
`age` INT(3) NOT NULL,
`salary` INT(11) DEFAULT NULL,
PRIMARY KEY (`id`)
) ENGINE=INNODB DEFAULT CHARSET=utf8mb4;
INSERT INTO `emp` (`id`, `name`, `age`, `salary`) VALUES('1','Tom','25','2300');-- ...
CREATE INDEX idx_emp_age_salary ON emp(age, salary);-
第一种是通过对返回数据进行排序,所有不通过索引直接返回结果的排序都叫 FileSort 排序,会在内存中重新排序
EXPLAIN SELECT * FROM emp ORDER BY age DESC; -- 年龄降序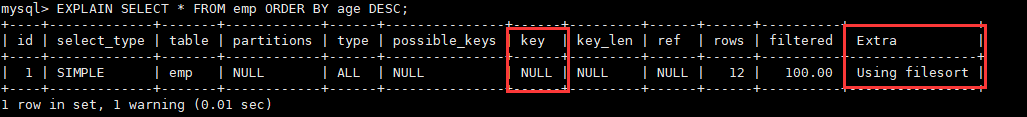
-
第二种通过有序索引顺序扫描直接返回有序数据,这种情况为 Using index,不需要额外排序,操作效率高
EXPLAIN SELECT id, age, salary FROM emp ORDER BY age DESC;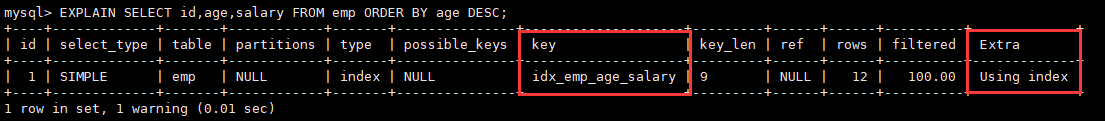
-
多字段排序:
EXPLAIN SELECT id,age,salary FROM emp ORDER BY age DESC, salary DESC; EXPLAIN SELECT id,age,salary FROM emp ORDER BY salary DESC, age DESC; EXPLAIN SELECT id,age,salary FROM emp ORDER BY age DESC, salary ASC;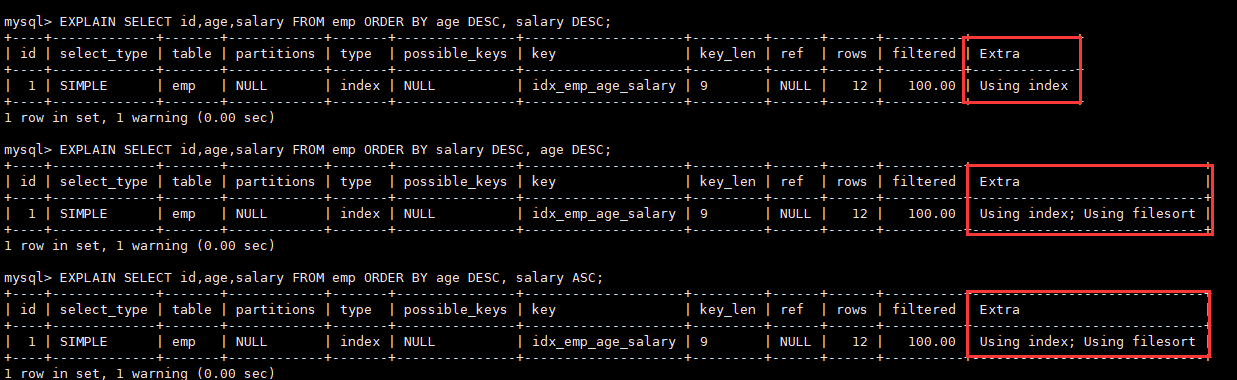
尽量减少额外的排序,通过索引直接返回有序数据。需要满足 Order by 使用相同的索引、Order By 的顺序和索引顺序相同、Order by 的字段都是升序或都是降序,否则需要额外的操作,就会出现 FileSort
-
ORDER BY RAND() 命令用来进行随机排序,会使用了临时内存表,临时内存表排序的时使用 rowid 排序方法
优化方式:创建合适的索引能够减少 Filesort 的出现,但是某些情况下条件限制不能让 Filesort 消失,就要加快 Filesort 的排序操作
内存临时表,MySQL 有两种 Filesort 排序算法:
-
rowid 排序:首先根据条件取出排序字段和信息,然后在排序区 sort buffer(Server 层)中排序,如果 sort buffer 不够,则在临时表 temporary table 中存储排序结果。完成排序后再根据行指针回表读取记录,该操作可能会导致大量随机 I/O 操作
说明:对于临时内存表,回表过程只是简单地根据数据行的位置,直接访问内存得到数据,不会导致多访问磁盘,优先选择该方式
-
全字段排序:一次性取出满足条件的所有数据,需要回表,然后在排序区 sort buffer 中排序后直接输出结果集。排序时内存开销较大,但是排序效率比两次扫描算法高
具体的选择方式:
-
MySQL 通过比较系统变量 max_length_for_sort_data 的大小和 Query 语句取出的字段的大小,来判定使用哪种排序算法。如果前者大,则说明 sort buffer 空间足够,使用第二种优化之后的算法,否则使用第一种。
-
可以适当提高 sort_buffer_size 和 max_length_for_sort_data 系统变量,来增大排序区的大小,提高排序的效率
SET @@max_length_for_sort_data = 10000; -- 设置全局变量 SET max_length_for_sort_data = 10240; -- 设置会话变量 SHOW VARIABLES LIKE 'max_length_for_sort_data'; -- 默认1024 SHOW VARIABLES LIKE 'sort_buffer_size'; -- 默认262114
磁盘临时表:排序使用优先队列(堆)的方式
GROUP
GROUP BY 也会进行排序操作,与 ORDER BY 相比,GROUP BY 主要只是多了排序之后的分组操作,所以在 GROUP BY 的实现过程中,与 ORDER BY 一样也可以利用到索引
-
分组查询:
DROP INDEX idx_emp_age_salary ON emp; EXPLAIN SELECT age,COUNT(*) FROM emp GROUP BY age;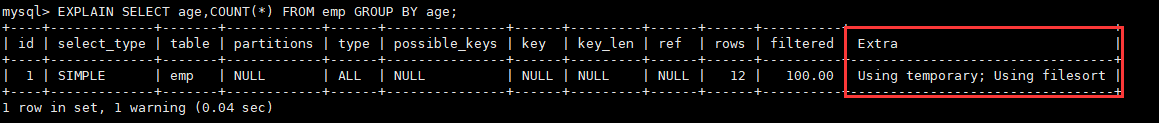
Using temporary:表示 MySQL 需要使用临时表(不是 sort buffer)来存储结果集,常见于排序和分组查询
-
查询包含 GROUP BY 但是用户想要避免排序结果的消耗, 则可以执行 ORDER BY NULL 禁止排序:
EXPLAIN SELECT age,COUNT(*) FROM emp GROUP BY age ORDER BY NULL;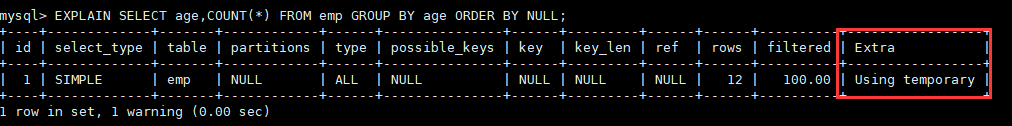
-
创建索引:索引本身有序,不需要临时表,也不需要再额外排序
CREATE INDEX idx_emp_age_salary ON emp(age, salary);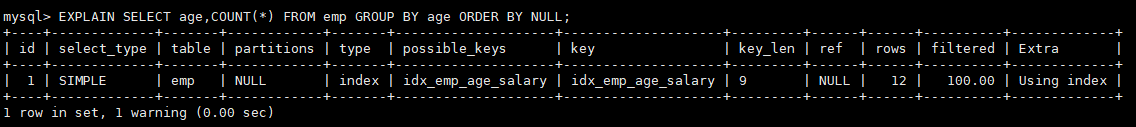
-
数据量很大时,使用 SQL_BIG_RESULT 提示优化器直接使用直接用磁盘临时表
联合查询
对于包含 OR 的查询子句,如果要利用索引,则 OR 之间的每个条件列都必须用到索引,而且不能使用到条件之间的复合索引,如果没有索引,则应该考虑增加索引
-
执行查询语句:
EXPLAIN SELECT * FROM emp WHERE id = 1 OR age = 30; -- 两个索引,并且不是复合索引
Extra: Using sort_union(idx_emp_age_salary,PRIMARY); Using where -
使用 UNION 替换 OR,求并集:
注意:该优化只针对多个索引列有效,如果有列没有被索引,查询效率可能会因为没有选择 OR 而降低
EXPLAIN SELECT * FROM emp WHERE id = 1 UNION SELECT * FROM emp WHERE age = 30;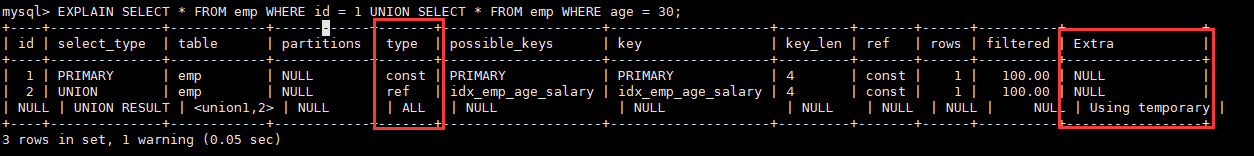
-
UNION 要优于 OR 的原因:
- UNION 语句的 type 值为 ref,OR 语句的 type 值为 range
- UNION 语句的 ref 值为 const,OR 语句的 ref 值为 null,const 表示是常量值引用,非常快
嵌套查询
MySQL 4.1 版本之后,开始支持 SQL 的子查询
- 可以使用 SELECT 语句来创建一个单列的查询结果,然后把结果作为过滤条件用在另一个查询中
- 使用子查询可以一次性的完成逻辑上需要多个步骤才能完成的 SQL 操作,同时也可以避免事务或者表锁死
- 在有些情况下,子查询是可以被更高效的连接(JOIN)替代
例如查找有角色的所有的用户信息:
-
执行计划:
EXPLAIN SELECT * FROM t_user WHERE id IN (SELECT user_id FROM user_role);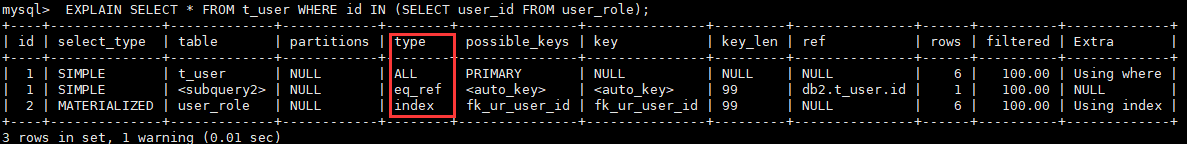
-
优化后:
EXPLAIN SELECT * FROM t_user u , user_role ur WHERE u.id = ur.user_id;
连接查询之所以效率更高 ,是因为不需要在内存中创建临时表来完成逻辑上需要两个步骤的查询工作
分页查询
一般分页查询时,通过创建覆盖索引能够比较好地提高性能
一个常见的问题是 LIMIT 200000,10,此时需要 MySQL 扫描前 200010 记录,仅仅返回 200000 - 200010 之间的记录,其他记录丢弃,查询排序的代价非常大
-
分页查询:
EXPLAIN SELECT * FROM tb_user_1 LIMIT 200000,10;
-
优化方式一:内连接查询,在索引列 id 上完成排序分页操作,最后根据主键关联回原表查询所需要的其他列内容
EXPLAIN SELECT * FROM tb_user_1 t,(SELECT id FROM tb_user_1 ORDER BY id LIMIT 200000,10) a WHERE t.id = a.id;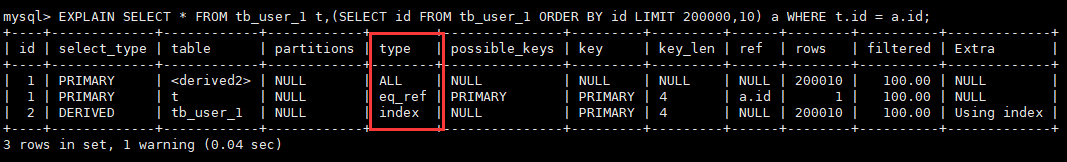
-
优化方式二:方案适用于主键自增的表,可以把 LIMIT 查询转换成某个位置的查询
EXPLAIN SELECT * FROM tb_user_1 WHERE id > 200000 LIMIT 10; -- 写法 1 EXPLAIN SELECT * FROM tb_user_1 WHERE id BETWEEN 200000 and 200010; -- 写法 2
使用提示
SQL 提示,是优化数据库的一个重要手段,就是在 SQL 语句中加入一些提示来达到优化操作的目的
-
USE INDEX:在查询语句中表名的后面添加 USE INDEX 来提供 MySQL 去参考的索引列表,可以让 MySQL 不再考虑其他可用的索引
CREATE INDEX idx_seller_name ON tb_seller(name); EXPLAIN SELECT * FROM tb_seller USE INDEX(idx_seller_name) WHERE name='小米科技';
-
IGNORE INDEX:让 MySQL 忽略一个或者多个索引,则可以使用 IGNORE INDEX 作为提示
EXPLAIN SELECT * FROM tb_seller IGNORE INDEX(idx_seller_name) WHERE name = '小米科技';
-
FORCE INDEX:强制 MySQL 使用一个特定的索引
EXPLAIN SELECT * FROM tb_seller FORCE INDEX(idx_seller_name_sta_addr) WHERE NAME='小米科技';
统计计数
在不同的 MySQL 引擎中,count(*) 有不同的实现方式:
- MyISAM 引擎把一个表的总行数存在了磁盘上,因此执行 count(*) 的时候会直接返回这个数,效率很高,但不支持事务
- show table status 命令通过采样估算可以快速获取,但是不准确
- InnoDB 表执行 count(*) 会遍历全表,虽然结果准确,但会导致性能问题
解决方案:
-
计数保存在 Redis 中,但是更新 MySQL 和 Redis 的操作不是原子的,会存在数据一致性的问题
-
计数直接放到数据库里单独的一张计数表中,利用事务解决计数精确问题:
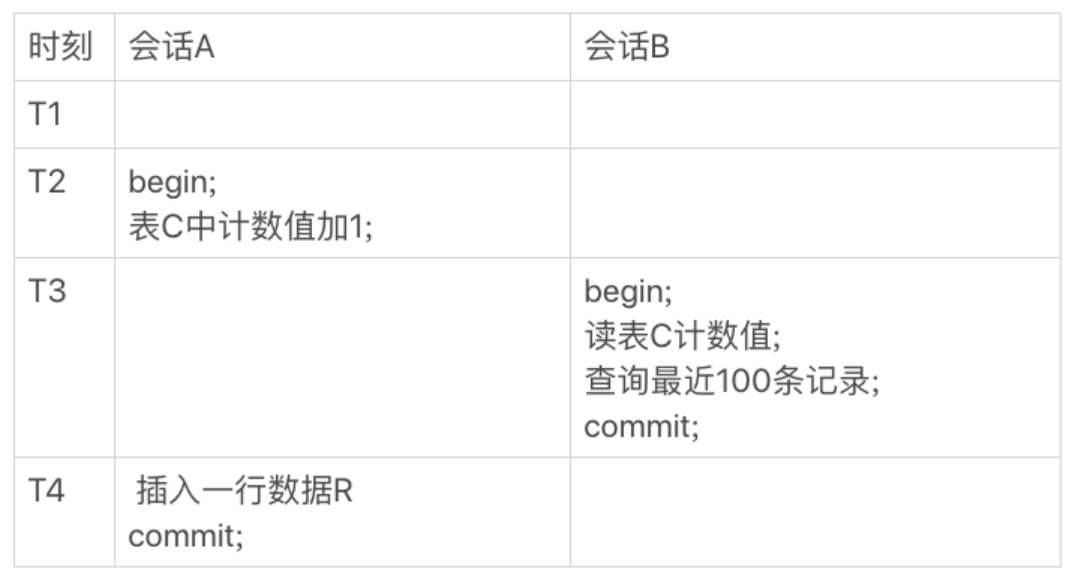
会话 B 的读操作在 T3 执行的,这时更新事务还没有提交,所以计数值加 1 这个操作对会话 B 还不可见,因此会话 B 查询的计数值和最近 100 条记录,返回的结果逻辑上就是一致的
并发系统性能的角度考虑,应该先插入操作记录再更新计数表,因为更新计数表涉及到行锁的竞争,先插入再更新能最大程度地减少事务之间的锁等待,提升并发度
count 函数的按照效率排序:count(字段) < count(主键id) < count(1) ≈ count(*),所以建议尽量使用 count(*)
- count(主键 id):InnoDB 引擎会遍历整张表,把每一行的 id 值都取出来返回给 Server 层,Server 判断 id 不为空就按行累加
- count(1):InnoDB 引擎遍历整张表但不取值,Server 层对于返回的每一行,放一个数字 1 进去,判断不为空就按行累加
- count(字段):如果这个字段是定义为 not null 的话,一行行地从记录里面读出这个字段,判断不能为 null,按行累加;如果这个字段定义允许为 null,那么执行的时候,判断到有可能是 null,还要把值取出来再判断一下,不是 null 才累加
- count(*):不取值,按行累加
参考文章:https://time.geekbang.org/column/article/72775