SYSTEM
索引优化
src/content/notes/system/MySQL-索引优化.md 索引优化
创建索引
索引是数据库优化最重要的手段之一,通过索引通常可以帮助用户解决大多数的 MySQL 的性能优化问题
CREATE TABLE `tb_seller` (
`sellerid` varchar (100),
`name` varchar (100),
`nickname` varchar (50),
`password` varchar (60),
`status` varchar (1),
`address` varchar (100),
`createtime` datetime,
PRIMARY KEY(`sellerid`)
)ENGINE=INNODB DEFAULT CHARSET=utf8mb4;
INSERT INTO `tb_seller` (`sellerid`, `name`, `nickname`, `password`, `status`, `address`, `createtime`) values('xiaomi','小米科技','小米官方旗舰店','e10adc3949ba59abbe56e057f20f883e','1','西安市','2088-01-01 12:00:00');
CREATE INDEX idx_seller_name_sta_addr ON tb_seller(name, status, address); # 联合索引
避免失效
语句错误
-
全值匹配:对索引中所有列都指定具体值,这种情况索引生效,执行效率高
EXPLAIN SELECT * FROM tb_seller WHERE name='小米科技' AND status='1' AND address='西安市';
-
最左前缀法则:联合索引遵守最左前缀法则
匹配最左前缀法则,走索引:
EXPLAIN SELECT * FROM tb_seller WHERE name='小米科技'; EXPLAIN SELECT * FROM tb_seller WHERE name='小米科技' AND status='1';
违法最左前缀法则 , 索引失效:
EXPLAIN SELECT * FROM tb_seller WHERE status='1'; EXPLAIN SELECT * FROM tb_seller WHERE status='1' AND address='西安市';
如果符合最左法则,但是出现跳跃某一列,只有最左列索引生效:
EXPLAIN SELECT * FROM tb_seller WHERE name='小米科技' AND address='西安市';
虽然索引列失效,但是系统会使用了索引下推进行了优化
-
范围查询右边的列,不能使用索引:
EXPLAIN SELECT * FROM tb_seller WHERE name='小米科技' AND status>'1' AND address='西安市';根据前面的两个字段 name , status 查询是走索引的, 但是最后一个条件 address 没有用到索引,使用了索引下推

-
在索引列上函数或者运算(+ - 数值)操作, 索引将失效:会破坏索引值的有序性
EXPLAIN SELECT * FROM tb_seller WHERE SUBSTRING(name,3,2) = '科技';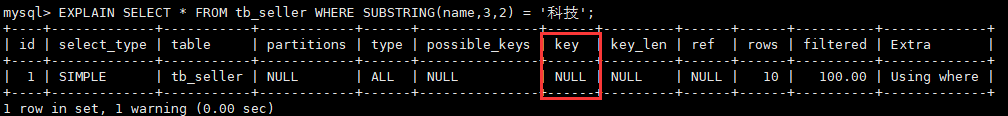
-
字符串不加单引号,造成索引失效:隐式类型转换,当字符串和数字比较时会把字符串转化为数字
没有对字符串加单引号,查询优化器会调用 CAST 函数将 status 转换为 int 进行比较,造成索引失效
EXPLAIN SELECT * FROM tb_seller WHERE name='小米科技' AND status = 1;
如果 status 是 int 类型,SQL 为
SELECT * FROM tb_seller WHERE status = '1'并不会造成索引失效,因为会将'1'转换为1,并不会对索引列产生操作 -
多表连接查询时,如果两张表的字符集不同,会造成索引失效,因为会进行类型转换
解决方法:CONVERT 函数是加在输入参数上、修改表的字符集
-
用 OR 分割条件,索引失效,导致全表查询:
OR 前的条件中的列有索引而后面的列中没有索引或 OR 前后两个列是同一个复合索引,都造成索引失效
EXPLAIN SELECT * FROM tb_seller WHERE name='阿里巴巴' OR createtime = '2088-01-01 12:00:00'; EXPLAIN SELECT * FROM tb_seller WHERE name='小米科技' OR status='1';
AND 分割的条件不影响:
EXPLAIN SELECT * FROM tb_seller WHERE name='阿里巴巴' AND createtime = '2088-01-01 12:00:00';
-
以 % 开头的 LIKE 模糊查询,索引失效:
如果是尾部模糊匹配,索引不会失效;如果是头部模糊匹配,索引失效
EXPLAIN SELECT * FROM tb_seller WHERE name like '%科技%';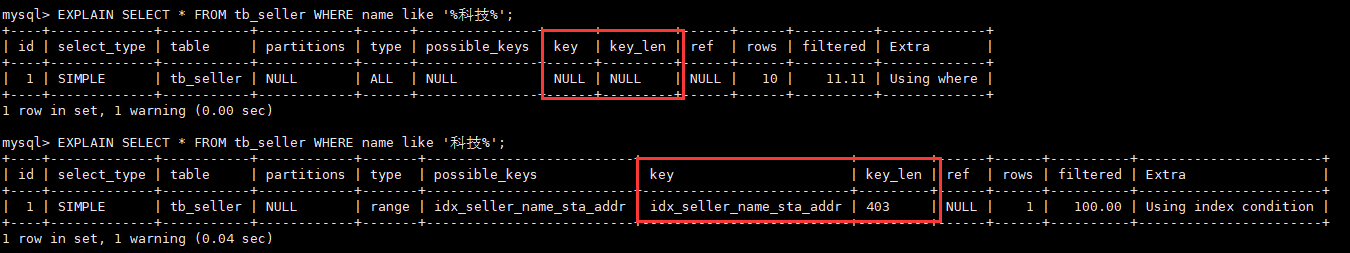
解决方案:通过覆盖索引来解决
EXPLAIN SELECT sellerid,name,status FROM tb_seller WHERE name like '%科技%';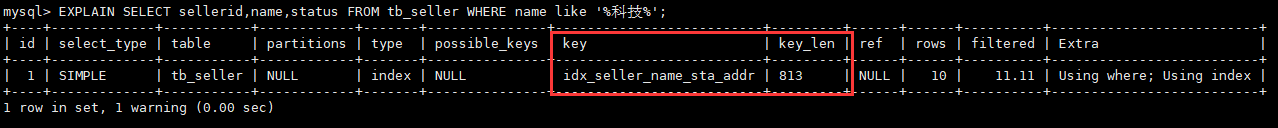
原因:在覆盖索引的这棵 B+ 数上只需要进行 like 的匹配,或者是基于覆盖索引查询再进行 WHERE 的判断就可以获得结果
系统优化
系统优化为全表扫描:
-
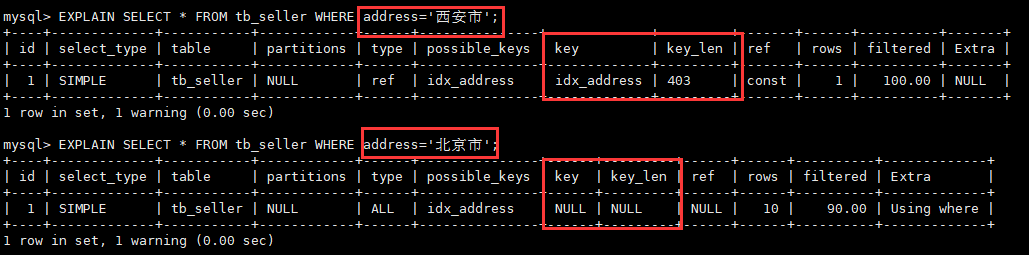
如果 MySQL 评估使用索引比全表更慢,则不使用索引,索引失效:
CREATE INDEX idx_address ON tb_seller(address); EXPLAIN SELECT * FROM tb_seller WHERE address='西安市'; EXPLAIN SELECT * FROM tb_seller WHERE address='北京市';北京市的键值占 9/10(区分度低),所以优化为全表扫描,type = ALL
-
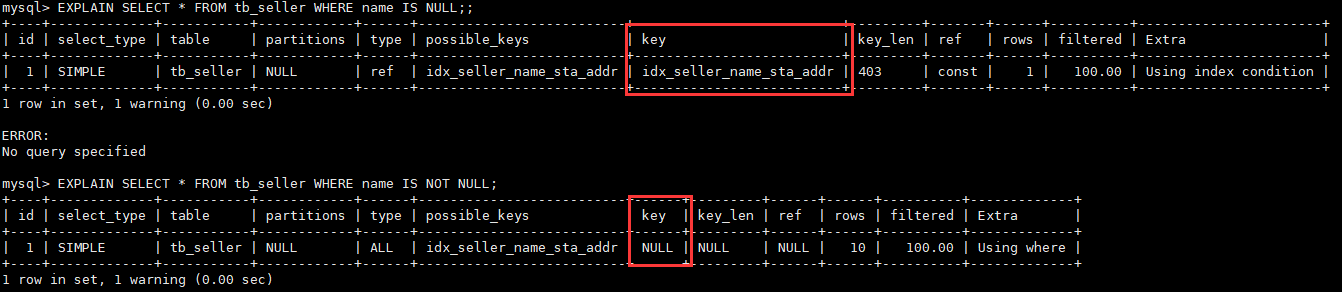
IS NULL、IS NOT NULL 有时索引失效:
EXPLAIN SELECT * FROM tb_seller WHERE name IS NULL; EXPLAIN SELECT * FROM tb_seller WHERE name IS NOT NULL;NOT NULL 失效的原因是 name 列全部不是 null,优化为全表扫描,当 NULL 过多时,IS NULL 失效
-
IN 肯定会走索引,但是当 IN 的取值范围较大时会导致索引失效,走全表扫描:
EXPLAIN SELECT * FROM tb_seller WHERE sellerId IN ('alibaba','huawei');-- 都走索引 EXPLAIN SELECT * FROM tb_seller WHERE sellerId NOT IN ('alibaba','huawei'); -
MySQL 实战 45 讲该章节最后提出了一种慢查询场景,获取到数据以后 Server 层还会做判断
底层原理
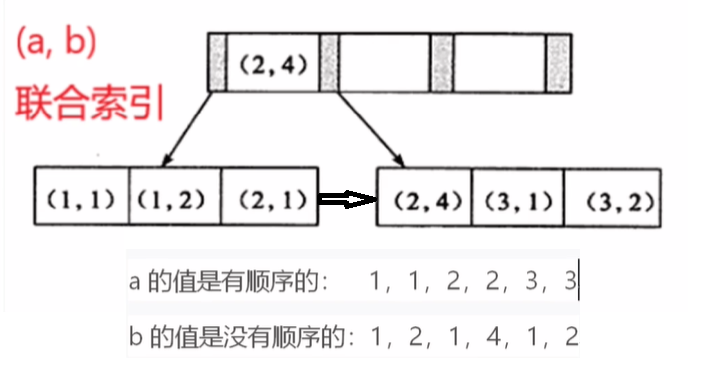
索引失效一般是针对联合索引,联合索引一般由几个字段组成,排序方式是先按照第一个字段进行排序,然后排序第二个,依此类推,图示(a, b)索引,a 相等的情况下 b 是有序的
-
最左前缀法则:当不匹配前面的字段的时候,后面的字段都是无序的。这种无序不仅体现在叶子节点,也会导致查询时扫描的非叶子节点也是无序的,因为索引树相当于忽略的第一个字段,就无法使用二分查找
-
范围查询右边的列,不能使用索引,比如语句:
WHERE a > 1 AND b = 1,在 a 大于 1 的时候,b 是无序的,a > 1 是扫描时有序的,但是找到以后进行寻找 b 时,索引树就不是有序的了
-
以 % 开头的 LIKE 模糊查询,索引失效,比如语句:
WHERE a LIKE '%d',前面的不确定,导致不符合最左匹配,直接去索引中搜索以 d 结尾的节点,所以没有顺序
参考文章:https://mp.weixin.qq.com/s/B_M09dzLe9w7cT46rdGIeQ
查看索引
SHOW STATUS LIKE 'Handler_read%';
SHOW GLOBAL STATUS LIKE 'Handler_read%';
-
Handler_read_first:索引中第一条被读的次数,如果较高,表示服务器正执行大量全索引扫描(这个值越低越好)
-
Handler_read_key:如果索引正在工作,这个值代表一个行被索引值读的次数,值越低表示索引不经常使用(这个值越高越好)
-
Handler_read_next:按照键顺序读下一行的请求数,如果范围约束或执行索引扫描来查询索引列,值增加
-
Handler_read_prev:按照键顺序读前一行的请求数,该读方法主要用于优化 ORDER BY … DESC
-
Handler_read_rnd:根据固定位置读一行的请求数,如果执行大量查询并对结果进行排序则该值较高,可能是使用了大量需要 MySQL 扫描整个表的查询或连接,这个值较高意味着运行效率低,应该建立索引来解决
-
Handler_read_rnd_next:在数据文件中读下一行的请求数,如果正进行大量的表扫描,该值较高,说明表索引不正确或写入的查询没有利用索引