SYSTEM
连接查询
src/content/notes/system/连接查询.md 连接查询
内外连接
内连接
连接查询的是两张表有交集的部分数据,两张表分为驱动表和被驱动表,如果结果集中的每条记录都是两个表相互匹配的组合,则称这样的结果集为笛卡尔积
内连接查询,若驱动表中的记录在被驱动表中找不到匹配的记录时,则该记录不会加到最后的结果集
-
显式内连接:
SELECT 列名 FROM 表名1 [INNER] JOIN 表名2 ON 条件; -
隐式内连接:内连接中 WHERE 子句和 ON 子句是等价的
SELECT 列名 FROM 表名1,表名2 WHERE 条件;
STRAIGHT_JOIN与 JOIN 类似,只不过左表始终在右表之前读取,只适用于内连接
外连接
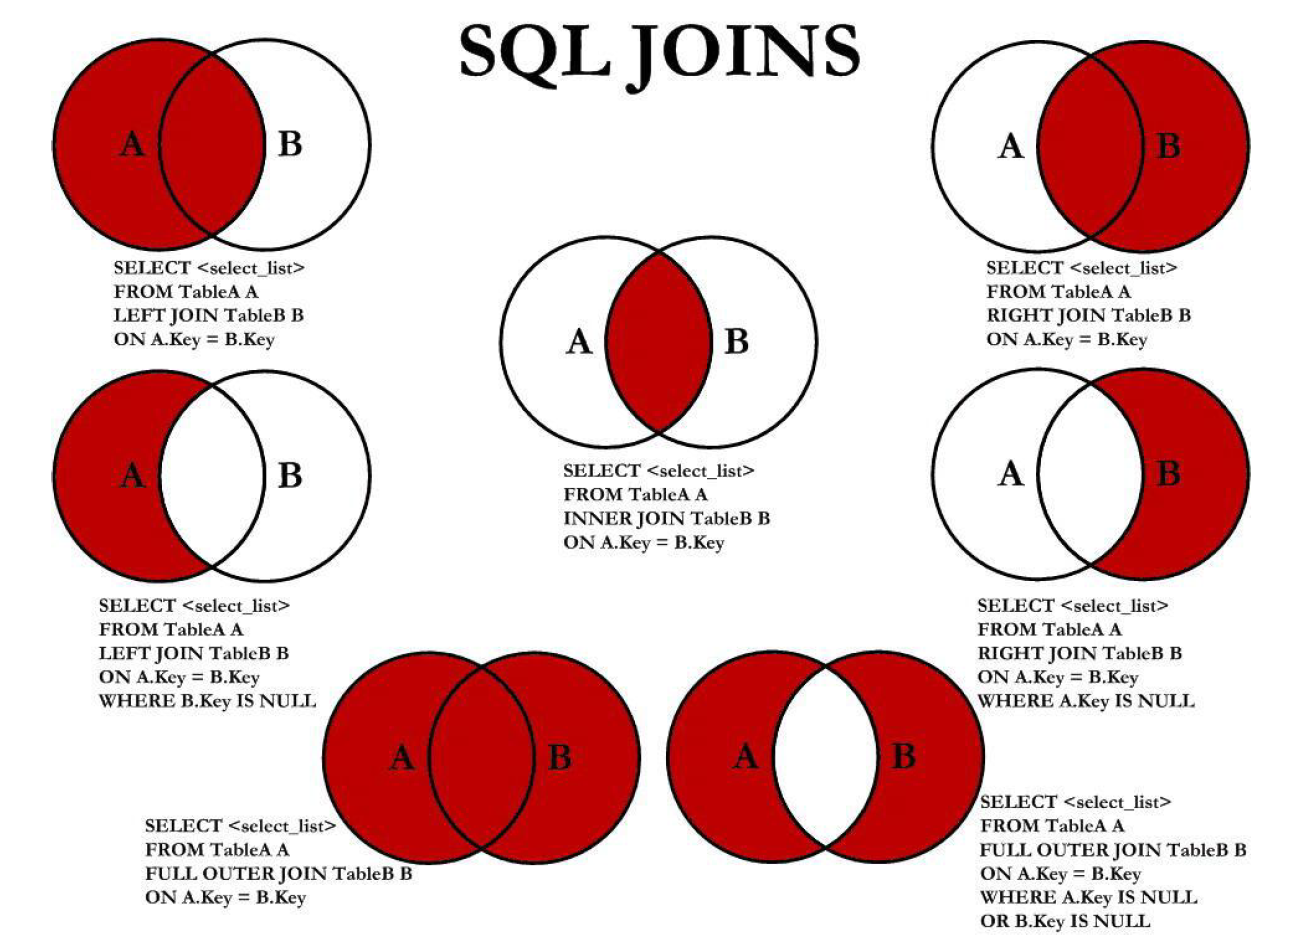
外连接查询,若驱动表中的记录在被驱动表中找不到匹配的记录时,则该记录也会加到最后的结果集,只是对于被驱动表中不匹配过滤条件的记录,各个字段使用 NULL 填充
应用实例:查学生成绩,也想展示出缺考的人的成绩
-
左外连接:选择左侧的表为驱动表,查询左表的全部数据,和左右两张表有交集部分的数据
SELECT 列名 FROM 表名1 LEFT [OUTER] JOIN 表名2 ON 条件; -
右外连接:选择右侧的表为驱动表,查询右表的全部数据,和左右两张表有交集部分的数据
SELECT 列名 FROM 表名1 RIGHT [OUTER] JOIN 表名2 ON 条件;
关联查询
自关联查询:同一张表中有数据关联,可以多次查询这同一个表
-
数据准备
-- 创建员工表 CREATE TABLE employee( id INT PRIMARY KEY AUTO_INCREMENT, -- 员工编号 NAME VARCHAR(20), -- 员工姓名 mgr INT, -- 上级编号 salary DOUBLE -- 员工工资 ); -- 添加数据 INSERT INTO employee VALUES (1001,'孙悟空',1005,9000.00),..,(1009,'宋江',NULL,16000.00);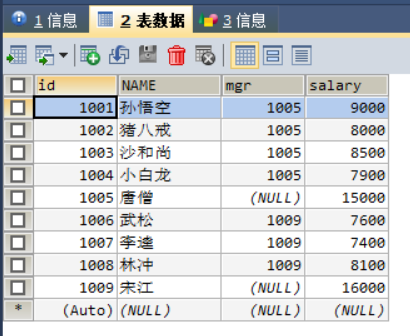
-
数据查询
-- 查询所有员工的姓名及其直接上级的姓名,没有上级的员工也需要查询 /* 分析 员工信息 employee表 条件:employee.mgr = employee.id 查询左表的全部数据,和左右两张表有交集部分数据,左外连接 */ SELECT e1.id, e1.name, e1.mgr, e2.id, e2.name FROM employee e1 LEFT OUTER JOIN employee e2 ON e1.mgr = e2.id; -
查询结果
id name mgr id name 1001 孙悟空 1005 1005 唐僧 1002 猪八戒 1005 1005 唐僧 1003 沙和尚 1005 1005 唐僧 1004 小白龙 1005 1005 唐僧 1005 唐僧 NULL NULL NULL 1006 武松 1009 1009 宋江 1007 李逵 1009 1009 宋江 1008 林冲 1009 1009 宋江 1009 宋江 NULL NULL NULL
连接原理
Index Nested-Loop Join 算法:查询驱动表得到数据集,然后根据数据集中的每一条记录的关联字段再分别到被驱动表中查找匹配(走索引),所以驱动表只需要访问一次,被驱动表要访问多次
MySQL 将查询驱动表后得到的记录成为驱动表的扇出,连接查询的成本:单次访问驱动表的成本 + 扇出值 * 单次访问被驱动表的成本,优化器会选择成本最小的表连接顺序(确定谁是驱动表,谁是被驱动表)生成执行计划,进行连接查询,优化方式:
- 减少驱动表的扇出(让数据量小的表来做驱动表)
- 降低访问被驱动表的成本
说明:STRAIGHT_JOIN 是查一条驱动表,然后根据关联字段去查被驱动表,要访问多次驱动表,所以需要优化为 INL 算法
Block Nested-Loop Join 算法:一种空间换时间的优化方式,基于块的循环连接,执行连接查询前申请一块固定大小的内存作为连接缓冲区 Join Buffer,先把若干条驱动表中的扇出暂存在缓冲区,每一条被驱动表中的记录一次性的与 Buffer 中多条记录进行匹配(扫描全部数据,一条一条的匹配),因为是在内存中完成,所以速度快,并且降低了 I/O 成本
Join Buffer 可以通过参数 join_buffer_size 进行配置,默认大小是 256 KB
在成本分析时,对于很多张表的连接查询,连接顺序有非常多,MySQL 如果挨着进行遍历计算成本,会消耗很多资源
-
提前结束某种连接顺序的成本评估:维护一个全局变量记录当前成本最小的连接方式,如果一种顺序只计算了一部分就已经超过了最小成本,可以提前结束计算
-
系统变量 optimizer_search_depth:如果连接表的个数小于该变量,就继续穷举分析每一种连接数量,反之只对数量与 depth 值相同的表进行分析,该值越大成本分析的越精确
-
系统变量 optimizer_prune_level:控制启发式规则的启用,这些规则就是根据以往经验指定的,不满足规则的连接顺序不分析成本
连接优化
BKA
Batched Key Access 算法是对 NLJ 算法的优化,在读取被驱动表的记录时使用顺序 IO,Extra 信息中会有 Batched Key Access 信息
使用 BKA 的表的 JOIN 过程如下:
- 连接驱动表将满足条件的记录放入 Join Buffer,并将两表连接的字段放入一个 DYNAMIC_ARRAY ranges 中
- 在进行表的过接过程中,会将 ranges 相关的信息传入 Buffer 中,进行被驱动表主建的查找及排序操作
- 调用步骤 2 中产生的有序主建,顺序读取被驱动表的数据
- 当缓冲区的数据被读完后,会重复进行步骤 2、3,直到记录被读取完
使用 BKA 优化需要设进行设置:
SET optimizer_switch='mrr=on,mrr_cost_based=off,batched_key_access=on';说明:前两个参数的作用是启用 MRR,因为 BKA 算法的优化要依赖于 MRR(系统优化 → 内存优化 → Read 详解)
BNL
问题
BNL 即 Block Nested-Loop Join 算法,由于要访问多次被驱动表,会产生两个问题:
-
Join 语句多次扫描一个冷表,并且语句执行时间小于 1 秒,就会在再次扫描冷表时,把冷表的数据页移到 LRU 链表头部,导致热数据被淘汰,影响业务的正常运行
这种情况冷表的数据量要小于整个 Buffer Pool 的 old 区域,能够完全放入 old 区,才会再次被读时加到 young,否则读取下一段时就已经把上一段淘汰
-
Join 语句在循环读磁盘和淘汰内存页,进入 old 区域的数据页很可能在 1 秒之内就被淘汰,就会导致 MySQL 实例的 Buffer Pool 在这段时间内 young 区域的数据页没有被合理地淘汰
大表 Join 操作虽然对 IO 有影响,但是在语句执行结束后对 IO 的影响随之结束。但是对 Buffer Pool 的影响就是持续性的,需要依靠后续的查询请求慢慢恢复内存命中率
优化
将 BNL 算法转成 BKA 算法,优化方向:
- 在被驱动表上建索引,这样就可以根据索引进行顺序 IO
- 使用临时表,在临时表上建立索引,将被驱动表和临时表进行连接查询
驱动表 t1,被驱动表 t2,使用临时表的工作流程:
- 把表 t1 中满足条件的数据放在临时表 tmp_t 中
- 给临时表 tmp_t 的关联字段加上索引,使用 BKA 算法
- 让表 t2 和 tmp_t 做 Join 操作(临时表是被驱动表)
补充:MySQL 8.0 支持 hash join,join_buffer 维护的不再是一个无序数组,而是一个哈希表,查询效率更高,执行效率比临时表更高