SYSTEM
读写分离
src/content/notes/system/读写分离.md 读写分离
读写延迟
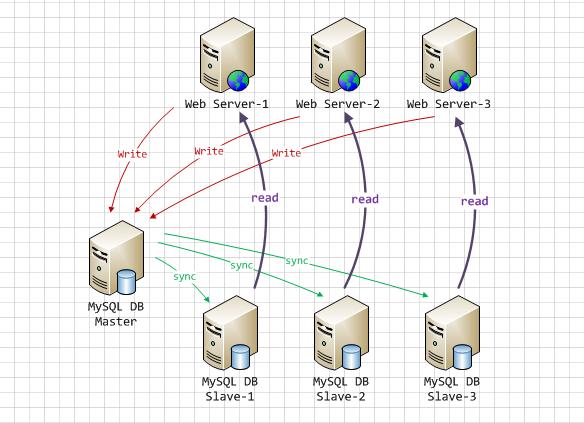
读写分离:可以降低主库的访问压力,提高系统的并发能力
- 主库不建查询的索引,从库建查询的索引。因为索引需要维护的,比如插入一条数据,不仅要在聚簇索引上面插入,对应的二级索引也得插入
- 将读操作分到从库了之后,可以在主库把查询要用的索引删了,减少写操作对主库的影响
读写分离产生了读写延迟,造成数据的不一致性。假如客户端执行完一个更新事务后马上发起查询,如果查询选择的是从库的话,可能读到的还是以前的数据,叫过期读
解决方案:
- 强制将写之后立刻读的操作转移到主库,比如刚注册的用户,直接登录从库查询可能查询不到,先走主库登录
- 二次查询,如果从库查不到数据,则再去主库查一遍,由 API 封装,比较简单,但导致主库压力大
- 更新主库后,读从库之前先 sleep 一下,类似于执行一条
select sleep(1)命令,大多数情况下主备延迟在 1 秒之内
确保机制
无延迟
确保主备无延迟的方法:
- 每次从库执行查询请求前,先判断 seconds_behind_master 是否已经等于 0,如果不等于那就等到参数变为 0 执行查询请求
- 对比位点,Master_Log_File 和 Read_Master_Log_Pos 表示的是读到的主库的最新位点,Relay_Master_Log_File 和 Exec_Master_Log_Pos 表示的是备库执行的最新位点,这两组值完全相同就说明接收到的日志已经同步完成
- 对比 GTID 集合,Retrieved_Gtid_Set 是备库收到的所有日志的 GTID 集合,Executed_Gtid_Set 是备库所有已经执行完成的 GTID 集合,如果这两个集合相同也表示备库接收到的日志都已经同步完成
半同步
半同步复制就是 semi-sync replication,适用于一主一备的场景,工作流程:
- 事务提交的时候,主库把 binlog 发给从库
- 从库收到 binlog 以后,发回给主库一个 ack,表示收到了
- 主库收到这个 ack 以后,才能给客户端返回事务完成的确认
在一主多从场景中,主库只要等到一个从库的 ack,就开始给客户端返回确认,这时在从库上执行查询请求,有两种情况:
- 如果查询是落在这个响应了 ack 的从库上,是能够确保读到最新数据
- 如果查询落到其他从库上,它们可能还没有收到最新的日志,就会产生过期读的问题
在业务更新的高峰期,主库的位点或者 GTID 集合更新很快,导致从库来不及处理,那么两个位点等值判断就会一直不成立,很可能出现从库上迟迟无法响应查询请求的情况
等位点
在从库执行判断位点的命令,参数 file 和 pos 指的是主库上的文件名和位置,timeout 可选,设置为正整数 N 表示最多等待 N 秒
SELECT master_pos_wait(file, pos[, timeout]);命令正常返回的结果是一个正整数 M,表示从命令开始执行,到应用完 file 和 pos 表示的 binlog 位置,执行了多少事务
- 如果执行期间,备库同步线程发生异常,则返回 NULL
- 如果等待超过 N 秒,就返回 -1
- 如果刚开始执行的时候,就发现已经执行过这个位置了,则返回 0
工作流程:先执行 trx1,再执行一个查询请求的逻辑,要保证能够查到正确的数据
- trx1 事务更新完成后,马上执行
show master status得到当前主库执行到的 File 和 Position - 选定一个从库执行判断位点语句,如果返回值是 >=0 的正整数,说明从库已经同步完事务,可以在这个从库执行查询语句
- 如果出现其他情况,需要到主库执行查询语句
注意:如果所有的从库都延迟超过 timeout 秒,查询压力就都跑到主库上,所以需要进行权衡
等GTID
数据库开启了 GTID 模式,MySQL 提供了判断 GTID 的命令
SELECT wait_for_executed_gtid_set(gtid_set [, timeout])- 等待直到这个库执行的事务中包含传入的 gtid_set,返回 0
- 超时返回 1
工作流程:先执行 trx1,再执行一个查询请求的逻辑,要保证能够查到正确的数据
- trx1 事务更新完成后,从返回包直接获取这个事务的 GTID,记为 gtid
- 选定一个从库执行查询语句,如果返回值是 0,则在这个从库执行查询语句,否则到主库执行查询语句
对比等待位点方法,减少了一次 show master status 的方法,将参数 session_track_gtids 设置为 OWN_GTID,然后通过 API 接口 mysql_session_track_get_first 从返回包解析出 GTID 的值即可
总结:所有的等待无延迟的方法,都需要根据具体的业务场景去判断实施
参考文章:https://time.geekbang.org/column/article/77636
负载均衡
负载均衡是应用中使用非常普遍的一种优化方法,机制就是利用某种均衡算法,将固定的负载量分布到不同的服务器上,以此来降低单台服务器的负载,达到优化的效果
-
分流查询:通过 MySQL 的主从复制,实现读写分离,使增删改操作走主节点,查询操作走从节点,从而可以降低单台服务器的读写压力
-
分布式数据库架构:适合大数据量、负载高的情况,具有良好的拓展性和高可用性。通过在多台服务器之间分布数据,可以实现在多台服务器之间的负载均衡,提高访问效率