SYSTEM
范式
src/content/notes/system/范式.md 范式
第一范式
建立科学的,规范的数据表就需要满足一些规则来优化数据的设计和存储,这些规则就称为范式
**1NF:**数据库表的每一列都是不可分割的原子数据项,不能是集合、数组等非原子数据项。即表中的某个列有多个值时,必须拆分为不同的列。简而言之,第一范式每一列不可再拆分,称为原子性
基本表:

第一范式表:

第二范式
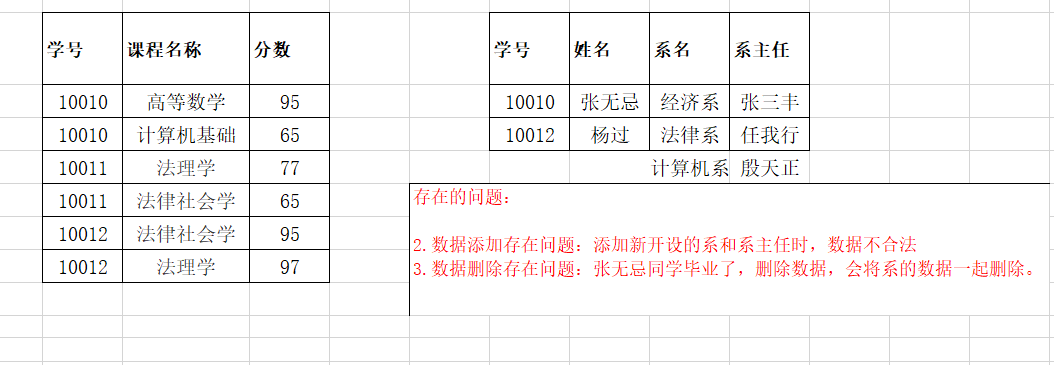
**2NF:**在满足第一范式的基础上,非主属性完全依赖于主码(主关键字、主键),消除非主属性对主码的部分函数依赖。简而言之,表中的每一个字段 (所有列)都完全依赖于主键,记录的唯一性
作用:遵守第二范式减少数据冗余,通过主键区分相同数据。
- 函数依赖:A → B,如果通过 A 属性(属性组)的值,可以确定唯一 B 属性的值,则称 B 依赖于 A
- 学号 → 姓名;(学号,课程名称) → 分数
- 完全函数依赖:A → B,如果A是一个属性组,则 B 属性值的确定需要依赖于 A 属性组的所有属性值
- (学号,课程名称) → 分数
- 部分函数依赖:A → B,如果 A 是一个属性组,则 B 属性值的确定只需要依赖于 A 属性组的某些属性值
- (学号,课程名称) → 姓名
- 传递函数依赖:A → B,B → C,如果通过A属性(属性组)的值,可以确定唯一 B 属性的值,在通过 B 属性(属性组)的值,可以确定唯一 C 属性的值,则称 C 传递函数依赖于 A
- 学号 → 系名,系名 → 系主任
- 码:如果在一张表中,一个属性或属性组,被其他所有属性所完全依赖,则称这个属性(属性组)为该表的码
- 该表中的码:(学号,课程名称)
- 主属性:码属性组中的所有属性
- 非主属性:除码属性组以外的属性
第三范式
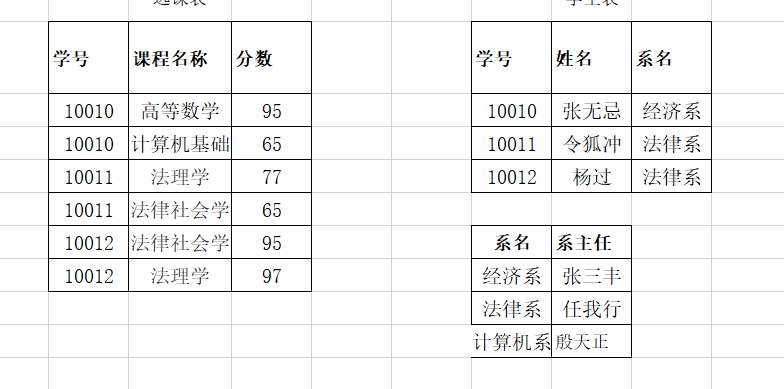
**3NF:**在满足第二范式的基础上,表中的任何属性不依赖于其它非主属性,消除传递依赖。简而言之,非主键都直接依赖于主键,而不是通过其它的键来间接依赖于主键。
作用:可以通过主键 id 区分相同数据,修改数据的时候只需要修改一张表(方便修改),反之需要修改多表。
总结
