SYSTEM
聚簇索引
src/content/notes/system/聚簇索引.md 聚簇索引
索引对比
聚簇索引是一种数据存储方式,并不是一种单独的索引类型
-
聚簇索引的叶子节点存放的是主键值和数据行,支持覆盖索引
-
非聚簇索引的叶子节点存放的是主键值或指向数据行的指针(由存储引擎决定)
在 Innodb 下主键索引是聚簇索引,在 MyISAM 下主键索引是非聚簇索引
Innodb
聚簇索引
在 Innodb 存储引擎,B+ 树索引可以分为聚簇索引(也称聚集索引、clustered index)和辅助索引(也称非聚簇索引或二级索引、secondary index、non-clustered index)
InnoDB 中,聚簇索引是按照每张表的主键构造一颗 B+ 树,叶子节点中存放的就是整张表的数据,将聚簇索引的叶子节点称为数据页
- 这个特性决定了数据也是索引的一部分,所以一张表只能有一个聚簇索引
- 辅助索引的存在不影响聚簇索引中数据的组织,所以一张表可以有多个辅助索引
聚簇索引的优点:
- 数据访问更快,聚簇索引将索引和数据保存在同一个 B+ 树中,因此从聚簇索引中获取数据比非聚簇索引更快
- 聚簇索引对于主键的排序查找和范围查找速度非常快
聚簇索引的缺点:
-
插入速度严重依赖于插入顺序,按照主键的顺序(递增)插入是最快的方式,否则将会出现页分裂,严重影响性能,所以对于 InnoDB 表,一般都会定义一个自增的 ID 列为主键
-
更新主键的代价很高,将会导致被更新的行移动,所以对于 InnoDB 表,一般定义主键为不可更新
-
二级索引访问需要两次索引查找,第一次找到主键值,第二次根据主键值找到行数据
辅助索引
在聚簇索引之上创建的索引称之为辅助索引,非聚簇索引都是辅助索引,像复合索引、前缀索引、唯一索引等
辅助索引叶子节点存储的是主键值,而不是数据的物理地址,所以访问数据需要二次查找,推荐使用覆盖索引,可以减少回表查询
检索过程:辅助索引找到主键值,再通过聚簇索引(二分)找到数据页,最后通过数据页中的 Page Directory(二分)找到对应的数据分组,遍历组内所所有的数据找到数据行
补充:无索引走全表查询,查到数据页后和上述步骤一致
索引实现
InnoDB 使用 B+Tree 作为索引结构,并且 InnoDB 一定有索引
主键索引:
-
在 InnoDB 中,表数据文件本身就是按 B+Tree 组织的一个索引结构,这个索引的 key 是数据表的主键,叶子节点 data 域保存了完整的数据记录
-
InnoDB 的表数据文件通过主键聚集数据,如果没有定义主键,会选择非空唯一索引代替,如果也没有这样的列,MySQL 会自动为 InnoDB 表生成一个隐含字段 row_id 作为主键,这个字段长度为 6 个字节,类型为长整形
辅助索引:
-
InnoDB 的所有辅助索引(二级索引)都引用主键作为 data 域
-
InnoDB 表是基于聚簇索引建立的,因此 InnoDB 的索引能提供一种非常快速的主键查找性能。不过辅助索引也会包含主键列,所以不建议使用过长的字段作为主键,过长的主索引会令辅助索引变得过大

MyISAM
非聚簇
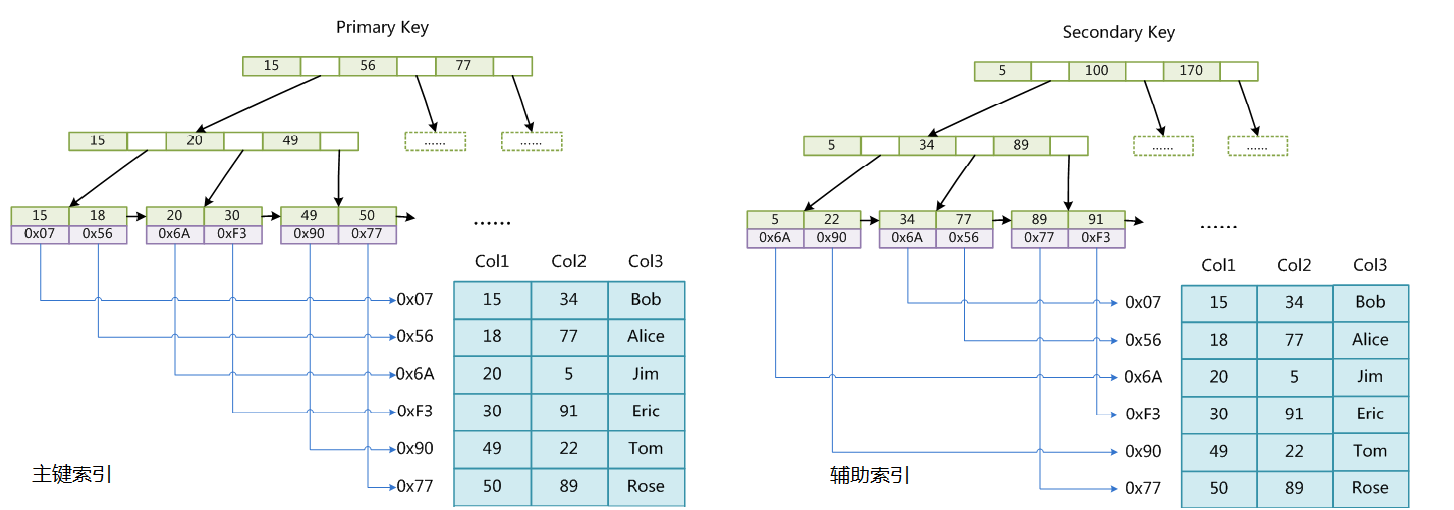
MyISAM 的主键索引使用的是非聚簇索引,索引文件和数据文件是分离的,索引文件仅保存数据的地址
- 主键索引 B+ 树的节点存储了主键,辅助键索引 B+ 树存储了辅助键,表数据存储在独立的地方,这两颗 B+ 树的叶子节点都使用一个地址指向真正的表数据,对于表数据来说,这两个键没有任何差别
- 由于索引树是独立的,通过辅助索引检索无需回表查询访问主键的索引树

索引实现
MyISAM 的索引方式也叫做非聚集的,之所以这么称呼是为了与 InnoDB 的聚集索引区分
主键索引:MyISAM 引擎使用 B+Tree 作为索引结构,叶节点的 data 域存放的是数据记录的地址
辅助索引:MyISAM 中主索引和辅助索引(Secondary key)在结构上没有任何区别,只是主索引要求 key 是唯一的,而辅助索引的 key 可以重复
参考文章:https://blog.csdn.net/lm1060891265/article/details/81482136