SYSTEM
缓冲优化
src/content/notes/system/缓冲优化.md 缓冲优化
优化原则
三个原则:
- 将尽量多的内存分配给 MySQL 做缓存,但也要给操作系统和其他程序预留足够内存
- MyISAM 存储引擎的数据文件读取依赖于操作系统自身的 IO 缓存,如果有 MyISAM 表,就要预留更多的内存给操作系统做 IO 缓存
- 排序区、连接区等缓存是分配给每个数据库会话(Session)专用的,值的设置要根据最大连接数合理分配,如果设置太大,不但浪费资源,而且在并发数较高时会导致物理内存耗尽
缓冲内存
Buffer Pool 本质上是 InnoDB 向操作系统申请的一段连续的内存空间。InnoDB 的数据是按数据页为单位来读写,每个数据页的大小默认是 16KB。数据是存放在磁盘中,每次读写数据都需要进行磁盘 IO 将数据读入内存进行操作,效率会很低,所以提供了 Buffer Pool 来暂存这些数据页,缓存中的这些页又叫缓冲页
工作原理:
- 从数据库读取数据时,会首先从缓存中读取,如果缓存中没有,则从磁盘读取后放入 Buffer Pool
- 向数据库写入数据时,会写入缓存,缓存中修改的数据会定期刷新到磁盘,这一过程称为刷脏
Buffer Pool 中每个缓冲页都有对应的控制信息,包括表空间编号、页号、偏移量、链表信息等,控制信息存放在占用的内存称为控制块,控制块与缓冲页是一一对应的,但并不是物理上相连的,都在缓冲池中
MySQL 提供了缓冲页的快速查找方式:哈希表,使用表空间号和页号作为 Key,缓冲页控制块的地址作为 Value 创建一个哈希表,获取数据页时根据 Key 进行哈希寻址:
- 如果不存在对应的缓存页,就从 free 链表中选一个空闲缓冲页,把磁盘中的对应页加载到该位置
- 如果存在对应的缓存页,直接获取使用,提高查询数据的效率
当内存数据页跟磁盘数据页内容不一致时,称这个内存页为脏页;内存数据写入磁盘后,内存和磁盘上的数据页一致,称为干净页
内存管理
Free 链表
MySQL 启动时完成对 Buffer Pool 的初始化,先向操作系统申请连续的内存空间,然后将内存划分为若干对控制块和缓冲页。为了区分空闲和已占用的数据页,将所有空闲缓冲页对应的控制块作为一个节点放入一个链表中,就是 Free 链表(空闲链表)

基节点:是一块单独申请的内存空间(占 40 字节),并不在 Buffer Pool 的那一大片连续内存空间里
磁盘加载页的流程:
- 从 Free 链表中取出一个空闲的缓冲页
- 把缓冲页对应的控制块的信息填上(页所在的表空间、页号之类的信息)
- 把缓冲页对应的 Free 链表节点(控制块)从链表中移除,表示该缓冲页已经被使用
参考文章:https://blog.csdn.net/li1325169021/article/details/121124440
Flush 链表
Flush 链表是一个用来存储脏页的链表,对于已经修改过的缓冲脏页,第一次修改后加入到链表头部,以后每次修改都不会重新加入,只修改部分控制信息,出于性能考虑并不是直接更新到磁盘,而是在未来的某个时间进行刷脏
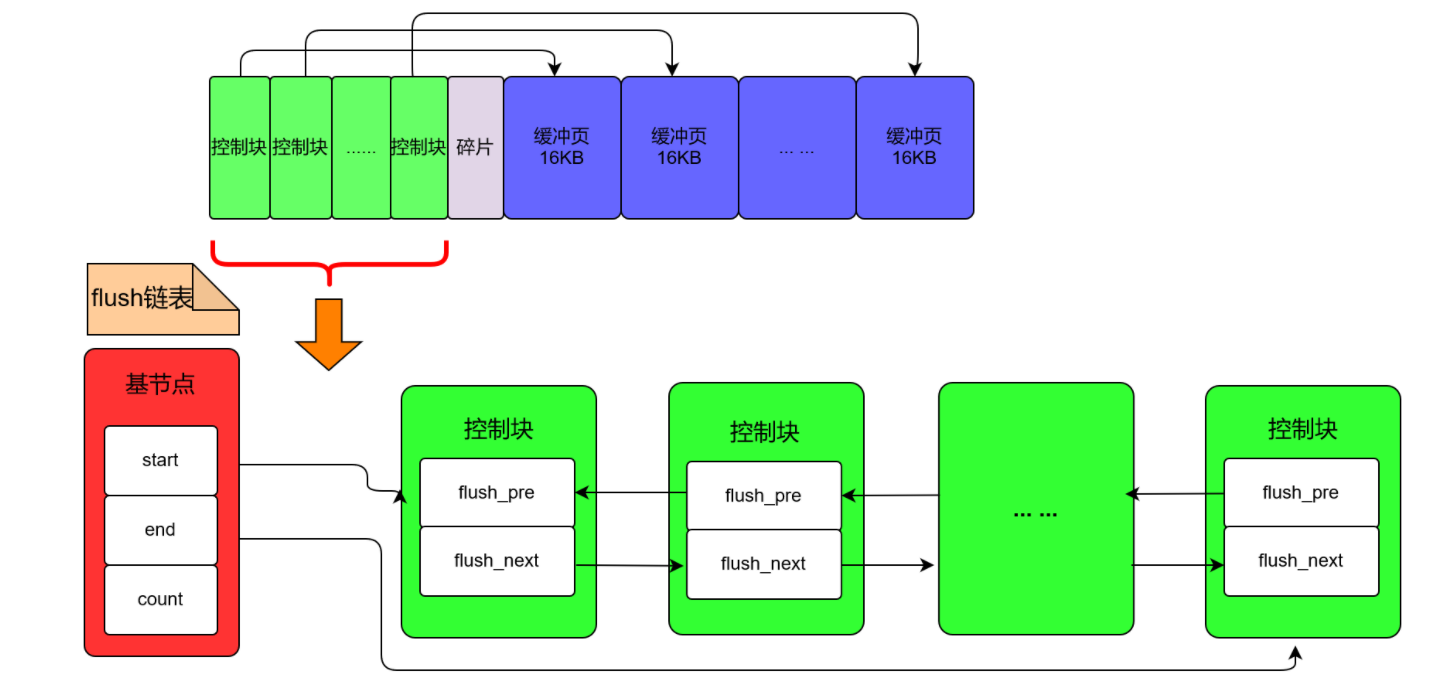
后台有专门的线程每隔一段时间把脏页刷新到磁盘:
- 从 Flush 链表中刷新一部分页面到磁盘:
- 后台线程定时从 Flush 链表刷脏,根据系统的繁忙程度来决定刷新速率,这种方式称为 BUF_FLUSH_LIST
- 线程刷脏的比较慢,导致用户线程加载一个新的数据页时发现没有空闲缓冲页,此时会尝试从 LRU 链表尾部寻找缓冲页直接释放,如果该页面是已经修改过的脏页就同步刷新到磁盘,速度较慢,这种方式称为 BUF_FLUSH_SINGLE_PAGE
- 从 LRU 链表的冷数据中刷新一部分页面到磁盘,即:BUF_FLUSH_LRU
- 后台线程会定时从 LRU 链表的尾部开始扫描一些页面,扫描的页面数量可以通过系统变量
innodb_lru_scan_depth指定,如果在 LRU 链表中发现脏页,则把它们刷新到磁盘,这种方式称为 BUF_FLUSH_LRU - 控制块里会存储该缓冲页是否被修改的信息,所以可以很容易的获取到某个缓冲页是否是脏页
- 后台线程会定时从 LRU 链表的尾部开始扫描一些页面,扫描的页面数量可以通过系统变量
参考文章:https://blog.csdn.net/li1325169021/article/details/121125765
LRU 链表
Buffer Pool 需要保证缓存的命中率,所以 MySQL 创建了一个 LRU 链表,当访问某个页时:
- 如果该页不在 Buffer Pool 中,把该页从磁盘加载进来后会将该缓冲页对应的控制块作为节点放入 LRU 链表的头部,保证热点数据在链表头
- 如果该页在 Buffer Pool 中,则直接把该页对应的控制块移动到 LRU 链表的头部,所以 LRU 链表尾部就是最近最少使用的缓冲页
MySQL 基于局部性原理提供了预读功能:
- 线性预读:系统变量
innodb_read_ahead_threshold,如果顺序访问某个区(extent:16 KB 的页,连续 64 个形成一个区,一个区默认 1MB 大小)的页面数超过了该系统变量值,就会触发一次异步读取下一个区中全部的页面到 Buffer Pool 中 - 随机预读:如果某个区 13 个连续的页面都被加载到 Buffer Pool,无论这些页面是否是顺序读取,都会触发一次异步读取本区所有的其他页面到 Buffer Pool 中
预读会造成加载太多用不到的数据页,造成那些使用频率很高的数据页被挤到 LRU 链表尾部,所以 InnoDB 将 LRU 链表分成两段,冷热数据隔离:
- 一部分存储使用频率很高的数据页,这部分链表也叫热数据,young 区,靠近链表头部的区域
- 一部分存储使用频率不高的冷数据,old 区,靠近链表尾部,默认占 37%,可以通过系统变量
innodb_old_blocks_pct指定
当磁盘上的某数据页被初次加载到 Buffer Pool 中会被放入 old 区,淘汰时优先淘汰 old 区
- 当对 old 区的数据进行访问时,会在控制块记录下访问时间,等待后续的访问时间与第一次访问的时间是否在某个时间间隔内,通过系统变量
innodb_old_blocks_time指定时间间隔,默认 1000ms,成立就移动到 young 区的链表头部 innodb_old_blocks_time为 0 时,每次访问一个页面都会放入 young 区的头部
参数优化
InnoDB 用一块内存区做 IO 缓存池,该缓存池不仅用来缓存 InnoDB 的索引块,也用来缓存 InnoDB 的数据块,可以通过下面的指令查看 Buffer Pool 的状态信息:
SHOW ENGINE INNODB STATUS\GBuffer pool hit rate 字段代表内存命中率,表示 Buffer Pool 对查询的加速效果
核心参数:
-
innodb_buffer_pool_size:该变量决定了 Innodb 存储引擎表数据和索引数据的最大缓存区大小,默认 128MSHOW VARIABLES LIKE 'innodb_buffer_pool_size';在保证操作系统及其他程序有足够内存可用的情况下,
innodb_buffer_pool_size的值越大,缓存命中率越高,建议设置成可用物理内存的 60%~80%innodb_buffer_pool_size=512M -
innodb_log_buffer_size:该值决定了 Innodb 日志缓冲区的大小,保存要写入磁盘上的日志文件数据对于可能产生大量更新记录的大事务,增加该值的大小,可以避免 Innodb 在事务提交前就执行不必要的日志写入磁盘操作,影响执行效率,通过配置文件修改:
innodb_log_buffer_size=10M
在多线程下,访问 Buffer Pool 中的各种链表都需要加锁,所以将 Buffer Pool 拆成若干个小实例,每个线程对应一个实例,独立管理内存空间和各种链表(类似 ThreadLocal),多线程访问各自实例互不影响,提高了并发能力
MySQL 5.7.5 之前 innodb_buffer_pool_size 只支持在系统启动时修改,现在已经支持运行时修改 Buffer Pool 的大小,但是每次调整参数都会重新向操作系统申请一块连续的内存空间,将旧的缓冲池的内容拷贝到新空间非常耗时,所以 MySQL 开始以一个 chunk 为单位向操作系统申请内存,所以一个 Buffer Pool 实例可以由多个 chunk 组成
- 在系统启动时设置系统变量
innodb_buffer_pool_instance可以指定 Buffer Pool 实例的个数,但是当 Buffer Pool 小于 1GB 时,设置多个实例时无效的 - 指定系统变量
innodb_buffer_pool_chunk_size来改变 chunk 的大小,只能在启动时修改,运行中不能修改,而且该变量并不包含缓冲页的控制块的内存大小 innodb_buffer_pool_size必须是innodb_buffer_pool_chunk_size × innodb_buffer_pool_instance的倍数,默认值是128M × 16 = 2G,Buffer Pool 必须是 2G 的整数倍,如果指定 5G,会自动调整成 6G- 如果启动时
chunk × instances>pool_size,那么 chunk 的值会自动设置为pool_size ÷ instances