SYSTEM
索引优化
src/content/notes/system/索引优化.md 索引优化
覆盖索引
覆盖索引:包含所有满足查询需要的数据的索引(SELECT 后面的字段刚好是索引字段),可以利用该索引返回 SELECT 列表的字段,而不必根据索引去聚簇索引上读取数据文件
回表查询:要查找的字段不在非主键索引树上时,需要通过叶子节点的主键值去主键索引上获取对应的行数据
使用覆盖索引,防止回表查询:
-
表 user 主键为 id,普通索引为 age,查询语句:
SELECT * FROM user WHERE age = 30;查询过程:先通过普通索引 age=30 定位到主键值 id=1,再通过聚集索引 id=1 定位到行记录数据,需要两次扫描 B+ 树
-
使用覆盖索引:
DROP INDEX idx_age ON user; CREATE INDEX idx_age_name ON user(age,name); SELECT id,age FROM user WHERE age = 30;在一棵索引树上就能获取查询所需的数据,无需回表速度更快
使用覆盖索引,要注意 SELECT 列表中只取出需要的列,不可用 SELECT *,所有字段一起做索引会导致索引文件过大,查询性能下降
索引下推
索引条件下推优化(Index Condition Pushdown,ICP)是 MySQL5.6 添加,可以在索引遍历过程中,对索引中包含的字段先做判断,直接过滤掉不满足条件的记录,减少回表次数
索引下推充分利用了索引中的数据,在查询出整行数据之前过滤掉无效的数据,再去主键索引树上查找
-
不使用索引下推优化时存储引擎通过索引检索到数据,然后回表查询记录返回给 Server 层,服务器判断数据是否符合条件

-
使用索引下推优化时,如果存在某些被索引的列的判断条件时,由存储引擎在索引遍历的过程中判断数据是否符合传递的条件,将符合条件的数据进行回表,检索出来返回给服务器,由此减少 IO 次数

适用条件:
- 需要存储引擎将索引中的数据与条件进行判断(所以条件列必须都在同一个索引中),所以优化是基于存储引擎的,只有特定引擎可以使用,适用于 InnoDB 和 MyISAM
- 存储引擎没有调用跨存储引擎的能力,跨存储引擎的功能有存储过程、触发器、视图,所以调用这些功能的不可以进行索引下推优化
- 对于 InnoDB 引擎只适用于二级索引,InnoDB 的聚簇索引会将整行数据读到缓冲区,不再需要去回表查询了
工作过程:用户表 user,(name, age) 是联合索引
SELECT * FROM user WHERE name LIKE '张%' AND age = 10; -- 头部模糊匹配会造成索引失效-
优化前:在非主键索引树上找到满足第一个条件的行,然后通过叶子节点记录的主键值再回到主键索引树上查找到对应的行数据,再对比 AND 后的条件是否符合,符合返回数据,需要 4 次回表

-
优化后:检查索引中存储的列信息是否符合索引条件,然后交由存储引擎用剩余的判断条件判断此行数据是否符合要求,不满足条件的不去读取表中的数据,满足下推条件的就根据主键值进行回表查询,2 次回表
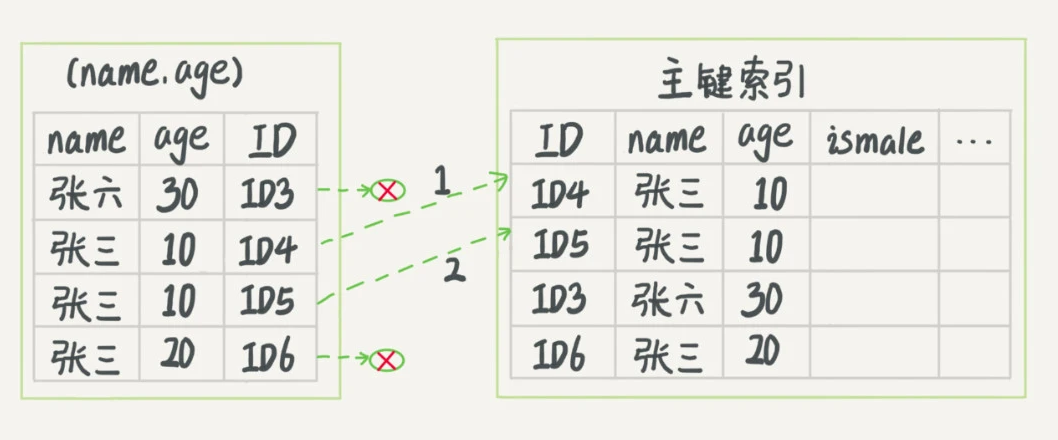
当使用 EXPLAIN 进行分析时,如果使用了索引条件下推,Extra 会显示 Using index condition
参考文章:https://blog.csdn.net/sinat_29774479/article/details/103470244
参考文章:https://time.geekbang.org/column/article/69636
前缀索引
当要索引的列字符很多时,索引会变大变慢,可以只索引列开始的部分字符串,节约索引空间,提高索引效率
注意:使用前缀索引就系统就忽略覆盖索引对查询性能的优化了
优化原则:降低重复的索引值
比如地区表:
area gdp code
chinaShanghai 100 aaa
chinaDalian 200 bbb
usaNewYork 300 ccc
chinaFuxin 400 ddd
chinaBeijing 500 eee发现 area 字段很多都是以 china 开头的,那么如果以前 1-5 位字符做前缀索引就会出现大量索引值重复的情况,索引值重复性越低,查询效率也就越高,所以需要建立前 6 位字符的索引:
CREATE INDEX idx_area ON table_name(area(7));场景:存储身份证
- 直接创建完整索引,这样可能比较占用空间
- 创建前缀索引,节省空间,但会增加查询扫描次数,并且不能使用覆盖索引
- 倒序存储,再创建前缀索引,用于绕过字符串本身前缀的区分度不够的问题(前 6 位相同的很多)
- 创建 hash 字段索引,查询性能稳定,有额外的存储和计算消耗,跟第三种方式一样,都不支持范围扫描
索引合并
使用多个索引来完成一次查询的执行方法叫做索引合并 index merge
-
Intersection 索引合并:
SELECT * FROM table_test WHERE key1 = 'a' AND key3 = 'b'; # key1 和 key3 列都是单列索引、二级索引从不同索引中扫描到的记录的 id 值取交集(相同 id),然后执行回表操作,要求从每个二级索引获取到的记录都是按照主键值排序
-
Union 索引合并:
SELECT * FROM table_test WHERE key1 = 'a' OR key3 = 'b';从不同索引中扫描到的记录的 id 值取并集,然后执行回表操作,要求从每个二级索引获取到的记录都是按照主键值排序
-
Sort-Union 索引合并
SELECT * FROM table_test WHERE key1 < 'a' OR key3 > 'b';先将从不同索引中扫描到的记录的主键值进行排序,再按照 Union 索引合并的方式进行查询
索引合并算法的效率并不好,通过将其中的一个索引改成联合索引会优化效率