SYSTEM
持久特性
src/content/notes/system/持久特性.md 持久特性
实现方式
持久性是指一个事务一旦被提交了,那么对数据库中数据的改变就是永久性的,接下来的其他操作或故障不应该对其有任何影响。
Buffer Pool 的使用提高了读写数据的效率,但是如果 MySQL 宕机,此时 Buffer Pool 中修改的数据还没有刷新到磁盘,就会导致数据的丢失,事务的持久性无法保证,所以引入了 redo log 日志:
- redo log 记录数据页的物理修改,而不是某一行或某几行的修改,用来恢复提交后的数据页,只能恢复到最后一次提交的位置
- redo log 采用的是 WAL(Write-ahead logging,预写式日志),所有修改要先写入日志,再更新到磁盘,保证了数据不会因 MySQL 宕机而丢失,从而满足了持久性要求
- 简单的 redo log 是纯粹的物理日志,复杂的 redo log 会存在物理日志和逻辑日志
工作过程:MySQL 发生了宕机,InnoDB 会判断一个数据页在崩溃恢复时丢失了更新,就会将它读到内存,然后根据 redo log 内容更新内存,更新完成后,内存页变成脏页,然后进行刷脏
缓冲池的刷脏策略:
- redo log 文件是固定大小的,如果写满了就要擦除以前的记录,在擦除之前需要把对应的更新持久化到磁盘中
- Buffer Pool 内存不足,需要淘汰部分数据页(LRU 链表尾部),如果淘汰的是脏页,就要先将脏页写到磁盘(要避免大事务)
- 系统空闲时,后台线程会自动进行刷脏(Flush 链表部分已经详解)
- MySQL 正常关闭时,会把内存的脏页都刷新到磁盘上
重做日志
日志缓冲
服务器启动时会向操作系统申请一片连续内存空间作为 redo log buffer(重做日志缓冲区),可以通过 innodb_log_buffer_size 系统变量指定 redo log buffer 的大小,默认是 16MB
log buffer 被划分为若干 redo log block(块,类似数据页的概念),每个默认大小 512 字节,每个 block 由 12 字节的 log block head、496 字节的 log block body、4 字节的 log block trailer 组成
- 当数据修改时,先修改 Change Buffer 中的数据,然后在 redo log buffer 记录这次操作,写入 log buffer 的过程是顺序写入的(先写入前面的 block,写满后继续写下一个)
- log buffer 中有一个指针 buf_free,来标识该位置之前都是填满的 block,该位置之后都是空闲区域
MySQL 规定对底层页面的一次原子访问称为一个 Mini-Transaction(MTR),比如在 B+ 树上插入一条数据就算一个 MTR
-
一个事务包含若干个 MTR,一个 MTR 对应一组若干条 redo log,一组 redo log 是不可分割的,在进行数据恢复时也把一组 redo log 当作一个不可分割的整体处理
-
不是每生成一条 redo 日志就将其插入到 log buffer 中,而是一个 MTR 结束后将一组 redo 日志写入
InnoDB 的 redo log 是固定大小的,redo 日志在磁盘中以文件组的形式存储,同一组中的每个文件大小一样格式一样
innodb_log_group_home_dir代表磁盘存储 redo log 的文件目录,默认是当前数据目录innodb_log_file_size代表文件大小,默认 48M,innodb_log_files_in_group代表文件个数,默认 2 最大 100,所以日志的文件大小为innodb_log_file_size * innodb_log_files_in_group
redo 日志文件也是由若干个 512 字节的 block 组成,日志文件的前 2048 个字节(前 4 个 block)用来存储一些管理信息,以后的用来存储 log buffer 中的 block 镜像
注意:block 并不代表一组 redo log,一组日志可能占用不到一个 block 或者几个 block,依赖于 MTR 的大小
日志刷盘
redo log 需要在事务提交时将日志写入磁盘,但是比 Buffer Pool 修改的数据写入磁盘的速度快,原因:
- 刷脏是随机 IO,因为每次修改的数据位置随机;redo log 和 binlog 都是顺序写,磁盘的顺序 IO 比随机 IO 速度要快
- 刷脏是以数据页(Page)为单位的,一个页上的一个小修改都要整页写入;redo log 中只包含真正需要写入的部分,好几页的数据修改可能只记录在一个 redo log 页中,减少无效 IO
- 组提交机制,可以大幅度降低磁盘的 IO 消耗
InnoDB 引擎会在适当的时候,把内存中 redo log buffer 持久化(fsync)到磁盘,具体的刷盘策略:
- 在事务提交时需要进行刷盘,通过修改参数
innodb_flush_log_at_trx_commit设置:- 0:表示当提交事务时,并不将缓冲区的 redo 日志写入磁盘,而是等待后台线程每秒刷新一次
- 1:在事务提交时将缓冲区的 redo 日志同步写入到磁盘,保证一定会写入成功(默认值)
- 2:在事务提交时将缓冲区的 redo 日志异步写入到磁盘,不能保证提交时肯定会写入,只是有这个动作。日志已经在操作系统的缓存,如果操作系统没有宕机而 MySQL 宕机,也是可以恢复数据的
- 写入 redo log buffer 的日志超过了总容量的一半,就会将日志刷入到磁盘文件,这会影响执行效率,所以开发中应避免大事务
- 服务器关闭时
- 并行的事务提交(组提交)时,会将将其他事务的 redo log 持久化到磁盘。假设事务 A 已经写入 redo log buffer 中,这时另外一个线程的事务 B 提交,如果 innodb_flush_log_at_trx_commit 设置的是 1,那么事务 B 要把 redo log buffer 里的日志全部持久化到磁盘,因为多个事务共用一个 redo log buffer,所以一次 fsync 可以刷盘多个事务的 redo log,提升了并发量
服务器启动后 redo 磁盘空间不变,所以 redo 磁盘中的日志文件是被循环使用的,采用循环写数据的方式,写完尾部重新写头部,所以要确保头部 log 对应的修改已经持久化到磁盘
日志序号
lsn (log sequence number) 代表已经写入的 redo 日志量、flushed_to_disk_lsn 指刷新到磁盘中的 redo 日志量,两者都是全局变量,如果两者的值相同,说明 log buffer 中所有的 redo 日志都已经持久化到磁盘
工作过程:写入 log buffer 数据时,buf_free 会进行偏移,偏移量就会加到 lsn 上
MTR 的执行过程中修改过的页对应的控制块会加到 Buffer Pool 的 flush 链表中,链表中脏页是按照第一次修改的时间进行排序的(头插),控制块中有两个指针用来记录脏页被修改的时间:
- oldest_modification:第一次修改 Buffer Pool 中某个缓冲页时,将修改该页的 MTR 开始时对应的 lsn 值写入这个属性
- newest_modification:每次修改页面,都将 MTR 结束时全局的 lsn 值写入这个属性,所以该值是该页面最后一次修改后的 lsn 值
全局变量 checkpoint_lsn 表示当前系统可以被覆盖的 redo 日志总量,当 redo 日志对应的脏页已经被刷新到磁盘后,该文件空间就可以被覆盖重用,此时执行一次 checkpoint 来更新 checkpoint_lsn 的值存入管理信息(刷脏和执行一次 checkpoint 并不是同一个线程),该值的增量就代表磁盘文件中当前位置向后可以被覆盖的文件的量,所以该值是一直增大的
checkpoint:从 flush 链表尾部中找出还未刷脏的页面,该页面是当前系统中最早被修改的脏页,该页面之前产生的脏页都已经刷脏,然后将该页 oldest_modification 值赋值给 checkpoint_lsn,因为 lsn 小于该值时产生的 redo 日志都可以被覆盖了
但是在系统忙碌时,后台线程的刷脏操作不能将脏页快速刷出,导致系统无法及时执行 checkpoint ,这时需要用户线程从 flush 链表中把最早修改的脏页刷新到磁盘中,然后执行 checkpoint
write pos ------- checkpoint_lsn // 两值之间的部分表示可以写入的日志量,当 pos 追赶上 lsn 时必须执行 checkpoint使用命令可以查看当前 InnoDB 存储引擎各种 lsn 的值:
SHOW ENGINE INNODB STATUS\G崩溃恢复
恢复的起点:在从 redo 日志文件组的管理信息中获取最近发生 checkpoint 的信息,从 checkpoint_lsn 对应的日志文件开始恢复
恢复的终点:扫描日志文件的 block,block 的头部记录着当前 block 使用了多少字节,填满的 block 总是 512 字节, 如果某个 block 不是 512 字节,说明该 block 就是需要恢复的最后一个 block
恢复的过程:按照 redo log 依次执行恢复数据,优化方式
- 使用哈希表:根据 redo log 的 space id 和 page number 属性计算出哈希值,将对同一页面的修改放入同一个槽里,可以一次性完成对某页的恢复,避免了随机 IO
- 跳过已经刷新到磁盘中的页面:数据页的 File Header 中的 FILE_PAGE_LSN 属性(类似 newest_modification)表示最近一次修改页面时的 lsn 值,数据页被刷新到磁盘中,那么该页 lsn 属性肯定大于 checkpoint_lsn
参考书籍:https://book.douban.com/subject/35231266/
工作流程
日志对比
MySQL 中还存在 binlog(二进制日志)也可以记录写操作并用于数据的恢复,保证数据不丢失,二者的区别是:
- 作用不同:redo log 是用于 crash recovery (故障恢复),保证 MySQL 宕机也不会影响持久性;binlog 是用于 point-in-time recovery 的,保证服务器可以基于时间点恢复数据,此外 binlog 还用于主从复制
- 层次不同:redo log 是 InnoDB 存储引擎实现的,而 binlog 是MySQL的 Server 层实现的,同时支持 InnoDB 和其他存储引擎
- 内容不同:redo log 是物理日志,内容基于磁盘的 Page;binlog 的内容是二进制的,根据 binlog_format 参数的不同,可能基于SQL 语句、基于数据本身或者二者的混合(日志部分详解)
- 写入时机不同:binlog 在事务提交时一次写入;redo log 的写入时机相对多元
binlog 为什么不支持崩溃恢复?
- binlog 记录的是语句,并不记录数据页级的数据(哪个页改了哪些地方),所以没有能力恢复数据页
- binlog 是追加写,保存全量的日志,没有标志确定从哪个点开始的数据是已经刷盘了,而 redo log 只要在 checkpoint_lsn 后面的就是没有刷盘的
更新记录
更新一条记录的过程:写之前一定先读
-
在 B+ 树中定位到该记录,如果该记录所在的页面不在 Buffer Pool 里,先将其加载进内存
-
首先更新该记录对应的聚簇索引,更新聚簇索引记录时:
-
更新记录前向 undo 页面写 undo 日志,由于这是更改页面,所以需要记录一下相应的 redo 日志
注意:修改 undo 页面也是在修改页面,事务只要修改页面就需要先记录相应的 redo 日志
-
然后记录对应的 redo 日志(等待 MTR 提交后写入 redo log buffer),最后进行真正的更新记录
-
-
更新其他的二级索引记录,不会再记录 undo log,只记录 redo log 到 buffer 中
-
在一条更新语句执行完成后(也就是将所有待更新记录都更新完了),就会开始记录该语句对应的 binlog 日志,此时记录的 binlog 并没有刷新到硬盘上,还在内存中,在事务提交时才会统一将该事务运行过程中的所有 binlog 日志刷新到硬盘
假设表中有字段 id 和 a,存在一条 id = 1, a = 2 的记录,此时执行更新语句:
update table set a=2 where id=1;InnoDB 会真正的去执行把值修改成 (1,2) 这个操作,先加行锁,在去更新,并不会提前判断相同就不修改了
参考文章:https://mp.weixin.qq.com/s/wcJ2KisSaMnfP4nH5NYaQA
两段提交
当客户端执行 COMMIT 语句或者在自动提交的情况下,MySQL 内部开启一个 XA 事务,分两阶段来完成 XA 事务的提交:
update T set c=c+1 where ID=2;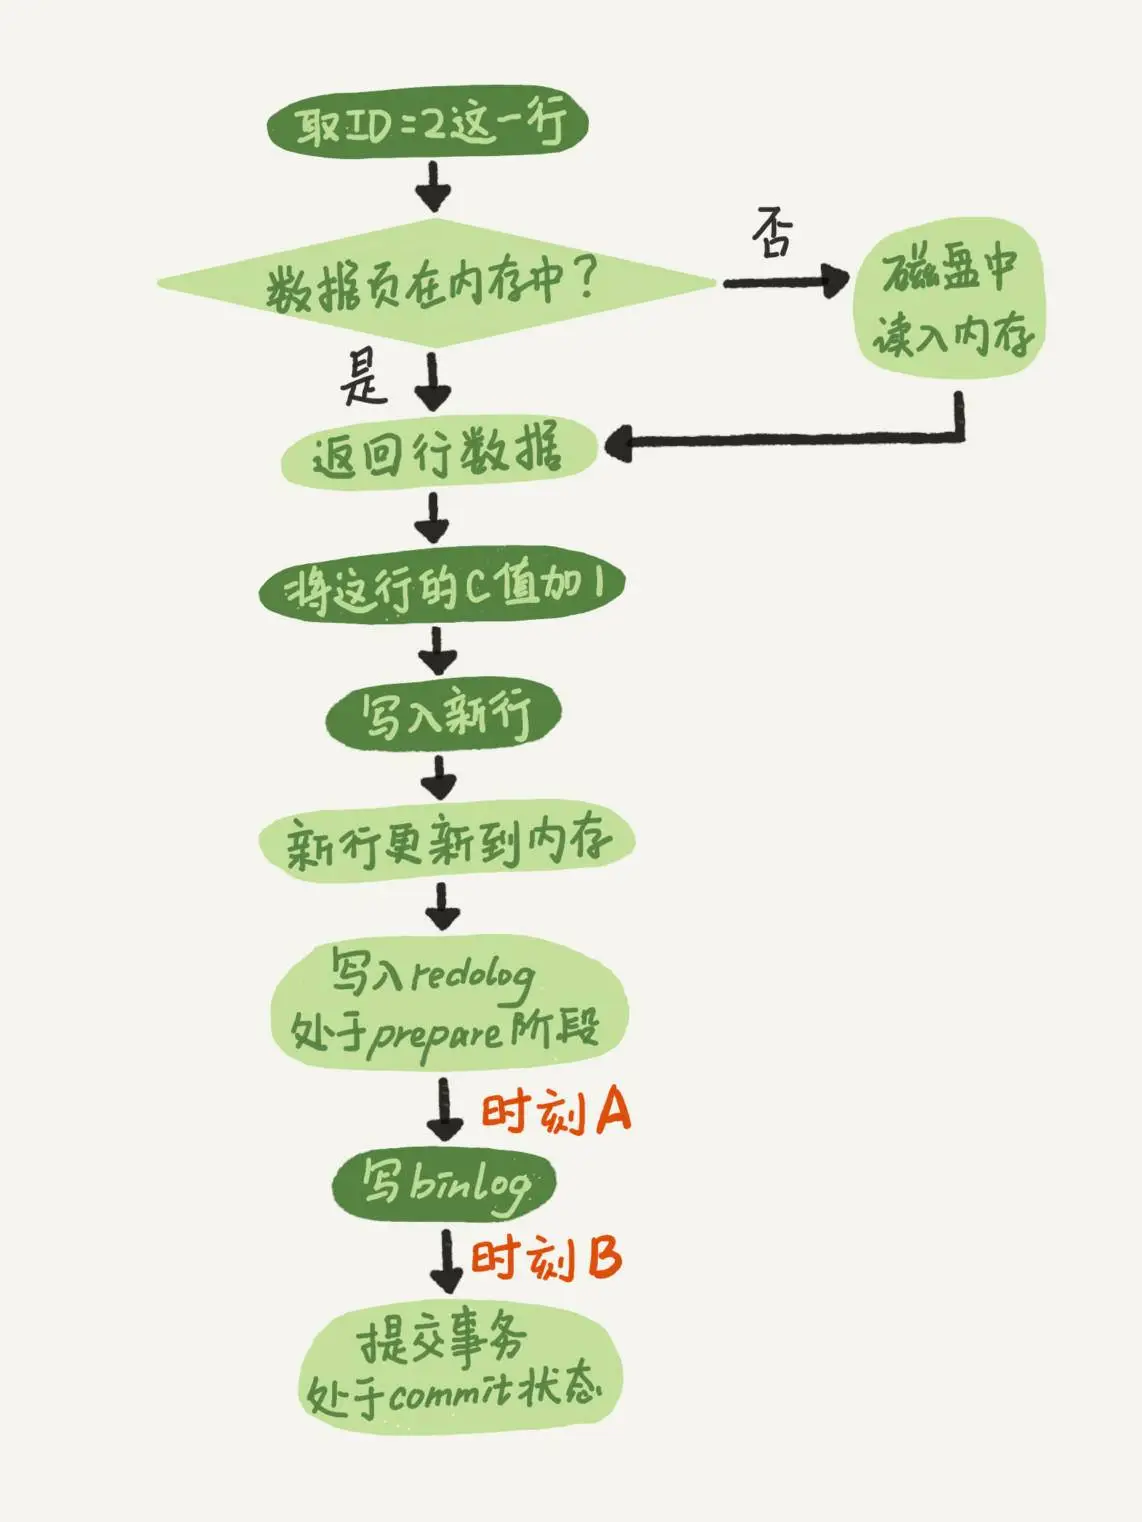
流程说明:执行引擎将这行新数据读入到内存中(Buffer Pool)后,先将此次更新操作记录到 redo log buffer 里,然后更新记录。最后将 redo log 刷盘后事务处于 prepare 状态,执行器会生成这个操作的 binlog,并把 binlog 写入磁盘,完成提交
两阶段:
- Prepare 阶段:存储引擎将该事务的 redo 日志刷盘,并且将本事务的状态设置为 PREPARE,代表执行完成随时可以提交事务
- Commit 阶段:先将事务执行过程中产生的 binlog 刷新到硬盘,再执行存储引擎的提交工作,引擎把 redo log 改成提交状态
存储引擎层的 redo log 和 server 层的 binlog 可以认为是一个分布式事务, 都可以用于表示事务的提交状态,而两阶段提交就是让这两个状态保持逻辑上的一致,也有利于主从复制,更好的保持主从数据的一致性
数据恢复
系统崩溃前没有提交的事务的 redo log 可能已经刷盘(定时线程或者 checkpoint),怎么处理崩溃恢复?
工作流程:获取 undo 链表首节点页面的 undo segement header 中的 TRX_UNDO_STATE 属性,表示当前链表的事务属性,事务状态是活跃(未提交)的就全部回滚,如果是 PREPARE 状态,就需要根据 binlog 的状态进行判断:
- 如果在时刻 A 发生了崩溃(crash),由于此时 binlog 还没完成,所以需要进行回滚
- 如果在时刻 B 发生了崩溃,redo log 和 binlog 有一个共同的数据字段叫 XID,崩溃恢复的时候,会按顺序扫描 redo log:
- 如果 redo log 里面的事务是完整的,也就是已经有了 commit 标识,说明 binlog 也已经记录完整,直接从 redo log 恢复数据
- 如果 redo log 里面的事务只有 prepare,就根据 XID 去 binlog 中判断对应的事务是否存在并完整,如果完整可以恢复数据
判断一个事务的 binlog 是否完整的方法:
- statement 格式的 binlog,最后会有 COMMIT
- row 格式的 binlog,最后会有一个 XID event
- MySQL 5.6.2 版本以后,引入了 binlog-checksum 参数用来验证 binlog 内容的正确性(可能日志中间出错)
参考文章:https://time.geekbang.org/column/article/73161
刷脏优化
系统在进行刷脏时会占用一部分系统资源,会影响系统的性能,产生系统抖动
- 一个查询要淘汰的脏页个数太多,会导致查询的响应时间明显变长
- 日志写满,更新全部堵住,写性能跌为 0,这种情况对敏感业务来说,是不能接受的
InnoDB 刷脏页的控制策略:
innodb_io_capacity参数代表磁盘的读写能力,建议设置成磁盘的 IOPS(每秒的 IO 次数)- 刷脏速度参考两个因素:脏页比例和 redo log 写盘速度
- 参数
innodb_max_dirty_pages_pct是脏页比例上限,默认值是 75%,InnoDB 会根据当前的脏页比例,算出一个范围在 0 到 100 之间的数字 - InnoDB 每次写入的日志都有一个序号,当前写入的序号跟 checkpoint 对应的序号之间的差值,InnoDB 根据差值算出一个范围在 0 到 100 之间的数字
- 两者较大的值记为 R,执行引擎按照 innodb_io_capacity 定义的能力乘以 R% 来控制刷脏页的速度
- 参数
innodb_flush_neighbors参数置为 1 代表控制刷脏时检查相邻的数据页,如果也是脏页就一起刷脏,并检查邻居的邻居,这个行为会一直蔓延直到不是脏页,在 MySQL 8.0 中该值的默认值是 0,不建议开启此功能
一致特性
一致性是指事务执行前后,数据库的完整性约束没有被破坏,事务执行的前后都是合法的数据状态。
数据库的完整性约束包括但不限于:实体完整性(如行的主键存在且唯一)、列完整性(如字段的类型、大小、长度要符合要求)、外键约束、用户自定义完整性(如转账前后,两个账户余额的和应该不变)
实现一致性的措施:
- 保证原子性、持久性和隔离性,如果这些特性无法保证,事务的一致性也无法保证
- 数据库本身提供保障,例如不允许向整形列插入字符串值、字符串长度不能超过列的限制等
- 应用层面进行保障,例如如果转账操作只扣除转账者的余额,而没有增加接收者的余额,无论数据库实现的多么完美,也无法保证状态的一致
锁机制
基本介绍
锁机制:数据库为了保证数据的一致性,在共享的资源被并发访问时变得安全有序所设计的一种规则
利用 MVCC 性质进行读取的操作叫一致性读,读取数据前加锁的操作叫锁定读
锁的分类:
- 按操作分类:
- 共享锁:也叫读锁。对同一份数据,多个事务读操作可以同时加锁而不互相影响 ,但不能修改数据
- 排他锁:也叫写锁。当前的操作没有完成前,会阻断其他操作的读取和写入
- 按粒度分类:
- 表级锁:会锁定整个表,开销小,加锁快;不会出现死锁;锁定力度大,发生锁冲突概率高,并发度最低,偏向 MyISAM
- 行级锁:会锁定当前操作行,开销大,加锁慢;会出现死锁;锁定力度小,发生锁冲突概率低,并发度高,偏向 InnoDB
- 页级锁:锁的力度、发生冲突的概率和加锁开销介于表锁和行锁之间,会出现死锁,并发性能一般
- 按使用方式分类:
- 悲观锁:每次查询数据时都认为别人会修改,很悲观,所以查询时加锁
- 乐观锁:每次查询数据时都认为别人不会修改,很乐观,但是更新时会判断一下在此期间别人有没有去更新这个数据
-
不同存储引擎支持的锁
存储引擎 表级锁 行级锁 页级锁 MyISAM 支持 不支持 不支持 InnoDB 支持 支持 不支持 MEMORY 支持 不支持 不支持 BDB 支持 不支持 支持
从锁的角度来说:表级锁更适合于以查询为主,只有少量按索引条件更新数据的应用,如 Web 应用;而行级锁则更适合于有大量按索引条件并发更新少量不同数据,同时又有并查询的应用,如一些在线事务处理系统
内存结构
对一条记录加锁的本质就是在内存中创建一个锁结构与之关联,结构包括
- 事务信息:锁对应的事务信息,一个锁属于一个事务
- 索引信息:对于行级锁,需要记录加锁的记录属于哪个索引
- 表锁和行锁信息:表锁记录着锁定的表,行锁记录了 Space ID 所在表空间、Page Number 所在的页号、n_bits 使用了多少比特
- type_mode:一个 32 比特的数,被分成 lock_mode、lock_type、rec_lock_type 三个部分
- lock_mode:锁模式,记录是共享锁、排他锁、意向锁之类
- lock_type:代表表级锁还是行级锁
- rec_lock_type:代表行锁的具体类型和 is_waiting 属性,is_waiting = true 时表示当前事务尚未获取到锁,处于等待状态。事务获取锁后的锁结构是 is_waiting 为 false,释放锁时会检查是否与当前记录关联的锁结构,如果有就唤醒对应事务的线程
一个事务可能操作多条记录,为了节省内存,满足下面条件的锁使用同一个锁结构:
- 在同一个事务中的加锁操作
- 被加锁的记录在同一个页面中
- 加锁的类型是一样的
- 加锁的状态是一样的
Server
MySQL 里面表级别的锁有两种:一种是表锁,一种是元数据锁(meta data lock,MDL)
MDL 叫元数据锁,主要用来保护 MySQL 内部对象的元数据,保证数据读写的正确性,当对一个表做增删改查的时候,加 MDL 读锁;当要对表做结构变更操作 DDL 的时候,加 MDL 写锁,两种锁不相互兼容,所以可以保证 DDL、DML、DQL 操作的安全
说明:DDL 操作执行前会隐式提交当前会话的事务,因为 DDL 一般会在若干个特殊事务中完成,开启特殊事务前需要提交到其他事务
MDL 锁的特性:
-
MDL 锁不需要显式使用,在访问一个表的时候会被自动加上,在事务开始时申请,整个事务提交后释放(执行完单条语句不释放)
-
MDL 锁是在 Server 中实现,不是 InnoDB 存储引擎层能直接实现的锁
-
MDL 锁还能实现其他粒度级别的锁,比如全局锁、库级别的锁、表空间级别的锁
FLUSH TABLES WITH READ LOCK 简称(FTWRL),全局读锁,让整个库处于只读状态,DDL DML 都被阻塞,工作流程:
- 上全局读锁(lock_global_read_lock)
- 清理表缓存(close_cached_tables)
- 上全局 COMMIT 锁(make_global_read_lock_block_commit)
该命令主要用于备份工具做一致性备份,由于 FTWRL 需要持有两把全局的 MDL 锁,并且还要关闭所有表对象,因此杀伤性很大