SYSTEM
执行流程
src/content/notes/system/执行流程.md 执行流程
查询缓存
工作流程
当执行完全相同的 SQL 语句的时候,服务器就会直接从缓存中读取结果,当数据被修改,之前的缓存会失效,修改比较频繁的表不适合做查询缓存
查询过程:
- 客户端发送一条查询给服务器
- 服务器先会检查查询缓存,如果命中了缓存,则立即返回存储在缓存中的结果(一般是 K-V 键值对),否则进入下一阶段
- 分析器进行 SQL 分析,再由优化器生成对应的执行计划
- 执行器根据优化器生成的执行计划,调用存储引擎的 API 来执行查询
- 将结果返回给客户端
大多数情况下不建议使用查询缓存,因为查询缓存往往弊大于利
- 查询缓存的失效非常频繁,只要有对一个表的更新,这个表上所有的查询缓存都会被清空。因此很可能费力地把结果存起来,还没使用就被一个更新全清空了,对于更新压力大的数据库来说,查询缓存的命中率会非常低
- 除非业务就是有一张静态表,很长时间才会更新一次,比如一个系统配置表,那这张表上的查询才适合使用查询缓存
缓存配置
-
查看当前 MySQL 数据库是否支持查询缓存:
SHOW VARIABLES LIKE 'have_query_cache'; -- YES -
查看当前 MySQL 是否开启了查询缓存:
SHOW VARIABLES LIKE 'query_cache_type'; -- OFF参数说明:
-
OFF 或 0:查询缓存功能关闭
-
ON 或 1:查询缓存功能打开,查询结果符合缓存条件即会缓存,否则不予缓存;可以显式指定 SQL_NO_CACHE 不予缓存
-
DEMAND 或 2:查询缓存功能按需进行,显式指定 SQL_CACHE 的 SELECT 语句才缓存,其它不予缓存
SELECT SQL_CACHE id, name FROM customer; -- SQL_CACHE:查询结果可缓存 SELECT SQL_NO_CACHE id, name FROM customer;-- SQL_NO_CACHE:不使用查询缓存
-
-
查看查询缓存的占用大小:
SHOW VARIABLES LIKE 'query_cache_size';-- 单位是字节 1048576 / 1024 = 1024 = 1KB -
查看查询缓存的状态变量:
SHOW STATUS LIKE 'Qcache%';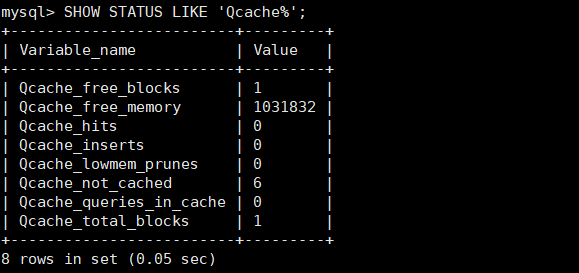
参数 含义 Qcache_free_blocks 查询缓存中的可用内存块数 Qcache_free_memory 查询缓存的可用内存量 Qcache_hits 查询缓存命中数 Qcache_inserts 添加到查询缓存的查询数 Qcache_lowmen_prunes 由于内存不足而从查询缓存中删除的查询数 Qcache_not_cached 非缓存查询的数量(由于 query_cache_type 设置而无法缓存或未缓存) Qcache_queries_in_cache 查询缓存中注册的查询数 Qcache_total_blocks 查询缓存中的块总数 -
配置 my.cnf:
sudo chmod 666 /etc/mysql/my.cnf vim my.cnf # mysqld中配置缓存 query_cache_type=1重启服务既可生效,执行 SQL 语句进行验证 ,执行一条比较耗时的 SQL 语句,然后再多执行几次,查看后面几次的执行时间;获取通过查看查询缓存的缓存命中数,来判定是否走查询缓存
缓存失效
查询缓存失效的情况:
-
SQL 语句不一致,要想命中查询缓存,查询的 SQL 语句必须一致,因为缓存中 key 是查询的语句,value 是查询结构
select count(*) from tb_item; Select count(*) from tb_item; -- 不走缓存,首字母不一致 -
当查询语句中有一些不确定查询时,则不会缓存,比如:now()、current_date()、curdate()、curtime()、rand()、uuid()、user()、database()
SELECT * FROM tb_item WHERE updatetime < NOW() LIMIT 1; SELECT USER(); SELECT DATABASE(); -
不使用任何表查询语句:
SELECT 'A'; -
查询 mysql、information_schema、performance_schema 等系统表时,不走查询缓存:
SELECT * FROM information_schema.engines; -
在跨存储引擎的存储过程、触发器或存储函数的主体内执行的查询,缓存失效
-
如果表更改,则使用该表的所有高速缓存查询都将变为无效并从高速缓存中删除,包括使用 MERGE 映射到已更改表的表的查询,比如:INSERT、UPDATE、DELETE、ALTER TABLE、DROP TABLE、DROP DATABASE
分析器
没有命中查询缓存,就开始了 SQL 的真正执行,分析器会对 SQL 语句做解析
SELECT * FROM t WHERE id = 1;解析器:处理语法和解析查询,生成一课对应的解析树
- 先做词法分析,输入的是由多个字符串和空格组成的一条 SQL 语句,MySQL 需要识别出里面的字符串分别是什么代表什么。从输入的 select 这个关键字识别出来这是一个查询语句;把字符串 t 识别成 表名 t,把字符串 id 识别成列 id
- 然后做语法分析,根据词法分析的结果,语法分析器会根据语法规则,判断你输入的这个 SQL 语句是否满足 MySQL 语法。如果语句不对,就会收到
You have an error in your SQL syntax的错误提醒
预处理器:进一步检查解析树的合法性,比如数据表和数据列是否存在、别名是否有歧义等
优化器
成本分析
优化器是在表里面有多个索引的时候,决定使用哪个索引;或者在一个语句有多表关联(join)的时候,决定各个表的连接顺序
- 根据搜索条件找出所有可能的使用的索引
- 成本分析,执行成本由 I/O 成本和 CPU 成本组成,计算全表扫描和使用不同索引执行 SQL 的代价
- 找到一个最优的执行方案,用最小的代价去执行语句
在数据库里面,扫描行数是影响执行代价的因素之一,扫描的行数越少意味着访问磁盘的次数越少,消耗的 CPU 资源越少,优化器还会结合是否使用临时表、是否排序等因素进行综合判断
统计数据
MySQL 中保存着两种统计数据:
- innodb_table_stats 存储了表的统计数据,每一条记录对应着一个表的统计数据
- innodb_index_stats 存储了索引的统计数据,每一条记录对应着一个索引的一个统计项的数据
MySQL 在真正执行语句之前,并不能精确地知道满足条件的记录有多少条,只能根据统计信息来估算记录,统计信息就是索引的区分度,一个索引上不同的值的个数(比如性别只能是男女,就是 2 ),称之为基数(cardinality),基数越大说明区分度越好
通过采样统计来获取基数,InnoDB 默认会选择 N 个数据页,统计这些页面上的不同值得到一个平均值,然后乘以这个索引的页面数,就得到了这个索引的基数
在 MySQL 中,有两种存储统计数据的方式,可以通过设置参数 innodb_stats_persistent 的值来选择:
- ON:表示统计信息会持久化存储(默认),采样页数 N 默认为 20,可以通过
innodb_stats_persistent_sample_pages指定,页数越多统计的数据越准确,但消耗的资源更大 - OFF:表示统计信息只存储在内存,采样页数 N 默认为 8,也可以通过系统变量设置(不推荐,每次重新计算浪费资源)
数据表是会持续更新的,两种统计信息的更新方式:
- 设置
innodb_stats_auto_recalc为 1,当发生变动的记录数量超过表大小的 10% 时,自动触发重新计算,不过是异步进行 - 调用
ANALYZE TABLE t手动更新统计信息,只对信息做重新统计(不是重建表),没有修改数据,这个过程中加了 MDL 读锁并且是同步进行,所以会暂时阻塞系统
EXPLAIN 执行计划在优化器阶段生成,如果 explain 的结果预估的 rows 值跟实际情况差距比较大,可以执行 analyze 命令重新修正信息
错选索引
采样统计本身是估算数据,或者 SQL 语句中的字段选择有问题时,可能导致 MySQL 没有选择正确的执行索引
解决方法:
-
采用 force index 强行选择一个索引
SELECT * FROM user FORCE INDEX(name) WHERE NAME='seazean'; -
可以考虑修改 SQL 语句,引导 MySQL 使用期望的索引
-
新建一个更合适的索引,来提供给优化器做选择,或删掉误用的索引
执行器
开始执行的时候,要先判断一下当前连接对表有没有执行查询的权限,如果没有就会返回没有权限的错误,在工程实现上,如果命中查询缓存,会在查询缓存返回结果的时候,做权限验证。如果有权限,就打开表继续执行,执行器就会根据表的引擎定义,去使用这个引擎提供的接口
引擎层
Server 层和存储引擎层的交互是以记录为单位的,存储引擎会将单条记录返回给 Server 层做进一步处理,并不是直接返回所有的记录
工作流程:
- 首先根据二级索引选择扫描范围,获取第一条符合二级索引条件的记录,进行回表查询,将聚簇索引的记录返回 Server 层,由 Server 判断记录是否符合要求
- 然后在二级索引上继续扫描下一个符合条件的记录
推荐阅读:https://mp.weixin.qq.com/s/YZ-LckObephrP1f15mzHpA