SYSTEM
底层协议
src/content/notes/system/底层协议.md 底层协议
Paxos
Paxos 算法:基于消息传递且具有高度容错特性的一致性算法
优点:快速正确的在一个分布式系统中对某个数据值达成一致,并且保证不论发生任何异常,都不会破坏整个系统的一致性
缺陷:在网络复杂的情况下,可能很久无法收敛,甚至陷入活锁的情况
ZAB
算法介绍
ZAB 协议借鉴了 Paxos 算法,是为 Zookeeper 设计的支持崩溃恢复的原子广播协议,基于该协议 Zookeeper 设计为只有一台客户端(Leader)负责处理外部的写事务请求,然后 Leader 将数据同步到其他 Follower 节点
Zab 协议包括两种基本的模式:消息广播、崩溃恢复
消息广播
ZAB 协议针对事务请求的处理过程类似于一个两阶段提交过程:广播事务阶段、广播提交操作
- 客户端发起写操作请求,Leader 服务器将请求转化为事务 Proposal 提案,同时为 Proposal 分配一个全局的 ID,即 ZXID
- Leader 服务器为每个 Follower 分配一个单独的队列,将广播的 Proposal 依次放到队列中去,根据 FIFO 策略进行消息发送
- Follower 接收到 Proposal 后,将其以事务日志的方式写入本地磁盘中,写入成功后向 Leader 反馈一个 ACK 响应消息
- Leader 接收到超过半数以上 Follower 的 ACK 响应消息后,即认为消息发送成功,可以发送 Commit 消息
- Leader 向所有 Follower 广播 commit 消息,同时自身也会完成事务提交,Follower 接收到 Commit 后,将上一条事务提交
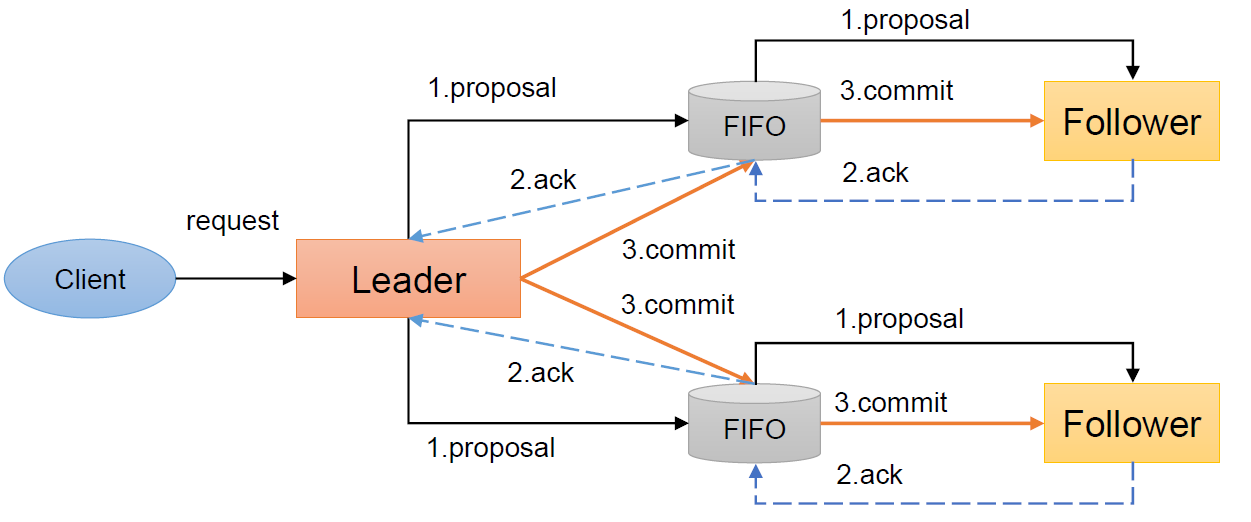
两阶段提交模型可能因为 Leader 宕机带来数据不一致:
- Leader 发起一个事务 Proposal 后就宕机,Follower 都没有 Proposal
- Leader 收到半数 ACK 宕机,没来得及向 Follower 发送 Commit
崩溃恢复
Leader 服务器出现崩溃或者由于网络原因导致 Leader 服务器失去了与过半 Follower的联系,那么就会进入崩溃恢复模式,崩溃恢复主要包括两部分:Leader 选举和数据恢复
Zab 协议崩溃恢复要求满足以下两个要求:
- 已经被 Leader 提交的提案 Proposal,必须最终被所有的 Follower 服务器正确提交
- 丢弃已经被 Leader 提出的,但是没有被提交的 Proposal
Zab 协议需要保证选举出来的 Leader 需要满足以下条件:
- 新选举的 Leader 不能包含未提交的 Proposal,即新 Leader 必须都是已经提交了 Proposal 的 Follower 节点
- 新选举的 Leader 节点含有最大的 ZXID,可以避免 Leader 服务器检查 Proposal 的提交和丢弃工作
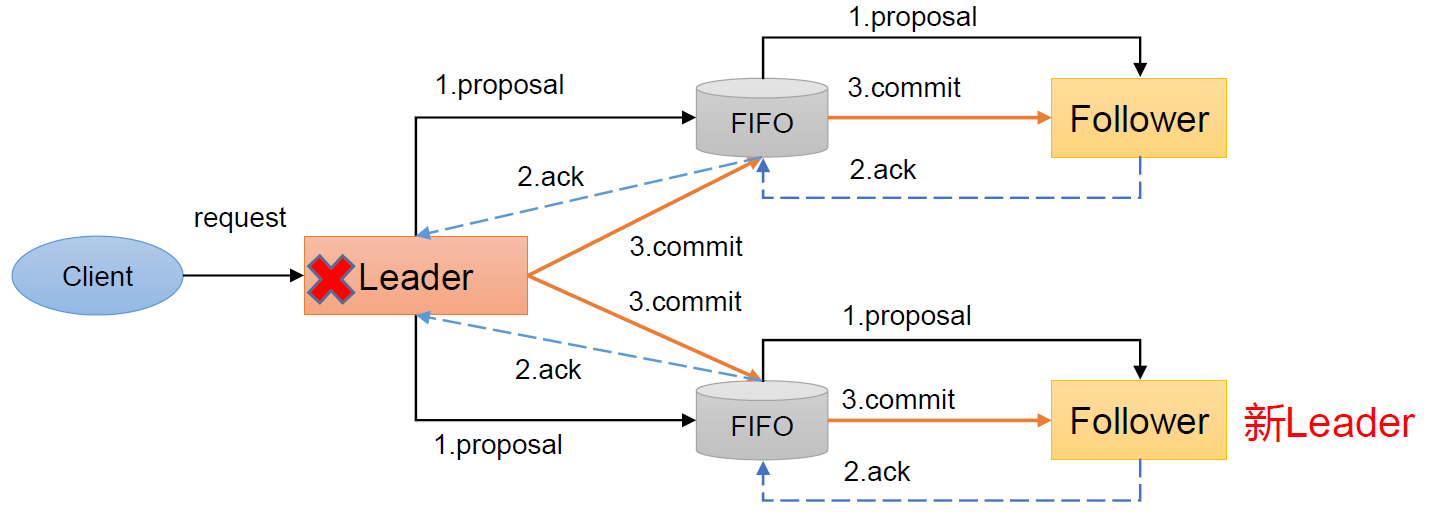
数据恢复阶段:
- 完成 Leader 选举后,在正式开始工作之前(接收事务请求提出新的 Proposal),Leader 服务器会首先确认事务日志中的所有 Proposal 是否已经被集群中过半的服务器 Commit
- Leader 服务器需要确保所有的 Follower 服务器能够接收到每一条事务的 Proposal,并且能将所有已经提交的事务 Proposal 应用到内存数据中,所以只有当 Follower 将所有尚未同步的事务 Proposal 都从 Leader 服务器上同步,并且应用到内存数据后,Leader 才会把该 Follower 加入到真正可用的 Follower 列表中
异常处理
Zab 的事务编号 zxid 设计:
- zxid 是一个 64 位的数字,低 32 位是一个简单的单增计数器,针对客户端每一个事务请求,Leader 在产生新的 Proposal 事务时,都会对该计数器加 1,而高 32 位则代表了 Leader 周期的 epoch 编号
- epoch 为当前集群所处的代或者周期,每次 Leader 变更后都会在 epoch 的基础上加 1,Follower 只服从 epoch 最高的 Leader 命令,所以旧的 Leader 崩溃恢复之后,其他 Follower 就不会继续追随
- 每次选举产生一个新的 Leader,就会从新 Leader 服务器上取出本地事务日志中最大编号 Proposal 的 zxid,从 zxid 中解析得到对应的 epoch 编号,然后再对其加 1 后作为新的 epoch 值,并将低 32 位数字归零,由 0 开始重新生成 zxid
Zab 协议通过 epoch 编号来区分 Leader 变化周期,能够有效避免不同的 Leader 错误的使用了相同的 zxid 编号提出了不一样的 Proposal 的异常情况
Zab 数据同步过程:数据同步阶段要以 Leader 服务器为准
- 一个包含了上个 Leader 周期中尚未提交过的事务 Proposal 的服务器启动时,这台机器加入集群中会以 Follower 角色连上 Leader
- Leader 会根据自己服务器上最后提交的 Proposal 和 Follower 服务器的 Proposal 进行比对,让 Follower 进行一个回退或者前进操作,到一个已经被集群中过半机器 Commit 的最新 Proposal(源码解析部分详解)
CAP
CAP 理论指的是在一个分布式系统中,Consistency(一致性)、Availability(可用性)、Partition Tolerance(分区容错性)不能同时成立,ZooKeeper 保证的是 CP
- ZooKeeper 不能保证每次服务请求的可用性,在极端环境下可能会丢弃一些请求,消费者程序需要重新请求才能获得结果
- 进行 Leader 选举时集群都是不可用
CAP 三个基本需求,因为 P 是必须的,因此分布式系统选择就在 CP 或者 AP 中:
- 一致性:指数据在多个副本之间是否能够保持数据一致的特性,当一个系统在数据一致的状态下执行更新操作后,也能保证系统的数据仍然处于一致的状态
- 可用性:指系统提供的服务必须一直处于可用的状态,即使集群中一部分节点故障,对于用户的每一个操作请求总是能够在有限的时间内返回结果
- 分区容错性:分布式系统在遇到任何网络分区故障时,仍然能够保证对外提供服务,不会宕机,除非是整个网络环境都发生了故障