SYSTEM
并查集
src/content/notes/system/并查集.md 并查集
基本实现
并查集是一种树型的数据结构,有以下特点:
- 每个元素都唯一的对应一个结点
- 每一组数据中的多个元素都在同一颗树中
- 一个组中的数据对应的树和另外一个组中的数据对应的树之间没有任何联系
- 元素在树中并没有子父级关系的硬性要求
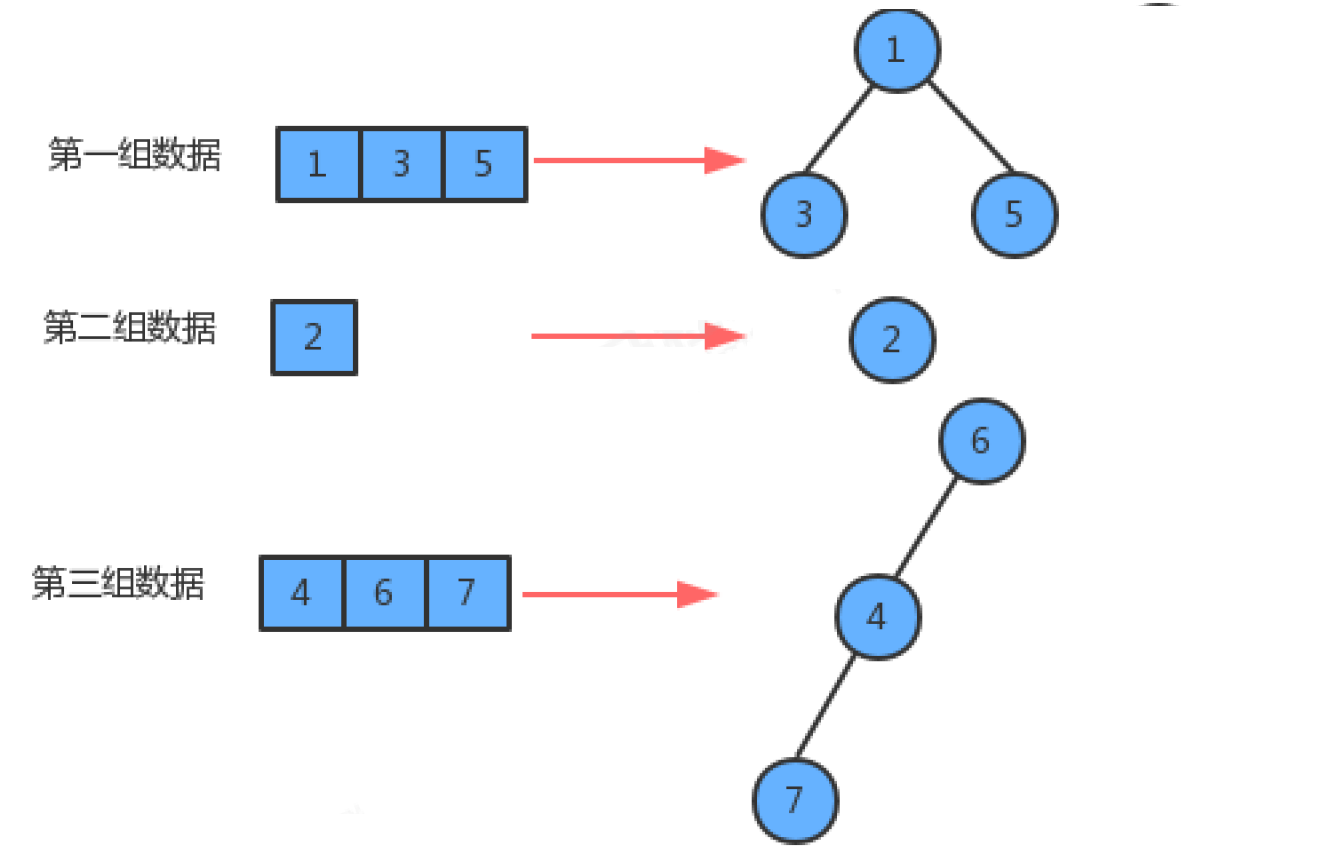
可以高效地进行如下操作:
- 查询元素 p 和元素 q 是否属于同一组
- 合并元素 p 和元素 q 所在的组
存储结构:
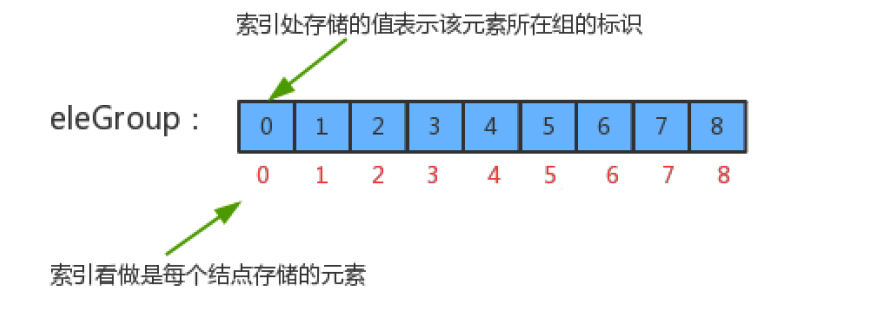
合并方式:

代码实现:
-
类实现:
public class UF { //记录节点元素和该元素所在分组的标识 private int[] eleAndGroup; //记录分组的个数 private int count; //初始化并查集 public UF(int N) { //初始化分组数量 this.count = N; //初始化eleAndGroup数量 this.eleAndGroup = new int[N]; //初始化eleAndGroup中的元素及其所在分组的标识符,eleAndGroup索引作为每个节点的元素 //每个索引处的值就是该组的索引,就是该元素所在的组的标识符 for (int i = 0; i < eleAndGroup.length; i++) { eleAndGroup[i] = i; } } //查询p所在的分组的标识符 public int find(int p) { return eleAndGroup[p]; } //判断并查集中元素p和元素q是否在同一分组中 public boolean connect(int p, int q) { return find(p) == find(q); } //把p元素所在分组和q元素所在分组合并 public void union(int p, int q) { //判断元素q和p是否已经在同一个分组中,如果已经在同一个分组中,则结束方法就可以了 if (connect(p, q)) { return; } int pGroup = find(p);//找到p所在分组的标识符 int qGroup = find(q);//找到q所在分组的标识符 //合并组,让p所在组的 所有元素 的组标识符变为q所在分组的标识符 for (int i = 0; i < eleAndGroup.length; i++) { if (eleAndGroup[i] == pGroup) { eleAndGroup[i] = qGroup; } } //分组个数-1 this.count--; } } -
测试代码:
public static void main(String[] args) { //创建并查集对象 UF uf = new UF(5); System.out.println(uf); //从控制台录入两个合并的元素,调用union方法合并,观察合并后并查集的分组 Scanner sc = new Scanner(System.in); while (true) { System.out.println("输入第一个要合并的元素"); int p = sc.nextInt(); System.out.println("输入第二个要合并的元素"); int q = sc.nextInt(); if (uf.connect(p, q)) { System.out.println(p + "元素已经和" + q + "元素已经在同一个组"); continue; } uf.union(p, q); System.out.println("当前并查集中还有:" + uf.count() + "个分组"); System.out.println(uf); System.out.println("********************"); } }
最坏情况下 union 算法的时间复杂度也是 O(N^2)
优化实现
让每个索引处的节点都指向它的父节点,当 eleGroup[i] = i 时,说明 i 是根节点
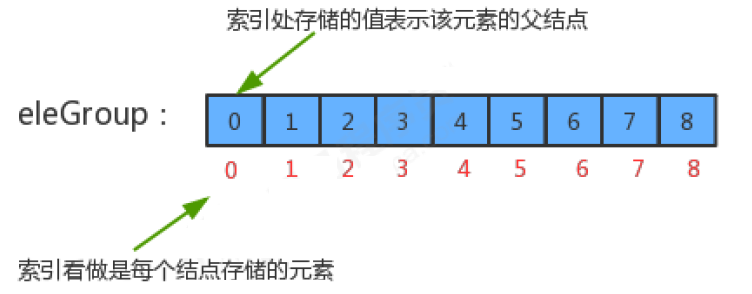
//查询p所在的分组的标识符,递归寻找父标识符,直到找到根节点
public int findRoot(int p) {
while (p != eleAndGroup[p]) {
p = eleAndGroup[p];
}
//p == eleGroup[p],说明p是根节点
return p;
}
//判断并查集中元素p和元素q是否在同一分组中
public boolean connect(int p, int q) {
return findRoot(p) == findRoot(q);
}
//把p元素所在分组和q元素所在分组合并
public void union(int p, int q) {
//找到p q对应的根节点
int pRoot = findRoot(p);
int qRoot = findRoot(q);
if (pRoot == qRoot) {
return;
}
//让p所在树的节点根节点为q的所在的根节点,只需要把根节点改一下,时间复杂度 O(1)
eleAndGroup[pRoot] = qRoot;
this.count-
}平均时间复杂度为 O(N),最坏时间复杂度是 O(N^2)
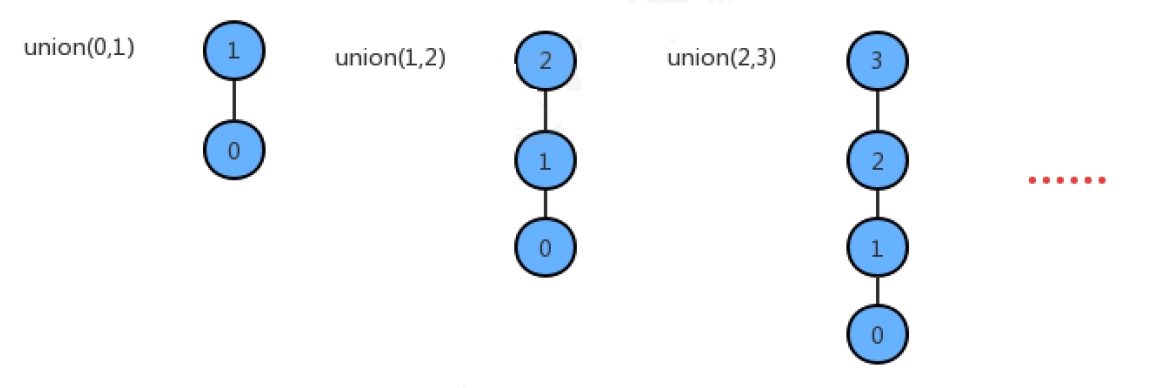
继续优化:路径压缩,保证每次把小树合并到大树
public class UF_Tree_Weighted {
private int[] eleAndGroup;
private int count;
private int[] size;//存储每一个根结点对应的树中的保存的节点的个数
//初始化并查集
public UF_Tree_Weighted(int N) {
this.count = N;
this.eleAndGroup = new int[N];
for (int i = 0; i < eleAndGroup.length; i++) {
eleAndGroup[i] = i;
}
this.size = new int[N];
//默认情况下,size中每个索引处的值都是1
for (int i = 0; i < size.length; i++) {
size[i] = 1;
}
}
//查询p所在的分组的标识符,父标识符
public int findRoot(int p) {
while (p != eleAndGroup[p]) {
p = eleAndGroup[p];
}
return p;
}
//判断并查集中元素p和元素q是否在同一分组中
public boolean connect(int p, int q) {
return findRoot(p) == findRoot(q);
}
//把p元素所在分组和q元素所在分组合并
public void union(int p, int q) {
//找到p q对应的根节点
int pRoot = findRoot(p);
int qRoot = findRoot(q);
if (pRoot == qRoot) {
return;
}
//判断pRoot对应的树大还是qRoot对应的树大,最终需要把较小的树合并到较大的树中
if (size[pRoot] < size[qRoot]) {
eleAndGroup[pRoot] = qRoot;
size[qRoot] += size[pRoot];
} else {
eleAndGroup[qRoot] = pRoot;
size[pRoot] += size[qRoot];
}
//组的数量-1、
this.count--;
}
}应用场景
并查集存储的每一个整数表示的是一个大型计算机网络中的计算机:
- 可以通过 connected(int p, int q) 来检测该网络中的某两台计算机之间是否连通
- 可以调用 union(int p,int q) 使得 p 和 q 之间连通,这样两台计算机之间就可以通信
畅通工程:某省调查城镇交通状况,得到现有城镇道路统计表,表中列出了每条道路直接连通的城镇。省政府畅通工程的目标是使全省任何两个城镇间都可以实现交通,但不一定有直接的道路相连,只要互相间接通过道路可达即可,问最少还需要建设多少条道路?
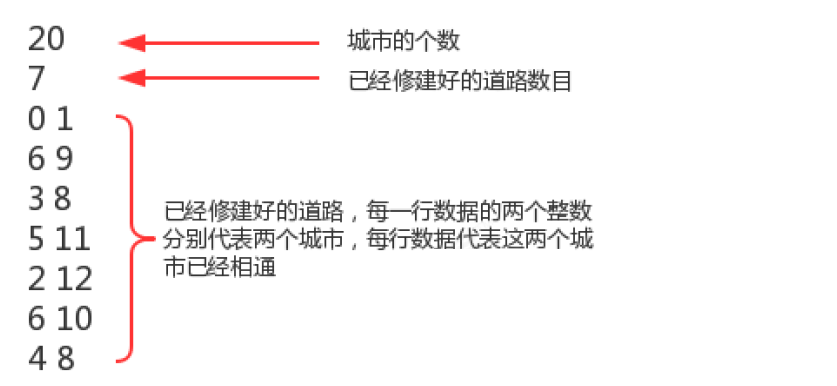
解题思路:
- 创建一个并查集 UF_Tree_Weighted(20)
- 分别调用 union(0,1)、union(6,9)、union(3,8)、union(5,11)、union(2,12)、union(6,10)、union(4,8),表示已经修建好的道路把对应的城市连接起来
- 如果城市全部连接起来,那么并查集中剩余的分组数目为 1,所有的城市都在一个树中,只需要获取当前并查集中剩余的数目减去 1,就是还需要修建的道路数目
public static void main(String[] args)throws Exception {
Scanner sc = new Scanner(System.in);
//读取城市数目,初始化并查集
int number = sc.nextInt();
//读取已经修建好的道路数目
int roadNumber = sc.nextInt();
UF_Tree_Weighted uf = new UF_Tree_Weighted(number);
//循环读取已经修建好的道路,并调用union方法
for (int i = 0; i < roadNumber; i++) {
int p = sc.nextInt();
int q = sc.nextInt();
uf.union(p,q);
}
//获取剩余的分组数量
int groupNumber = uf.count();
//计算出还需要修建的道路
System.out.println("还需要修建"+(groupNumber-1)+"道路,城市才能相通");
}参考视频:https://www.bilibili.com/video/BV1iJ411E7xW?p=142