SYSTEM
优化步骤
src/content/notes/system/优化步骤.md 优化步骤
执行频率
MySQL 客户端连接成功后,查询服务器状态信息:
SHOW [SESSION|GLOBAL] STATUS LIKE '';
-- SESSION: 显示当前会话连接的统计结果,默认参数
-- GLOBAL: 显示自数据库上次启动至今的统计结果-
查看 SQL 执行频率:
SHOW STATUS LIKE 'Com_____';Com_xxx 表示每种语句执行的次数

-
查询 SQL 语句影响的行数:
SHOW STATUS LIKE 'Innodb_rows_%';
Com_xxxx:这些参数对于所有存储引擎的表操作都会进行累计
Innodb_xxxx:这几个参数只是针对 InnoDB 存储引擎的,累加的算法也略有不同
| 参数 | 含义 |
|---|---|
| Com_select | 执行 SELECT 操作的次数,一次查询只累加 1 |
| Com_insert | 执行 INSERT 操作的次数,对于批量插入的 INSERT 操作,只累加一次 |
| Com_update | 执行 UPDATE 操作的次数 |
| Com_delete | 执行 DELETE 操作的次数 |
| Innodb_rows_read | 执行 SELECT 查询返回的行数 |
| Innodb_rows_inserted | 执行 INSERT 操作插入的行数 |
| Innodb_rows_updated | 执行 UPDATE 操作更新的行数 |
| Innodb_rows_deleted | 执行 DELETE 操作删除的行数 |
| Connections | 试图连接 MySQL 服务器的次数 |
| Uptime | 服务器工作时间 |
| Slow_queries | 慢查询的次数 |
定位低效
SQL 执行慢有两种情况:
- 偶尔慢:DB 在刷新脏页(学完事务就懂了)
- redo log 写满了
- 内存不够用,要从 LRU 链表中淘汰
- MySQL 认为系统空闲的时候
- MySQL 关闭时
- 一直慢的原因:索引没有设计好、SQL 语句没写好、MySQL 选错了索引
通过以下两种方式定位执行效率较低的 SQL 语句
-
慢日志查询: 慢查询日志在查询结束以后才记录,执行效率出现问题时查询日志并不能定位问题
配置文件修改:修改 .cnf 文件
vim /etc/mysql/my.cnf,重启 MySQL 服务器slow_query_log=ON slow_query_log_file=/usr/local/mysql/var/localhost-slow.log long_query_time=1 #记录超过long_query_time秒的SQL语句的日志 log-queries-not-using-indexes = 1使用命令配置:
mysql> SET slow_query_log=ON; mysql> SET GLOBAL slow_query_log=ON;查看是否配置成功:
SHOW VARIABLES LIKE '%query%' -
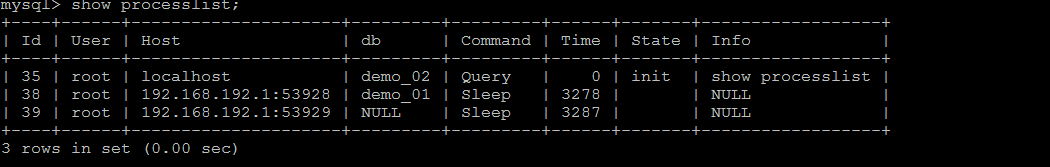
SHOW PROCESSLIST:实时查看当前 MySQL 在进行的连接线程,包括线程的状态、是否锁表、SQL 的执行情况,同时对一些锁表操作进行优化
EXPLAIN
执行计划
通过 EXPLAIN 命令获取执行 SQL 语句的信息,包括在 SELECT 语句执行过程中如何连接和连接的顺序,执行计划在优化器优化完成后、执行器之前生成,然后执行器会调用存储引擎检索数据
查询 SQL 语句的执行计划:
EXPLAIN SELECT * FROM table_1 WHERE id = 1;
| 字段 | 含义 |
|---|---|
| id | SELECT 的序列号 |
| select_type | 表示 SELECT 的类型 |
| table | 访问数据库中表名称,有时可能是简称或者临时表名称(<table_name>) |
| type | 表示表的连接类型 |
| possible_keys | 表示查询时,可能使用的索引 |
| key | 表示实际使用的索引 |
| key_len | 索引字段的长度 |
| ref | 表示与索引列进行等值匹配的对象,常数、某个列、函数等,type 必须在(range, const] 之间,左闭右开 |
| rows | 扫描出的行数,表示 MySQL 根据表统计信息及索引选用情况,估算的找到所需的记录扫描的行数 |
| filtered | 条件过滤的行百分比,单表查询没意义,用于连接查询中对驱动表的扇出进行过滤,查询优化器预测所有扇出值满足剩余查询条件的百分比,相乘以后表示多表查询中还要对被驱动执行查询的次数 |
| extra | 执行情况的说明和描述 |
MySQL 执行计划的局限:
- 只是计划,不是执行 SQL 语句,可以随着底层优化器输入的更改而更改
- EXPLAIN 不会告诉显示关于触发器、存储过程的信息对查询的影响情况, 不考虑各种 Cache
- EXPLAIN 不能显示 MySQL 在执行查询时的动态,因为执行计划在执行查询之前生成
- EXPALIN 只能解释 SELECT 操作,其他操作要重写为 SELECT 后查看执行计划
- EXPLAIN PLAN 显示的是在解释语句时数据库将如何运行 SQL 语句,由于执行环境和 EXPLAIN PLAN 环境的不同,此计划可能与 SQL 语句实际的执行计划不同,部分统计信息是估算的,并非精确值
SHOW WARINGS:在使用 EXPALIN 命令后执行该语句,可以查询与执行计划相关的拓展信息,展示出 Level、Code、Message 三个字段,当 Code 为 1003 时,Message 字段展示的信息类似于将查询语句重写后的信息,但是不是等价,不能执行复制过来运行
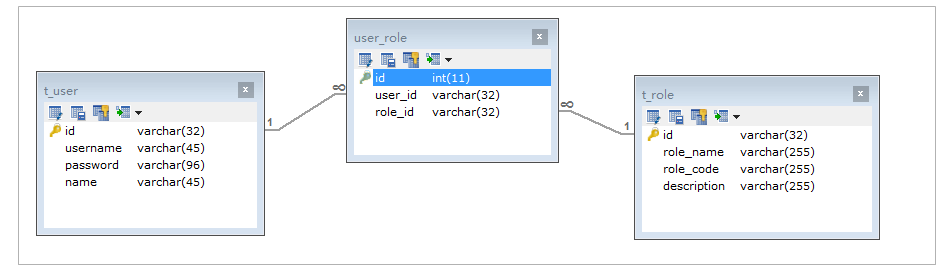
环境准备:
id
id 代表 SQL 执行的顺序的标识,每个 SELECT 关键字对应一个唯一 id,所以在同一个 SELECT 关键字中的表的 id 都是相同的。SELECT 后的 FROM 可以跟随多个表,每个表都会对应一条记录,这些记录的 id 都是相同的,
-
id 相同时,执行顺序由上至下。连接查询的执行计划,记录的 id 值都是相同的,出现在前面的表为驱动表,后面为被驱动表
EXPLAIN SELECT * FROM t_role r, t_user u, user_role ur WHERE r.id = ur.role_id AND u.id = ur.user_id ;
-
id 不同时,id 值越大优先级越高,越先被执行
EXPLAIN SELECT * FROM t_role WHERE id = (SELECT role_id FROM user_role WHERE user_id = (SELECT id FROM t_user WHERE username = 'stu1'))
-
id 有相同也有不同时,id 相同的可以认为是一组,从上往下顺序执行;在所有的组中,id 的值越大的组,优先级越高,越先执行
EXPLAIN SELECT * FROM t_role r , (SELECT * FROM user_role ur WHERE ur.`user_id` = '2') a WHERE r.id = a.role_id ;
-
id 为 NULL 时代表的是临时表
select
表示查询中每个 select 子句的类型(简单 OR 复杂)
| select_type | 含义 |
|---|---|
| SIMPLE | 简单的 SELECT 查询,查询中不包含子查询或者 UNION |
| PRIMARY | 查询中若包含任何复杂的子查询,最外层(也就是最左侧)查询标记为该标识 |
| UNION | 对于 UNION 或者 UNION ALL 的复杂查询,除了最左侧的查询,其余的小查询都是 UNION |
| UNION RESULT | UNION 需要使用临时表进行去重,临时表的是 UNION RESULT |
| DEPENDENT UNION | 对于 UNION 或者 UNION ALL 的复杂查询,如果各个小查询都依赖外层查询,是相关子查询,除了最左侧的小查询为 DEPENDENT SUBQUERY,其余都是 DEPENDENT UNION |
| SUBQUERY | 子查询不是相关子查询,该子查询第一个 SELECT 代表的查询就是这种类型,会进行物化(该子查询只需要执行一次) |
| DEPENDENT SUBQUERY | 子查询是相关子查询,该子查询第一个 SELECT 代表的查询就是这种类型,不会物化(该子查询需要执行多次) |
| DERIVED | 在 FROM 列表中包含的子查询,被标记为 DERIVED(衍生),也就是生成物化派生表的这个子查询 |
| MATERIALIZED | 将子查询物化后与与外层进行连接查询,生成物化表的子查询 |
子查询为 DERIVED:SELECT * FROM (SELECT key1 FROM t1) AS derived_1 WHERE key1 > 10
子查询为 MATERIALIZED:SELECT * FROM t1 WHERE key1 IN (SELECT key1 FROM t2)
type
对表的访问方式,表示 MySQL 在表中找到所需行的方式,又称访问类型
| type | 含义 |
|---|---|
| ALL | 全表扫描,如果是 InnoDB 引擎是扫描聚簇索引 |
| index | 可以使用覆盖索引,但需要扫描全部索引 |
| range | 索引范围扫描,常见于 between、<、> 等的查询 |
| index_subquery | 子查询可以普通索引,则子查询的 type 为 index_subquery |
| unique_subquery | 子查询可以使用主键或唯一二级索引,则子查询的 type 为 index_subquery |
| index_merge | 索引合并 |
| ref_or_null | 非唯一性索引(普通二级索引)并且可以存储 NULL,进行等值匹配 |
| ref | 非唯一性索引与常量等值匹配 |
| eq_ref | 唯一性索引(主键或不存储 NULL 的唯一二级索引)进行等值匹配,如果二级索引是联合索引,那么所有联合的列都要进行等值匹配 |
| const | 通过主键或者唯一二级索引与常量进行等值匹配 |
| system | system 是 const 类型的特例,当查询的表只有一条记录的情况下,使用 system |
| NULL | MySQL 在优化过程中分解语句,执行时甚至不用访问表或索引 |
从上到下,性能从差到好,一般来说需要保证查询至少达到 range 级别, 最好达到 ref
key
possible_keys:
- 指出 MySQL 能使用哪个索引在表中找到记录,查询涉及到的字段上若存在索引,则该索引将被列出,但不一定被查询使用
- 如果该列是 NULL,则没有相关的索引
key:
- 显示 MySQL 在查询中实际使用的索引,若没有使用索引,显示为 NULL
- 查询中若使用了覆盖索引,则该索引可能出现在 key 列表,不出现在 possible_keys
key_len:
- 表示索引中使用的字节数,可通过该列计算查询中使用的索引的长度
- key_len 显示的值为索引字段的最大可能长度,并非实际使用长度,即 key_len 是根据表定义计算而得,不是通过表内检索出的
- 在不损失精确性的前提下,长度越短越好
Extra
其他的额外的执行计划信息,在该列展示:
- No tables used:查询语句中使用 FROM dual 或者没有 FROM 语句
- Impossible WHERE:查询语句中的 WHERE 子句条件永远为 FALSE,会导致没有符合条件的行
- Using index:该值表示相应的 SELECT 操作中使用了覆盖索引(Covering Index)
- Using index condition:第一种情况是搜索条件中虽然出现了索引列,但是部分条件无法形成扫描区间(索引失效),会根据可用索引的条件先搜索一遍再匹配无法使用索引的条件,回表查询数据;第二种是使用了索引条件下推优化
- Using where:搜索的数据需要在 Server 层判断,无法使用索引下推
- Using join buffer:连接查询被驱动表无法利用索引,需要连接缓冲区来存储中间结果
- Using filesort:无法利用索引完成排序(优化方向),需要对数据使用外部排序算法,将取得的数据在内存或磁盘中进行排序
- Using temporary:表示 MySQL 需要使用临时表来存储结果集,常见于排序、去重(UNION)、分组等场景
- Select tables optimized away:说明仅通过使用索引,优化器可能仅从聚合函数结果中返回一行
- No tables used:Query 语句中使用 from dual 或不含任何 from 子句
参考文章:https://www.cnblogs.com/ggjucheng/archive/2012/11/11/2765237.html
PROFILES
SHOW PROFILES 能够在做 SQL 优化时分析当前会话中语句执行的资源消耗情况
-
通过 have_profiling 参数,能够看到当前 MySQL 是否支持 profile:

-
默认 profiling 是关闭的,可以通过 set 语句在 Session 级别开启 profiling:
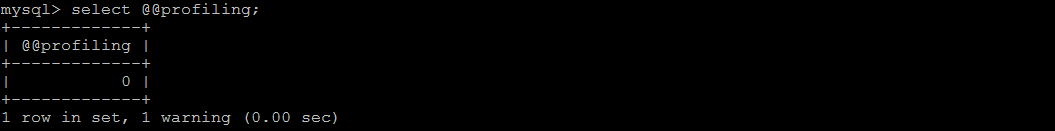
SET profiling=1; #开启profiling 开关; -
执行 SHOW PROFILES 指令, 来查看 SQL 语句执行的耗时:
SHOW PROFILES;
-
查看到该 SQL 执行过程中每个线程的状态和消耗的时间:
SHOW PROFILE FOR QUERY query_id;
-
在获取到最消耗时间的线程状态后,MySQL 支持选择 all、cpu、block io 、context switch、page faults 等类型查看 MySQL 在使用什么资源上耗费了过高的时间。例如,选择查看 CPU 的耗费时间:

- Status:SQL 语句执行的状态
- Durationsql:执行过程中每一个步骤的耗时
- CPU_user:当前用户占有的 CPU
- CPU_system:系统占有的 CPU
TRACE
MySQL 提供了对 SQL 的跟踪, 通过 trace 文件可以查看优化器生成执行计划的过程
-
打开 trace 功能,设置格式为 JSON,并设置 trace 的最大使用内存,避免解析过程中因默认内存过小而不能够完整展示
SET optimizer_trace="enabled=on",end_markers_in_json=ON; -- 会话内有效 SET optimizer_trace_max_mem_size=1000000; -
执行 SQL 语句:
SELECT * FROM tb_item WHERE id < 4; -
检查 information_schema.optimizer_trace:
SELECT * FROM information_schema.optimizer_trace \G; -- \G代表竖列展示执行信息主要有三个阶段:prepare 阶段、optimize 阶段(成本分析)、execute 阶段(执行)