SYSTEM
垃圾回收器与算法
src/content/notes/system/垃圾回收器.md 垃圾回收器
概述
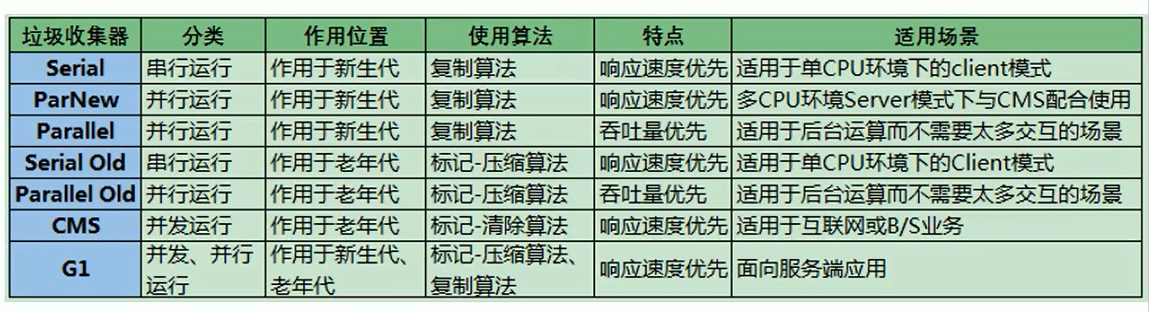
垃圾收集器分类:
- 按线程数分(垃圾回收线程数),可以分为串行垃圾回收器和并行垃圾回收器
- 除了 CMS 和 G1 之外,其它垃圾收集器都是以串行的方式执行
- 按照工作模式分,可以分为并发式垃圾回收器和独占式垃圾回收器
- 并发式垃圾回收器与应用程序线程交替工作,以尽可能减少应用程序的停顿时间
- 独占式垃圾回收器(Stop the world)一旦运行,就停止应用程序中的所有用户线程,直到垃圾回收过程完全结束
- 按碎片处理方式分,可分为压缩式垃圾回收器和非压缩式垃圾回收器
- 压缩式垃圾回收器在回收完成后进行压缩整理,消除回收后的碎片,再分配对象空间使用指针碰撞
- 非压缩式的垃圾回收器不进行这步操作,再分配对象空间使用空闲列表
- 按工作的内存区间分,又可分为年轻代垃圾回收器和老年代垃圾回收器
GC 性能指标:
- 吞吐量:程序的运行时间占总运行时间的比例(总运行时间 = 程序的运行时间 + 内存回收的时间)
- 垃圾收集开销:吞吐量的补数,垃圾收集所用时间与总运行时间的比例
- 暂停时间:执行垃圾收集时,程序的工作线程被暂停的时间
- 收集频率:相对于应用程序的执行,收集操作发生的频率
- 内存占用:Java 堆区所占的内存大小
- 快速:一个对象从诞生到被回收所经历的时间
垃圾收集器的组合关系:

新生代收集器:Serial、ParNew、Parallel Scavenge
老年代收集器:Serial old、Parallel old、CMS
整堆收集器:G1
- 红色虚线在 JDK9 移除、绿色虚线在 JDK14 弃用该组合、青色虚线在 JDK14 删除 CMS 垃圾回收器
查看默认的垃圾收回收器:
-
-XX:+PrintcommandLineFlags:查看命令行相关参数(包含使用的垃圾收集器) -
使用命令行指令:jinfo -flag 相关垃圾回收器参数 进程 ID
Serial
Serial:串行垃圾收集器,作用于新生代,是指使用单线程进行垃圾回收,采用复制算法,新生代基本都是复制算法
STW(Stop-The-World):垃圾回收时,只有一个线程在工作,并且 Java 应用中的所有线程都要暂停,等待垃圾回收的完成
Serial old:执行老年代垃圾回收的串行收集器,内存回收算法使用的是标记-整理算法,同样也采用了串行回收和 STW 机制
- Serial old 是 Client 模式下默认的老年代的垃圾回收器
- Serial old 在 Server 模式下主要有两个用途:
- 在 JDK 1.5 以及之前版本(Parallel Old 诞生以前)中与 Parallel Scavenge 收集器搭配使用
- 作为老年代 CMS 收集器的后备垃圾回收方案,在并发收集发生 Concurrent Mode Failure 时使用
开启参数:-XX:+UseSerialGC 等价于新生代用 Serial GC 且老年代用 Serial old GC
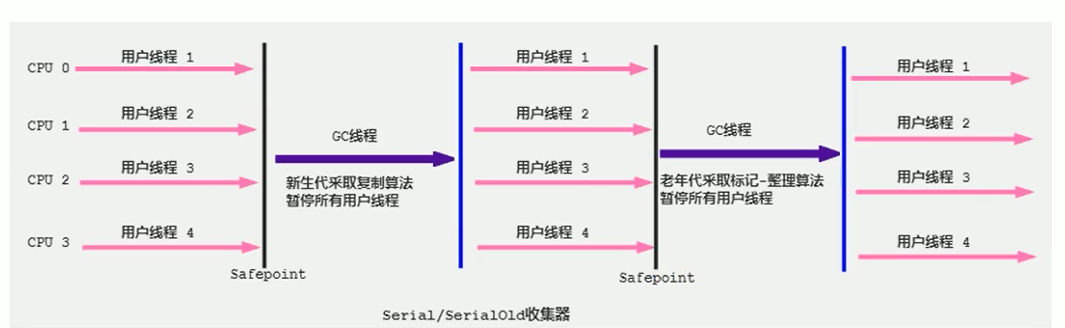
优点:简单而高效(与其他收集器的单线程比),对于限定单个 CPU 的环境来说,Serial 收集器由于没有线程交互的开销,可以获得最高的单线程收集效率
缺点:对于交互性较强的应用而言,这种垃圾收集器是不能够接受的,比如 JavaWeb 应用
ParNew
Par 是 Parallel 并行的缩写,New 是只能处理的是新生代
并行垃圾收集器在串行垃圾收集器的基础之上做了改进,采用复制算法,将单线程改为了多线程进行垃圾回收,可以缩短垃圾回收的时间
对于其他的行为(收集算法、stop the world、对象分配规则、回收策略等)同 Serial 收集器一样,应用在年轻代,除 Serial 外,只有ParNew GC 能与 CMS 收集器配合工作
相关参数:
-
-XX:+UseParNewGC:表示年轻代使用并行收集器,不影响老年代 -
-XX:ParallelGCThreads:默认开启和 CPU 数量相同的线程数
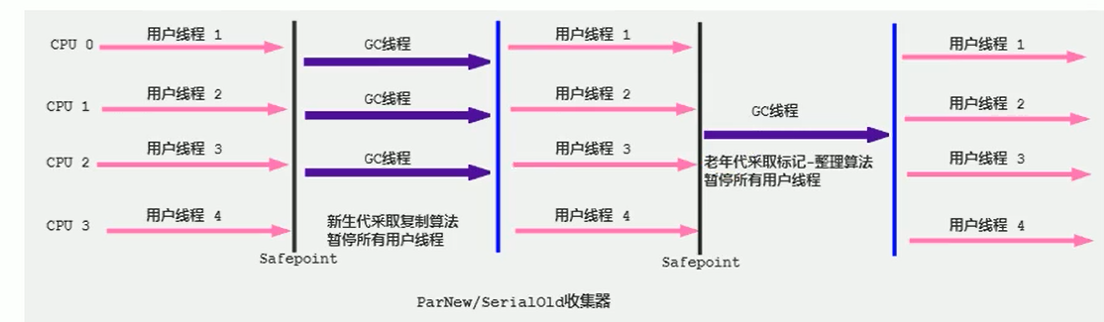
ParNew 是很多 JVM 运行在 Server 模式下新生代的默认垃圾收集器
- 对于新生代,回收次数频繁,使用并行方式高效
- 对于老年代,回收次数少,使用串行方式节省资源(CPU 并行需要切换线程,串行可以省去切换线程的资源)
Parallel
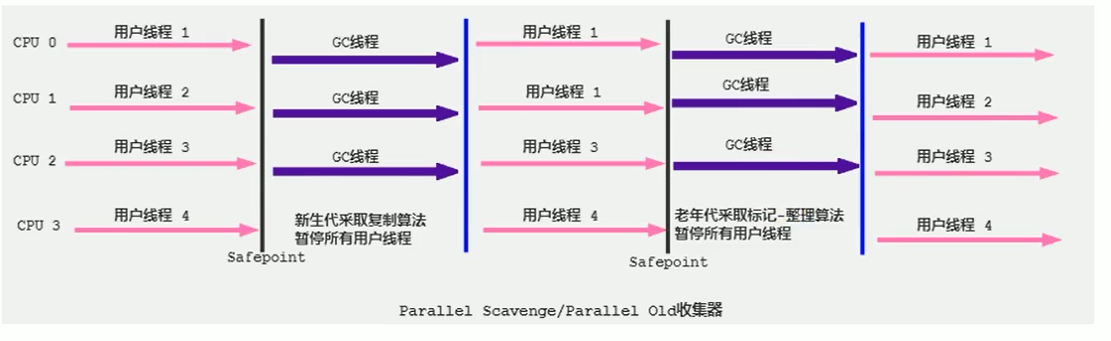
Parallel Scavenge 收集器是应用于新生代的并行垃圾回收器,采用复制算法、并行回收和 Stop the World 机制
Parallel Old 收集器:是一个应用于老年代的并行垃圾回收器,采用标记-整理算法
对比其他回收器:
- 其它收集器目标是尽可能缩短垃圾收集时用户线程的停顿时间
- Parallel 目标是达到一个可控制的吞吐量,被称为吞吐量优先收集器
- Parallel Scavenge 对比 ParNew 拥有自适应调节策略,可以通过一个开关参数打开 GC Ergonomics
应用场景:
- 停顿时间越短就越适合需要与用户交互的程序,良好的响应速度能提升用户体验
- 高吞吐量可以高效率地利用 CPU 时间,尽快完成程序的运算任务,适合在后台运算而不需要太多交互
停顿时间和吞吐量的关系:新生代空间变小 → 缩短停顿时间 → 垃圾回收变得频繁 → 导致吞吐量下降
在注重吞吐量及 CPU 资源敏感的场合,都可以优先考虑 Parallel Scavenge + Parallel Old 收集器,在 Server 模式下的内存回收性能很好,Java8 默认是此垃圾收集器组合
参数配置:
-XX:+UseParallelGC:手动指定年轻代使用 Paralle 并行收集器执行内存回收任务-XX:+UseParalleloldcc:手动指定老年代使用并行回收收集器执行内存回收任务- 上面两个参数,默认开启一个,另一个也会被开启(互相激活),默认 JDK8 是开启的
-XX:+UseAdaptivesizepplicy:设置 Parallel Scavenge 收集器具有自适应调节策略,在这种模式下,年轻代的大小、Eden 和 Survivor 的比例、晋升老年代的对象年龄等参数会被自动调整,虚拟机会根据当前系统的运行情况收集性能监控信息,动态调整这些参数以提供最合适的停顿时间或者最大的吞吐量-XX:ParallelGcrhreads:设置年轻代并行收集器的线程数,一般与 CPU 数量相等,以避免过多的线程数影响垃圾收集性能- 在默认情况下,当 CPU 数量小于 8 个,ParallelGcThreads 的值等于 CPU 数量
- 当 CPU 数量大于 8 个,ParallelGCThreads 的值等于 3+[5*CPU Count]/8]
-XX:MaxGCPauseMillis:设置垃圾收集器最大停顿时间(即 STW 的时间),单位是毫秒- 对于用户来讲,停顿时间越短体验越好;在服务器端,注重高并发,整体的吞吐量
- 为了把停顿时间控制在 MaxGCPauseMillis 以内,收集器在工作时会调整 Java 堆大小或其他一些参数
-XX:GCTimeRatio:垃圾收集时间占总时间的比例 =1/(N+1),用于衡量吞吐量的大小- 取值范围(0,100)。默认值 99,也就是垃圾回收时间不超过 1
- 与
-xx:MaxGCPauseMillis参数有一定矛盾性,暂停时间越长,Radio 参数就容易超过设定的比例
CMS
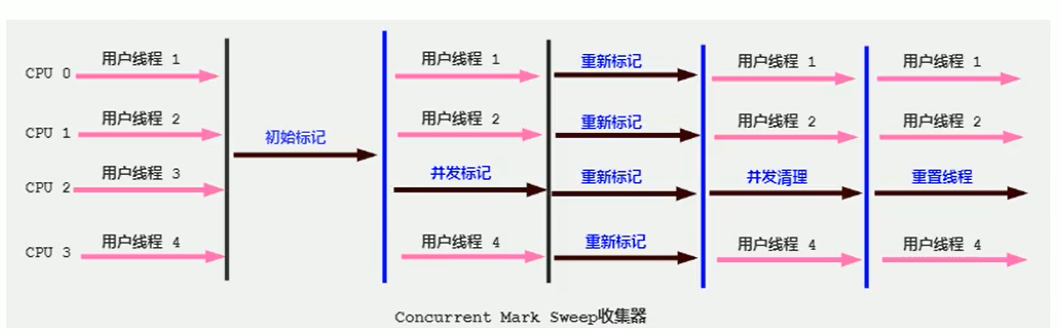
CMS 全称 Concurrent Mark Sweep,是一款并发的、使用标记-清除算法、针对老年代的垃圾回收器,其最大特点是让垃圾收集线程与用户线程同时工作
CMS 收集器的关注点是尽可能缩短垃圾收集时用户线程的停顿时间,停顿时间越短(低延迟)越适合与用户交互的程序,良好的响应速度能提升用户体验
分为以下四个流程:
- 初始标记:使用 STW 出现短暂停顿,仅标记一下 GC Roots 能直接关联到的对象,速度很快
- 并发标记:进行 GC Roots 开始遍历整个对象图,在整个回收过程中耗时最长,不需要 STW,可以与用户线程并发运行
- 重新标记:修正并发标记期间因用户程序继续运作而导致标记产生变动的那一部分对象,比初始标记时间长但远比并发标记时间短,需要 STW(不停顿就会一直变化,采用写屏障 + 增量更新来避免漏标情况)
- 并发清除:清除标记为可以回收对象,不需要移动存活对象,所以这个阶段可以与用户线程同时并发的
Mark Sweep 会造成内存碎片,不把算法换成 Mark Compact 的原因:Mark Compact 算法会整理内存,导致用户线程使用的对象的地址改变,影响用户线程继续执行
在整个过程中耗时最长的并发标记和并发清除过程中,收集器线程都可以与用户线程一起工作,不需要进行停顿
优点:并发收集、低延迟
缺点:
-
吞吐量降低:在并发阶段虽然不会导致用户停顿,但是会因为占用了一部分线程而导致应用程序变慢,CPU 利用率不够高
-
CMS 收集器无法处理浮动垃圾,可能出现 Concurrent Mode Failure 导致另一次 Full GC 的产生
浮动垃圾是指并发清除阶段由于用户线程继续运行而产生的垃圾(产生了新对象),这部分垃圾只能到下一次 GC 时才能进行回收。由于浮动垃圾的存在,CMS 收集需要预留出一部分内存,不能等待老年代快满的时候再回收。如果预留的内存不够存放浮动垃圾,就会出现 Concurrent Mode Failure,这时虚拟机将临时启用 Serial Old 来替代 CMS,导致很长的停顿时间
-
标记 - 清除算法导致的空间碎片,往往出现老年代空间无法找到足够大连续空间来分配当前对象,不得不提前触发一次 Full GC;为新对象分配内存空间时,将无法使用指针碰撞(Bump the Pointer)技术,而只能够选择空闲列表(Free List)执行内存分配
参数设置:
-
-XX:+UseConcMarkSweepGC:手动指定使用 CMS 收集器执行内存回收任务开启该参数后会自动将
-XX:+UseParNewGC打开,即:ParNew + CMS + Serial old的组合 -
-XX:CMSInitiatingoccupanyFraction:设置堆内存使用率的阈值,一旦达到该阈值,便开始进行回收- JDK5 及以前版本的默认值为 68,即当老年代的空间使用率达到 68% 时,会执行一次CMS回收
- JDK6 及以上版本默认值为 92%
-
-XX:+UseCMSCompactAtFullCollection:用于指定在执行完 Full GC 后对内存空间进行压缩整理,以此避免内存碎片的产生,由于内存压缩整理过程无法并发执行,所带来的问题就是停顿时间变得更长 -
-XX:CMSFullGCsBeforecompaction:设置在执行多少次 Full GC 后对内存空间进行压缩整理 -
-XX:ParallelCMSThreads:设置 CMS 的线程数量- CMS 默认启动的线程数是 (ParallelGCThreads+3)/4,ParallelGCThreads 是年轻代并行收集器的线程数
- 收集线程占用的 CPU 资源多于25%,对用户程序影响可能较大;当 CPU 资源比较紧张时,受到 CMS 收集器线程的影响,应用程序的性能在垃圾回收阶段可能会非常糟糕
G1
G1 特点
G1(Garbage-First)是一款面向服务端应用的垃圾收集器,应用于新生代和老年代、采用标记-整理算法、软实时、低延迟、可设定目标(最大 STW 停顿时间)的垃圾回收器,用于代替 CMS,适用于较大的堆(>4 ~ 6G),在 JDK9 之后默认使用 G1
G1 对比其他处理器的优点:
-
并发与并行:
- 并行性:G1 在回收期间,可以有多个 GC 线程同时工作,有效利用多核计算能力,此时用户线程 STW
- 并发性:G1 拥有与应用程序交替执行的能力,部分工作可以和应用程序同时执行,因此不会在整个回收阶段发生完全阻塞应用程序的情况
- 其他的垃圾收集器使用内置的 JVM 线程执行 GC 的多线程操作,而 G1 GC 可以采用应用线程承担后台运行的 GC 工作,JVM 的 GC 线程处理速度慢时,系统会调用应用程序线程加速垃圾回收过程
-
分区算法:
-
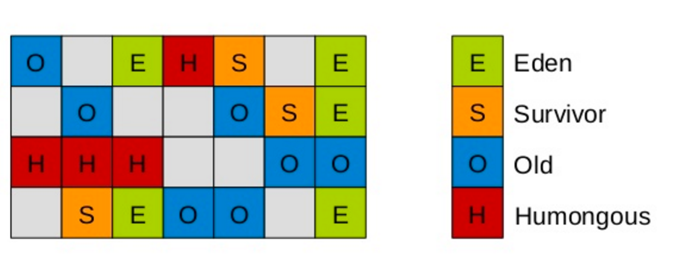
从分代上看,G1 属于分代型垃圾回收器,区分年轻代和老年代,年轻代依然有 Eden 区和 Survivor 区。从堆结构上看,新生代和老年代不再物理隔离,不用担心每个代内存是否足够,这种特性有利于程序长时间运行,分配大对象时不会因为无法找到连续内存空间而提前触发下一次 GC
-
将整个堆划分成约 2048 个大小相同的独立 Region 块,每个 Region 块大小根据堆空间的实际大小而定,整体被控制在 1MB 到 32 MB之间且为 2 的 N 次幂,所有 Region 大小相同,在 JVM 生命周期内不会被改变。G1 把堆划分成多个大小相等的独立区域,使得每个小空间可以单独进行垃圾回收
-
新的区域 Humongous:本身属于老年代区,当出现了一个巨型对象超出了分区容量的一半,该对象就会进入到该区域。如果一个 H 区装不下一个巨型对象,那么 G1 会寻找连续的 H 分区来存储,为了能找到连续的 H 区,有时候不得不启动 Full GC
-
G1 不会对巨型对象进行拷贝,回收时被优先考虑,G1 会跟踪老年代所有 incoming 引用,这样老年代 incoming 引用为 0 的巨型对象就可以在新生代垃圾回收时处理掉
-
Region 结构图:
-
-
空间整合:
- CMS:标记-清除算法、内存碎片、若干次 GC 后进行一次碎片整理
- G1:整体来看是基于标记 - 整理算法实现的收集器,从局部(Region 之间)上来看是基于复制算法实现的,两种算法都可以避免内存碎片
-
可预测的停顿时间模型(软实时 soft real-time):可以指定在 M 毫秒的时间片段内,消耗在 GC 上的时间不得超过 N 毫秒
- 由于分块的原因,G1 可以只选取部分区域进行内存回收,这样缩小了回收的范围,对于全局停顿情况也能得到较好的控制
- G1 跟踪各个 Region 里面的垃圾堆积的价值大小(回收所获得的空间大小以及回收所需时间,通过过去回收的经验获得),在后台维护一个优先列表,每次根据允许的收集时间优先回收价值最大的 Region,保证了 G1 收集器在有限的时间内可以获取尽可能高的收集效率
- 相比于 CMS GC,G1 未必能做到 CMS 在最好情况下的延时停顿,但是最差情况要好很多
G1 垃圾收集器的缺点:
- 相较于 CMS,G1 还不具备全方位、压倒性优势。比如在用户程序运行过程中,G1 无论是为了垃圾收集产生的内存占用还是程序运行时的额外执行负载都要比 CMS 要高
- 从经验上来说,在小内存应用上 CMS 的表现大概率会优于 G1,而 G1 在大内存应用上则发挥其优势,平衡点在 6-8GB 之间
应用场景:
- 面向服务端应用,针对具有大内存、多处理器的机器
- 需要低 GC 延迟,并具有大堆的应用程序提供解决方案
记忆集
记忆集 Remembered Set 在新生代中,每个 Region 都有一个 Remembered Set,用来被哪些其他 Region 里的对象引用(谁引用了我就记录谁)
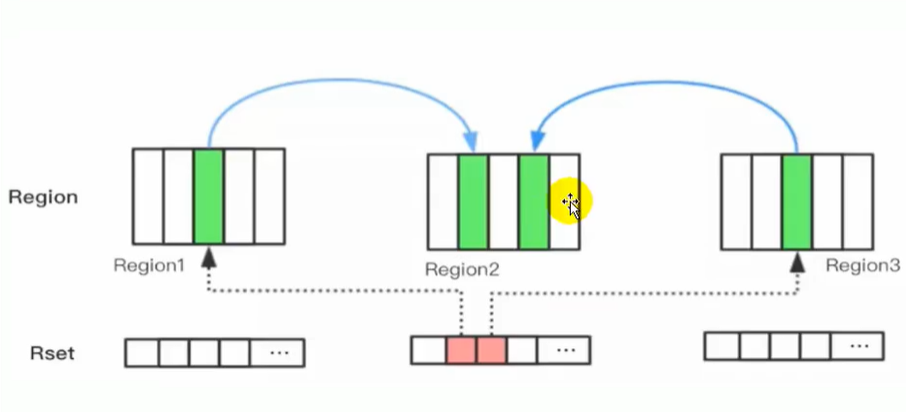
- 程序对 Reference 类型数据写操作时,产生一个 Write Barrier 暂时中断操作,检查该对象和 Reference 类型数据是否在不同的 Region(跨代引用),不同就将相关引用信息记录到 Reference 类型所属的 Region 的 Remembered Set 之中
- 进行内存回收时,在 GC 根节点的枚举范围中加入 Remembered Set 即可保证不对全堆扫描也不会有遗漏
垃圾收集器在新生代中建立了记忆集这样的数据结构,可以理解为它是一个抽象类,具体实现记忆集的三种方式:
- 字长精度
- 对象精度
- 卡精度(卡表)
卡表(Card Table)在老年代中,是一种对记忆集的具体实现,主要定义了记忆集的记录精度、与堆内存的映射关系等,卡表中的每一个元素都对应着一块特定大小的内存块,这个内存块称之为卡页(card page),当存在跨代引用时,会将卡页标记为 dirty,JVM 对于卡页的维护也是通过写屏障的方式
收集集合 CSet 代表每次 GC 暂停时回收的一系列目标分区,在任意一次收集暂停中,CSet 所有分区都会被释放,内部存活的对象都会被转移到分配的空闲分区中。年轻代收集 CSet 只容纳年轻代分区,而混合收集会通过启发式算法,在老年代候选回收分区中,筛选出回收收益最高的分区添加到 CSet 中
- CSet of Young Collection
- CSet of Mix Collection
工作原理
G1 中提供了三种垃圾回收模式:YoungGC、Mixed GC 和 Full GC,在不同的条件下被触发
- 当堆内存使用达到一定值(默认 45%)时,开始老年代并发标记过程
- 标记完成马上开始混合回收过程
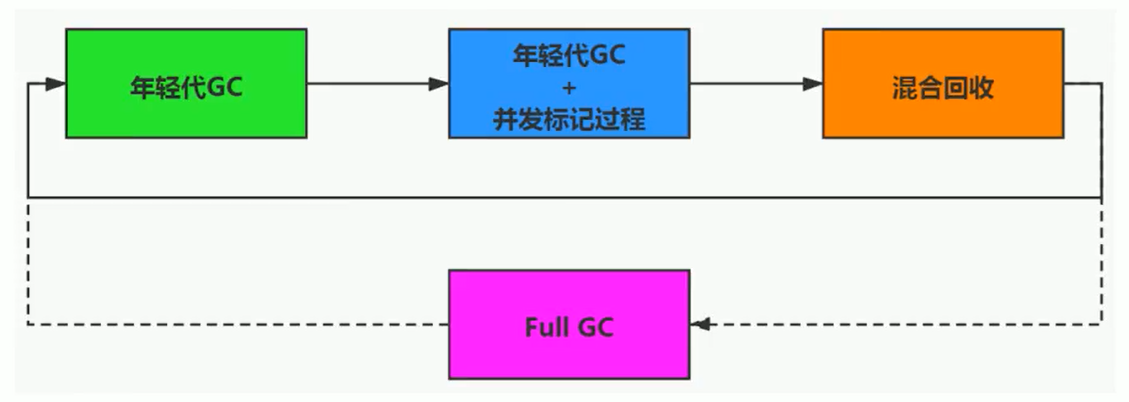
顺时针:Young GC → Young GC + Concurrent Mark → Mixed GC 顺序,进行垃圾回收
-
Young GC:发生在年轻代的 GC 算法,一般对象(除了巨型对象)都是在 eden region 中分配内存,当所有 eden region 被耗尽无法申请内存时,就会触发一次 Young GC,G1 停止应用程序的执行 STW,把活跃对象放入老年代,垃圾对象回收
回收过程:
- 扫描根:根引用连同 RSet 记录的外部引用作为扫描存活对象的入口
- 更新 RSet:处理 dirty card queue 更新 RS,此后 RSet 准确的反映对象的引用关系
- dirty card queue:类似缓存,产生了引用先记录在这里,然后更新到 RSet
- 作用:产生引用直接更新 RSet 需要线程同步开销很大,使用队列性能好
- 处理 RSet:识别被老年代对象指向的 Eden 中的对象,这些被指向的对象被认为是存活的对象,把需要回收的分区放入 Young CSet 中进行回收
- 复制对象:Eden 区内存段中存活的对象会被复制到 survivor 区,survivor 区内存段中存活的对象如果年龄未达阈值,年龄会加1,达到阀值会被会被复制到 old 区中空的内存分段,如果 survivor 空间不够,Eden 空间的部分数据会直接晋升到老年代空间
- 处理引用:处理 Soft,Weak,Phantom,JNI Weak 等引用,最终 Eden 空间的数据为空,GC 停止工作
-
**Concurrent Mark **:
- 初始标记:标记从根节点直接可达的对象,这个阶段是 STW 的,并且会触发一次年轻代 GC
- 并发标记 (Concurrent Marking):在整个堆中进行并发标记(应用程序并发执行),可能被 YoungGC 中断。会计算每个区域的对象活性,即区域中存活对象的比例,若区域中的所有对象都是垃圾,则这个区域会被立即回收(实时回收),给浮动垃圾准备出更多的空间,把需要收集的 Region 放入 CSet 当中
- 最终标记:为了修正在并发标记期间因用户程序继续运作而导致标记产生变动的那一部分标记记录,虚拟机将这段时间对象变化记录在线程的 Remembered Set Logs 里面,最终标记阶段需要把 Remembered Set Logs 的数据合并到 Remembered Set 中,这阶段需要停顿线程,但是可并行执行(防止漏标)
- 筛选回收:并发清理阶段,首先对 CSet 中各个 Region 中的回收价值和成本进行排序,根据用户所期望的 GC 停顿时间来制定回收计划,也需要 STW
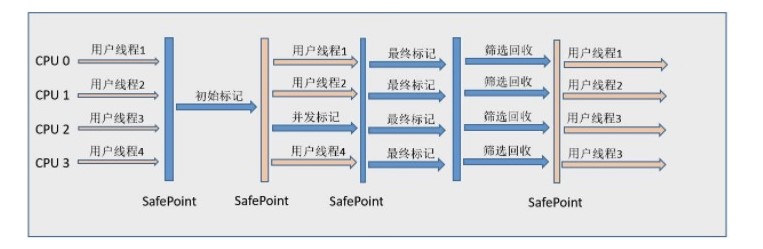
-
Mixed GC:当很多对象晋升到老年代时,为了避免堆内存被耗尽,虚拟机会触发一个混合的垃圾收集器,即 Mixed GC,除了回收整个 young region,还会回收一部分的 old region,过程同 YGC
注意:是一部分老年代,而不是全部老年代,可以选择哪些老年代 region 收集,对垃圾回收的时间进行控制
在 G1 中,Mixed GC 可以通过
-XX:InitiatingHeapOccupancyPercent设置阈值 -
Full GC:对象内存分配速度过快,Mixed GC 来不及回收,导致老年代被填满,就会触发一次 Full GC,G1 的 Full GC 算法就是单线程执行的垃圾回收,会导致异常长时间的暂停时间,需要进行不断的调优,尽可能的避免 Full GC
产生 Full GC 的原因:
- 晋升时没有足够的空间存放晋升的对象
- 并发处理过程完成之前空间耗尽,浮动垃圾
相关参数
-XX:+UseG1GC:手动指定使用 G1 垃圾收集器执行内存回收任务-XX:G1HeapRegionSize:设置每个 Region 的大小。值是 2 的幂,范围是 1MB 到 32MB 之间,目标是根据最小的 Java 堆大小划分出约 2048 个区域,默认是堆内存的 1/2000-XX:MaxGCPauseMillis:设置期望达到的最大 GC 停顿时间指标,JVM会尽力实现,但不保证达到,默认值是 200ms-XX:+ParallelGcThread:设置 STW 时 GC 线程数的值,最多设置为 8-XX:ConcGCThreads:设置并发标记线程数,设置为并行垃圾回收线程数 ParallelGcThreads 的1/4左右-XX:InitiatingHeapoccupancyPercent:设置触发并发 Mixed GC 周期的 Java 堆占用率阈值,超过此值,就触发 GC,默认值是 45-XX:+ClassUnloadingWithConcurrentMark:并发标记类卸载,默认启用,所有对象都经过并发标记后,就可以知道哪些类不再被使用,当一个类加载器的所有类都不再使用,则卸载它所加载的所有类-XX:G1NewSizePercent:新生代占用整个堆内存的最小百分比(默认5%)-XX:G1MaxNewSizePercent:新生代占用整个堆内存的最大百分比(默认60%)-XX:G1ReservePercent=10:保留内存区域,防止 to space(Survivor中的 to 区)溢出
调优
G1 的设计原则就是简化 JVM 性能调优,只需要简单的三步即可完成调优:
- 开启 G1 垃圾收集器
- 设置堆的最大内存
- 设置最大的停顿时间(STW)
不断调优暂停时间指标:
XX:MaxGCPauseMillis=x可以设置启动应用程序暂停的时间,G1会根据这个参数选择 CSet 来满足响应时间的设置- 设置到 100ms 或者 200ms 都可以(不同情况下会不一样),但设置成50ms就不太合理
- 暂停时间设置的太短,就会导致出现 G1 跟不上垃圾产生的速度,最终退化成 Full GC
- 对这个参数的调优是一个持续的过程,逐步调整到最佳状态
不要设置新生代和老年代的大小:
- 避免使用 -Xmn 或 -XX:NewRatio 等相关选项显式设置年轻代大小,G1 收集器在运行的时候会调整新生代和老年代的大小,从而达到我们为收集器设置的暂停时间目标
- 设置了新生代大小相当于放弃了 G1 的自动调优,我们只需要设置整个堆内存的大小,剩下的交给 G1 自己去分配各个代的大小
ZGC
ZGC 收集器是一个可伸缩的、低延迟的垃圾收集器,基于 Region 内存布局的,不设分代,使用了读屏障、染色指针和内存多重映射等技术来实现可并发的标记压缩算法
- 在 CMS 和 G1 中都用到了写屏障,而 ZGC 用到了读屏障
- 染色指针:直接将少量额外的信息存储在指针上的技术,从 64 位的指针中拿高 4 位来标识对象此时的状态
- 染色指针可以使某个 Region 的存活对象被移走之后,这个 Region 立即就能够被释放和重用
- 可以直接从指针中看到引用对象的三色标记状态(Marked0、Marked1)、是否进入了重分配集、是否被移动过(Remapped)、是否只能通过 finalize() 方法才能被访问到(Finalizable)
- 可以大幅减少在垃圾收集过程中内存屏障的使用数量,写屏障的目的通常是为了记录对象引用的变动情况,如果将这些信息直接维护在指针中,显然就可以省去一些专门的记录操作
- 可以作为一种可扩展的存储结构用来记录更多与对象标记、重定位过程相关的数据
- 内存多重映射:多个虚拟地址指向同一个物理地址
可并发的标记压缩算法:染色指针标识对象是否被标记或移动,读屏障保证在每次应用程序或 GC 程序访问对象时先根据染色指针的标识判断是否被移动,如果被移动就根据转发表访问新的移动对象,并更新引用,不会像 G1 一样必须等待垃圾回收完成才能访问
ZGC 目标:
- 停顿时间不会超过 10ms
- 停顿时间不会随着堆的增大而增大(不管多大的堆都能保持在 10ms 以下)
- 可支持几百 M,甚至几 T 的堆大小(最大支持4T)
ZGC 的工作过程可以分为 4 个阶段:
- 并发标记(Concurrent Mark): 遍历对象图做可达性分析的阶段,也要经过初始标记和最终标记,需要短暂停顿
- 并发预备重分配(Concurrent Prepare for Relocate):根据特定的查询条件统计得出本次收集过程要清理哪些 Region,将这些 Region 组成重分配集(Relocation Set)
- 并发重分配(Concurrent Relocate): 重分配是 ZGC 执行过程中的核心阶段,这个过程要把重分配集中的存活对象复制到新的 Region 上,并为重分配集中的每个 Region 维护一个转发表(Forward Table),记录从旧地址到新地址的转向关系
- 并发重映射(Concurrent Remap):修正整个堆中指向重分配集中旧对象的所有引用,ZGC 的并发映射并不是一个必须要立即完成的任务,ZGC 很巧妙地把并发重映射阶段要做的工作,合并到下一次垃圾收集循环中的并发标记阶段里去完成,因为都是要遍历所有对象,这样合并节省了一次遍历的开销
ZGC 几乎在所有地方并发执行的,除了初始标记的是 STW 的,但这部分的实际时间是非常少的,所以响应速度快,在尽可能对吞吐量影响不大的前提下,实现在任意堆内存大小下都可以把垃圾收集的停顿时间限制在十毫秒以内的低延迟
优点:高吞吐量、低延迟
缺点:浮动垃圾,当 ZGC 准备要对一个很大的堆做一次完整的并发收集,其全过程要持续十分钟以上,由于应用的对象分配速率很高,将创造大量的新对象产生浮动垃圾
参考文章:https://www.cnblogs.com/jimoer/p/13170249.html
总结
Serial GC、Parallel GC、Concurrent Mark Sweep GC 这三个 GC 不同:
- 最小化地使用内存和并行开销,选 Serial GC
- 最大化应用程序的吞吐量,选 Parallel GC
- 最小化 GC 的中断或停顿时间,选 CMS GC